
Definition
Eine statistische Analyse wertet Daten systematisch aus, um eine klar formulierte Frage zu beantworten. Dazu werden Beobachtungen oder Messwerte geprüft, geordnet und mit passenden statistischen Methoden untersucht. Erst die Verbindung aus Forschungsfrage, Datenbasis und Auswertungsverfahren macht aus einzelnen Zahlen einen nachvollziehbaren Befund.
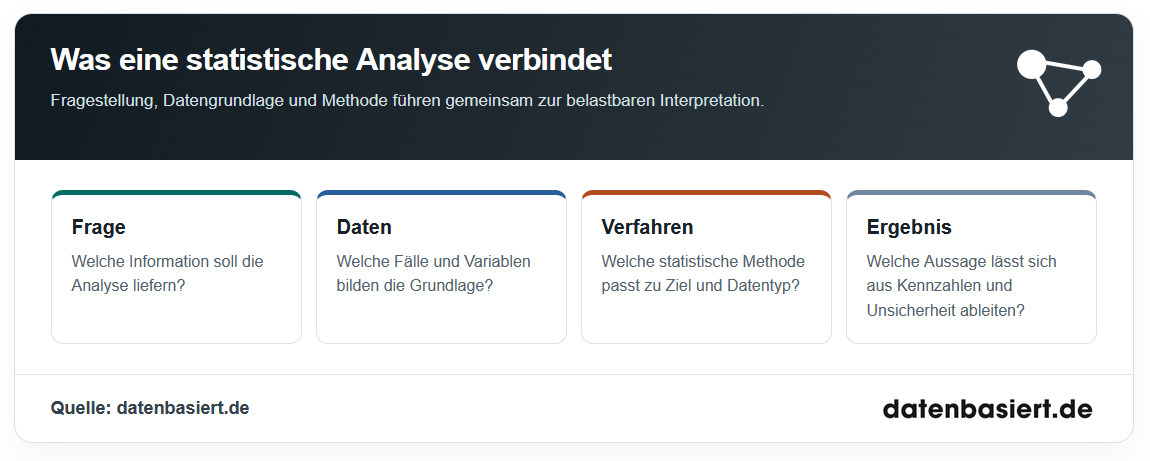
Der Ausdruck bezeichnet sowohl die Auswertung eines vorhandenen Datensatzes als auch das methodische Vorgehen einer statistischen Untersuchung. Im ersten Fall geht es etwa darum, eine Tabelle oder ein Diagramm zu lesen. Im zweiten Fall plant man zusätzlich, welche Personen oder Fälle zur Grundgesamtheit gehören, wie Variablen erhoben werden und ob eine Vollerhebung oder Stichprobe sinnvoll ist. Die empirische Forschung nutzt statistische Verfahren, wenn quantitative Messwerte oder codierte Kategorien systematisch beschrieben und geprüft werden sollen.
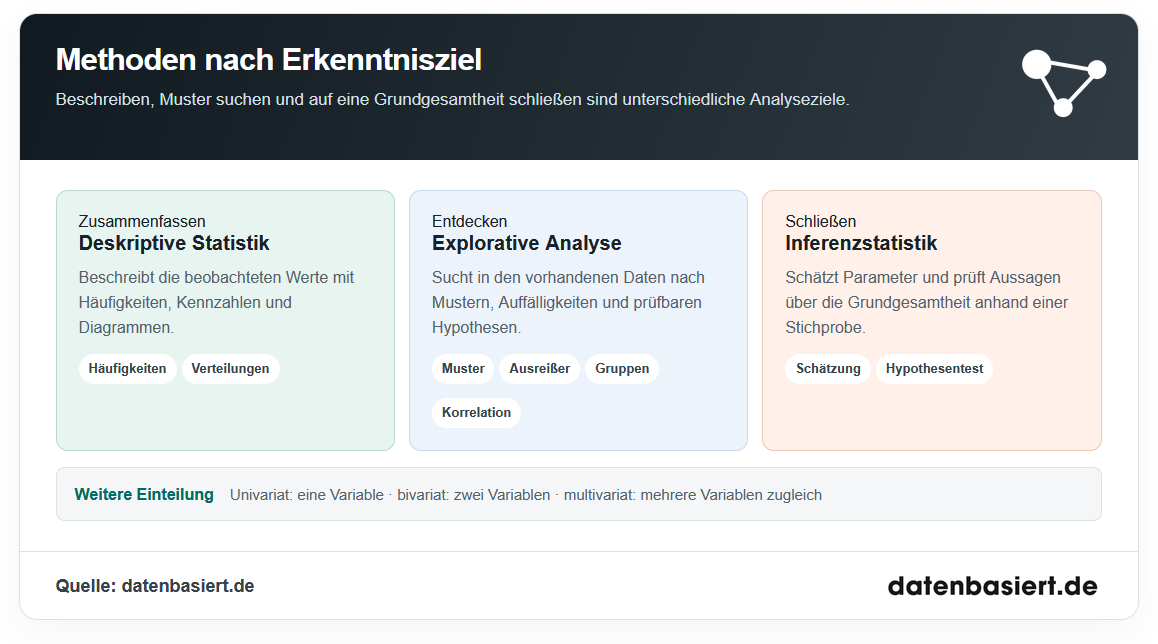
Eine deskriptive Analyse fasst zunächst die tatsächlich erfassten Daten zusammen. Eine inferenzstatistische Analyse geht weiter und schätzt anhand einer Stichprobe Eigenschaften der Grundgesamtheit. Ob diese Übertragung tragfähig ist, hängt nicht allein von der Fallzahl ab: Stichprobenauswahl, Messqualität, Datenaufbereitung und statistisches Modell beeinflussen die Aussagekraft gemeinsam.
Statistische Analyse Schritt für Schritt
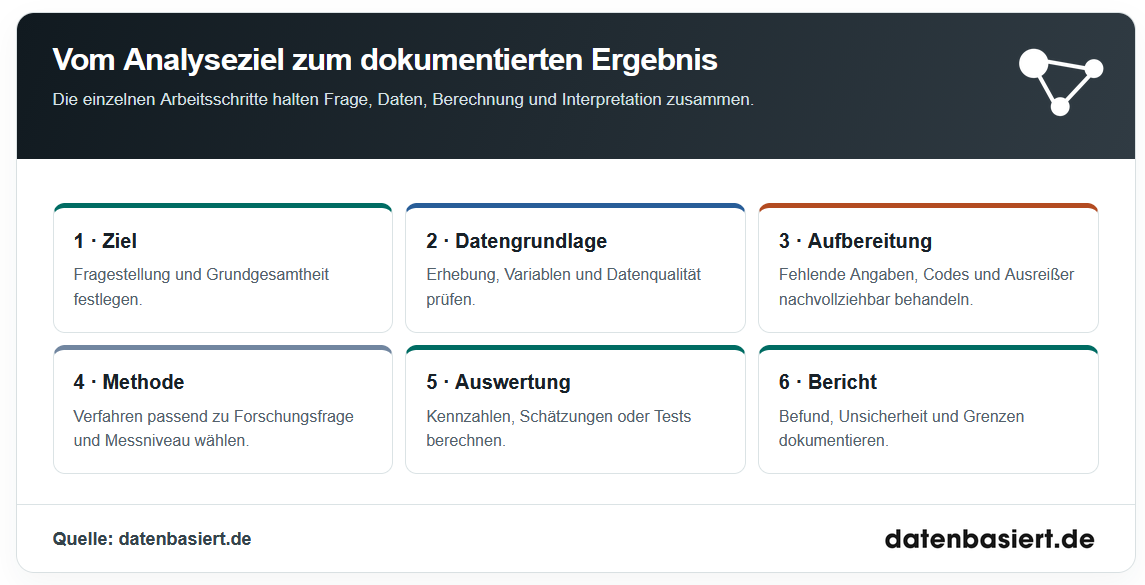
Fragestellung und Ziel festlegen
Eine gute Auswertung beginnt nicht mit der Auswahl eines Tests, sondern mit der Frage, die beantwortet werden soll. Geht es um die Verteilung eines Merkmals, um den Vergleich zweier Gruppen, um eine Veränderung über die Zeit oder um den Zusammenhang zwischen Variablen? Diese Entscheidung grenzt den Untersuchungsgegenstand ein und verhindert, dass eine statistische Analyse in eine Sammlung beliebiger Kennzahlen mündet.
Aus dem Ziel ergibt sich, welche Untersuchungseinheiten, Variablen, Zeiträume und Vergleichsgruppen wichtig sind. Bei einer erklärenden Fragestellung muss außerdem feststehen, welche Variable als Ergebnisgröße und welche als Einflussgröße betrachtet wird. Diese Festlegung allein beweist noch keine Ursache; sie macht aber die statistische Hypothese und das Forschungsdesign prüfbar.
Datenbasis und Erhebung prüfen
Als Nächstes wird geklärt, woher die Daten stammen und wie sie erhoben wurden. Bei Primärdaten wird die Erhebung für die aktuelle Forschungsfrage geplant. Sekundärdaten liegen bereits vor und können erneut ausgewertet werden, sofern Definitionen, Grundgesamtheit und Erhebungszeitraum zur neuen Fragestellung passen. Eine Umfrage, Beobachtung, Messung oder ein Experiment erzeugt jeweils eine andere Datenstruktur und kann andere Verzerrungen mit sich bringen.
Auch der zeitliche Aufbau ist entscheidend. Ein Querschnitt bildet Merkmale zu einem bestimmten Zeitpunkt ab; Längsschnittdaten enthalten wiederholte Messungen derselben Untersuchungseinheiten. Eine Zeitreihe ordnet Beobachtungen chronologisch. Bei all diesen Designs müssen Zeitstempel, Messintervalle und Veränderungen der Erhebungsmethode dokumentiert sein, damit ein beobachteter Trend nicht mit einem Wechsel der Datenerfassung verwechselt wird.
Zu jeder Variable gehören eine klare Definition, Maßeinheit und zulässige Werte. Das Skalenniveau zeigt, ob ein Merkmal nominal, ordinal oder metrisch ausgewertet wird. Kategorien, Rangfolgen und numerische Messwerte erlauben unterschiedliche statistische Operationen. Die Einordnung wird im Beitrag über Datenanalyse vertieft.
Daten aufbereiten
Bevor Kennzahlen berechnet werden, braucht der Datensatz eine systematische Qualitätsprüfung. Doppelte Fälle, fehlende Werte, ungültige Einträge und uneinheitliche Codierungen können Häufigkeiten, Mittelwerte und Testergebnisse verändern. Deshalb werden Datenbereinigung, Umcodierung und Ausschlüsse nicht beiläufig vorgenommen, sondern an der Forschungsfrage und den Erhebungsregeln ausgerichtet.
Besonders wichtig ist der Umgang mit fehlenden Daten. Ein leerer Eintrag kann eine nicht beantwortete Frage, einen technischen Ausfall oder eine nicht zutreffende Angabe bedeuten. Werden solche Fälle einfach entfernt, ändern sich womöglich Stichprobengröße und Zusammensetzung der analysierten Stichprobe. Eine Imputation schätzt fehlende Werte anhand eines festgelegten Verfahrens; sie braucht deshalb begründete Annahmen und eine transparente Dokumentation.
Auch Ausreißer sollten erst untersucht werden, bevor sie aus dem Datensatz entfernt werden. Ein Extremwert kann ein Eingabefehler sein, aber ebenso eine reale Beobachtung, die für die Verteilung relevant ist. Da Mittelwert und Varianz empfindlicher auf Extremwerte reagieren als Median und Interquartilsabstand, kann eine Entscheidung über den Umgang mit Ausreißern die statistische Schlussfolgerung beeinflussen.
Analyseverfahren auswählen
Die Methodenwahl richtet sich nach Fragestellung, Skalenniveau, Stichprobendesign und Verteilung der Messwerte. Für einen Gruppenvergleich ist beispielsweise relevant, ob die Gruppen unabhängig sind oder ob dieselben Personen wiederholt gemessen wurden. Bei einer Korrelation spielen die Eigenschaften beider Variablen eine Rolle; bei einer Regression kommen Modellannahmen und die Definition der Zielvariable hinzu.
Ein statistischer Test ist daher kein allgemeines Werkzeug, das unabhängig von Daten und Forschungsdesign eingesetzt werden kann. Vor der Berechnung sollte feststehen, welche Voraussetzungen gelten, welche Kennzahl berichtet wird und wie mit fehlenden Werten oder Mehrfachtests umgegangen wird. Eine nachträgliche Suche nach einem signifikanten p-Wert macht das Ergebnis nicht belastbarer.
Ergebnisse auswerten und dokumentieren
Nach der Berechnung werden Kennzahlen, Schätzungen, Teststatistiken oder Modellparameter auf die ursprüngliche Forschungsfrage bezogen. Ein p-Wert steht dabei nicht für sich allein: Effektgröße, Konfidenzintervall, Fallzahl und Analyseannahmen zeigen, wie groß ein beobachteter Unterschied ist und wie präzise er geschätzt wurde. Für eine nachvollziehbare Auswertung werden außerdem Datenausschlüsse, Codierungen, Softwareeinstellungen und statistische Verfahren festgehalten.
Erst danach folgt die inhaltliche Interpretation. Ein Befund beschreibt, was in den vorliegenden Daten beobachtet wurde; die Interpretation ordnet ihn in den fachlichen Zusammenhang ein. Eine gut dokumentierte statistische Datenanalyse macht sichtbar, wo die Zahlen enden und welche Schlussfolgerung durch das Forschungsdesign tatsächlich gestützt wird.
Methoden der statistischen Analyse
Deskriptive Statistik
Die deskriptive Statistik schafft zuerst einen Überblick über den untersuchten Datensatz. Häufigkeitstabellen zeigen, wie sich Fälle auf Kategorien verteilen; Lage- und Streuungsmaße verdichten numerische Variablen. Dazu kommen Tabellen und Diagramme, die Verteilungen, Unterschiede zwischen Gruppen und zeitliche Veränderungen sichtbar machen. Diese beschreibenden Kennzahlen gelten zunächst für die erhobenen Beobachtungen und dürfen nicht automatisch auf eine größere Grundgesamtheit übertragen werden.
Explorative Datenanalyse
Auf diese erste Beschreibung kann eine explorative Datenanalyse folgen. Sie untersucht, ob im Datensatz Muster, Ausreißer oder mögliche Zusammenhänge erkennbar sind, und unterstützt so die Entwicklung neuer Hypothesen. Grafische Datenanalyse, Kreuztabellen und gruppierte Kennzahlen helfen dabei, die Struktur der Beobachtungen zu verstehen, bevor ein bestimmtes statistisches Modell festgelegt wird.
Ein explorativer Zusammenhang ist jedoch zunächst ein Hinweis, den weitere Daten oder ein vorab geplantes Testverfahren prüfen müssen. Bei umfangreichen Datenbeständen kann Data Mining zusätzliche Muster auffinden; auch dabei beeinflussen Merkmalsauswahl, Datenqualität und Modellparameter, welche Strukturen sichtbar werden.
Inferenzstatistik
Die Inferenzstatistik nutzt Stichprobendaten, um Parameter der Grundgesamtheit zu schätzen und statistische Hypothesen zu prüfen. Eine Punktschätzung nennt den berechneten Wert, während ein Konfidenzintervall dessen statistische Unsicherheit unter den jeweiligen Modellannahmen einordnet. Ein Hypothesentest beurteilt, wie gut die beobachteten Daten mit einer Nullhypothese vereinbar sind. Der p-Wert ist dabei keine Wahrscheinlichkeit dafür, dass die Nullhypothese wahr oder falsch ist.
Statistische Signifikanz allein sagt außerdem nicht, ob ein Effekt praktisch wichtig ist. Bei einer sehr großen Stichprobe können kleine Unterschiede signifikant werden; bei einer kleinen Stichprobe kann ein relevanter Effekt unentdeckt bleiben. Deshalb gehören Effektgröße, Standardfehler, Konfidenzniveau und Teststärke zum Bericht. Werden viele Hypothesentests gleichzeitig durchgeführt, steigt zudem die Wahrscheinlichkeit zufälliger Treffer. Fehler erster und zweiter Art beschreiben dabei unterschiedliche Fehlentscheidungen im Testverfahren.
Univariate, bivariate und multivariate Analyse
Eine weitere Einteilung richtet sich danach, wie viele Variablen gemeinsam untersucht werden. Eine univariate Analyse beschreibt ein einzelnes Merkmal, eine bivariate Analyse betrachtet zwei Variablen im Verhältnis zueinander und eine multivariate Analyse bezieht mehrere Merkmale zugleich ein. Mit jeder zusätzlichen Variable verändert sich die statistische Fragestellung: Eine Kreuztabelle beschreibt gemeinsame Kategorien, ein Korrelationskoeffizient quantifiziert einen Zusammenhang und ein Regressionsmodell schätzt Beziehungen unter Einbezug weiterer Variablen.
Auch multivariate Statistik macht aus einem beobachteten Zusammenhang keinen Kausalnachweis. Drittvariablen, Auswahlverzerrungen und das Studiendesign müssen in die Interpretation einfließen. Die Unterscheidung zwischen Korrelation und Kausalität ist deshalb für statistische Analysen zentral.
| Fragestellung | Verfahren | Was ausgewertet wird |
|---|---|---|
| Ein Merkmal beschreiben | Häufigkeitsverteilung, Median, Streuungsmaß | Verteilung und typische Werte |
| Gruppen vergleichen | t-Test, Mann-Whitney-U-Test, Varianzanalyse | Unterschied, Effektgröße und Unsicherheit |
| Zusammenhänge untersuchen | Kreuztabelle, Korrelationsanalyse, Regression | Gemeinsame Veränderung statistischer Variablen |
| Entwicklung über Zeit auswerten | Zeitreihenanalyse | Trend, Schwankungen und zeitliche Muster |
Kennzahlen der statistischen Analyse
Häufigkeiten und Prozentwerte
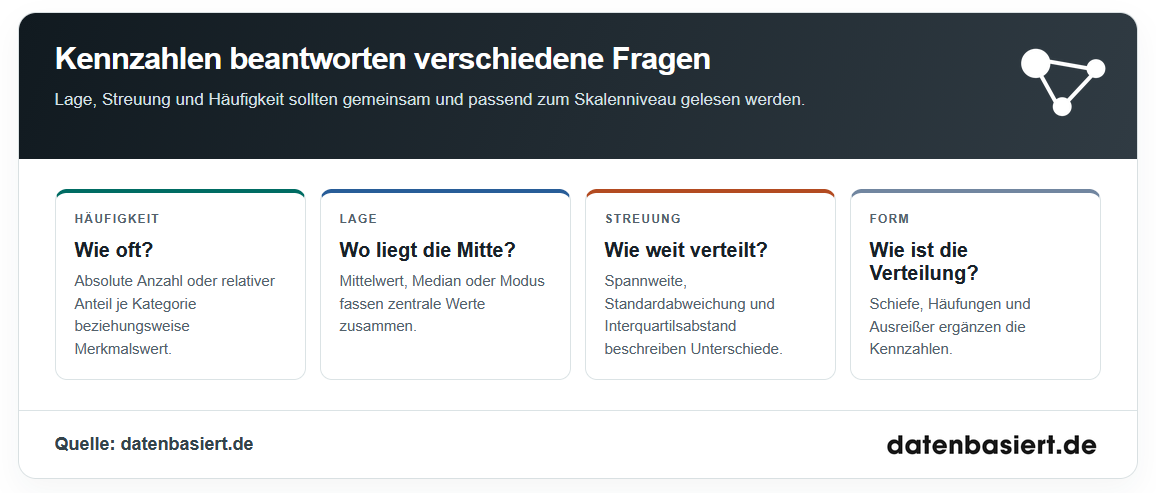
Bei kategorialen Variablen beginnt die Auswertung oft mit absoluten und relativen Häufigkeiten. Die absolute Häufigkeit zählt die Beobachtungen einer Kategorie; die relative Häufigkeit setzt diese Zahl ins Verhältnis zu allen gültigen Fällen. Prozentwerte sind dadurch leichter vergleichbar, bleiben aber nur aussagekräftig, wenn Bezugsgruppe und Fallzahl angegeben werden. Verändert sich die Zahl gültiger Antworten, kann ein Anteil steigen, obwohl sich die absolute Anzahl kaum verändert.
Bei Veränderungen zwischen Prozentwerten muss außerdem zwischen Prozent und Prozentpunkten unterschieden werden. Prozentpunkte bezeichnen die Differenz zwischen zwei Anteilen; eine relative prozentuale Veränderung setzt diese Differenz ins Verhältnis zum Ausgangswert. Die Bezugsgröße entscheidet also, welche Aussage eine Kennzahl ausdrückt.
Mittelwert, Median und Modus
Für numerische Daten beschreiben Mittelwert, Median und Modus unterschiedliche Aspekte der zentralen Lage. Der arithmetische Mittelwert bündelt alle Messwerte in einer einzigen Kennzahl, reagiert dadurch aber auf hohe oder niedrige Extremwerte. Der Median teilt die sortierten Beobachtungen in zwei Hälften und bleibt bei einer schiefen Verteilung oft stabiler. Der Modus ergänzt die Auswertung, wenn sich ein häufigster Zahlenwert oder eine besonders häufige Kategorie bestimmen lässt.
Die Wahl des Lageparameters hängt somit von Skalenniveau und Verteilungsform ab. Ein Mittelwert kann bei einer symmetrischen Verteilung passend sein; bei starker Schiefe beschreiben Median und Quartile die typische Lage häufig besser. Werden nominale Kategorien numerisch codiert, entstehen dadurch keine sinnvollen Mittelwerte: Die Codes repräsentieren Kategorien, keine messbaren Abstände.
Streuung und Ausreißer
Ein Lagewert allein beschreibt eine Datenverteilung nicht ausreichend. Zwei Gruppen können denselben Median haben und sich dennoch stark darin unterscheiden, wie weit ihre Einzelwerte auseinanderliegen. Die Spannweite betrachtet den Abstand zwischen Minimum und Maximum; Varianz und Standardabweichung fassen Abweichungen vom Mittelwert zusammen. Der Interquartilsabstand beschreibt die Breite der mittleren Hälfte der sortierten Messwerte und wird weniger von Extremwerten beeinflusst.
Deshalb sollten Lage und Streuung gemeinsam betrachtet werden. Ein Boxplot zeigt Median, Quartile und auffällige Werte kompakt; Histogramm und Dichtekurve machen Form und Häufungen der Verteilung sichtbar. Schiefe, Ausreißer und mehrere Gipfel können erklären, warum Mittelwert, Median und Standardabweichung verschiedene Eindrücke vermitteln.
Verteilungen
Die Häufigkeitsverteilung zeigt, wie sich Beobachtungen über Merkmalswerte oder Kategorien verteilen. Bei numerischen Variablen helfen Klassenbildung, Histogramm und Quantile, die Datenform zu erfassen. Quartile teilen sortierte Werte in vier Abschnitte; weitere Quantile können Lage und Streuung genauer beschreiben. Eine annähernd symmetrische Normalverteilung erlaubt andere Zusammenfassungen und Modellannahmen als eine stark schiefe oder mehrgipflige Verteilung.
Statistiken und Diagramme analysieren
Quelle, Zeitraum und Einheit erfassen
Bei einer veröffentlichten Statistik beginnt die Analyse mit den Rahmenangaben: Titel, Herausgeber, Quelle und Veröffentlichungsdatum sagen, woher die Werte kommen und auf welchen Zeitraum sie sich beziehen. Danach wird geprüft, welche Grundgesamtheit oder Stichprobe dargestellt wird, welche räumliche Einheit gilt und ob absolute Zahlen, relative Anteile oder Indexwerte verwendet werden. Erst mit dieser Datenbasis lässt sich einschätzen, welche Vergleiche überhaupt möglich sind.
Zusätzlich sollte die Darstellungsform benannt werden. Ein Balkendiagramm ordnet Kategorien, ein Liniendiagramm zeigt häufig eine zeitliche Entwicklung und eine Tabelle kann mehrere Kennzahlen nebeneinanderstellen. Legende, Achsenbeschriftung, Skala, Maßeinheit und Bezugsgröße gehören zur statistischen Information selbst: Ohne sie bleiben Zahlen leicht missverständlich.
Werte und Entwicklungen beschreiben
Die Beschreibung hält zunächst fest, was in Diagramm oder Tabelle zu sehen ist, ohne bereits eine Ursache zu behaupten. Dazu gehören Höchst- und Tiefstwerte, Gruppenunterschiede, Wendepunkte, Schwankungen und der Gesamttrend. Eine Zeitreihe kann über den gesamten Zeitraum steigen, während einzelne Abschnitte Rückgänge zeigen; deshalb sollten relevante Werte und Zeitabschnitte zusammen betrachtet werden.
Vergleiche brauchen eine gemeinsame Basis. Werden Jahre, Regionen oder Gruppen gegenübergestellt, müssen Definitionen und Erhebungsbedingungen hinreichend ähnlich sein. Bei absoluten Zahlen zählt die Größe der jeweiligen Bezugsgruppe; bei relativen Werten ist der Nenner entscheidend. So wird die Beschreibung präzise, bevor die statistische Interpretation beginnt.
Prozent und Prozentpunkte unterscheiden
Die Begriffe Prozent und Prozentpunkte beschreiben unterschiedliche Veränderungen. Ein Prozentpunkt ist die arithmetische Differenz zwischen zwei Prozentanteilen. Eine prozentuale Veränderung bezieht die Differenz auf den Ausgangswert. In einer statistischen Analyse sollte daher klar benannt werden, ob ein Anteil in Prozentpunkten gestiegen ist oder sich relativ um einen bestimmten Prozentsatz verändert hat.
Zahlen im Kontext interpretieren
Erst nach der sachlichen Beschreibung wird gefragt, wie sich ein Befund inhaltlich erklären lässt. Dazu werden Erhebungszeitraum, Datenquelle, Messdefinition und mögliche äußere Einflüsse berücksichtigt. Ein zeitlicher Gleichlauf oder eine Korrelation kann Anlass für eine Erklärung sein, belegt aber keine Ursache-Wirkungs-Beziehung. Kontextwissen hilft, eine plausible Deutung zu entwickeln; statistische Evidenz und Forschungsdesign entscheiden, wie weit diese Deutung gehen darf.
Aussagekraft statistischer Ergebnisse
Stichprobe und Erhebungsmethode
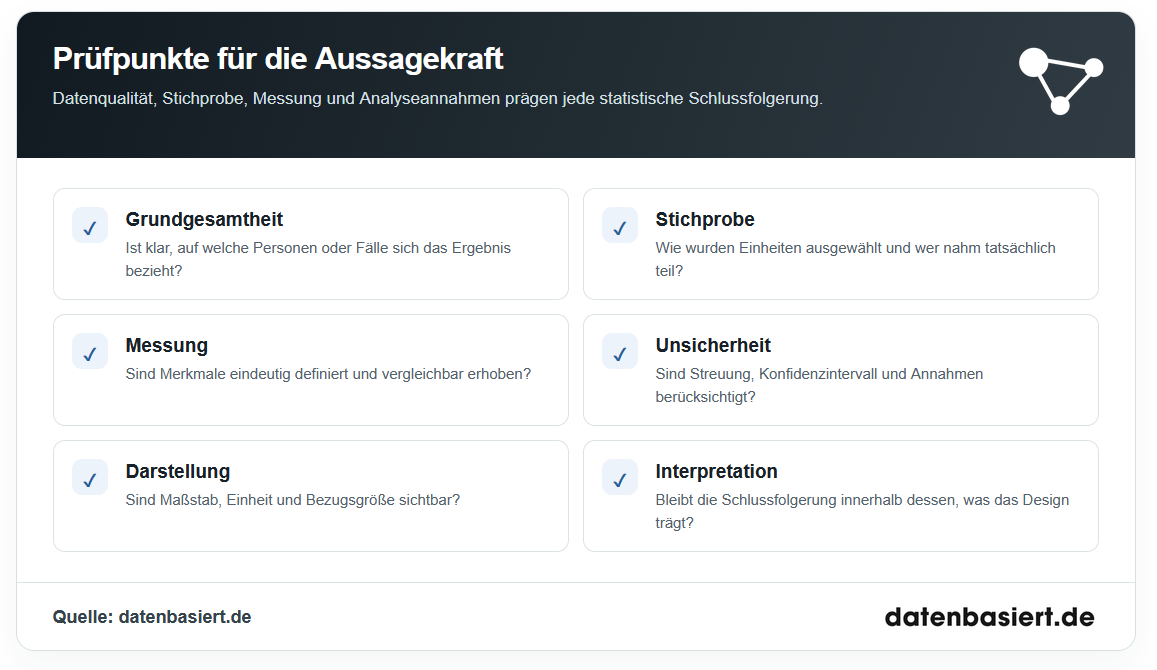
Eine große Fallzahl reduziert nicht automatisch alle Verzerrungen. Für die Aussagekraft zählt ebenso, wie die Stichprobe gezogen wurde, welche Personen teilnehmen konnten und wer nicht geantwortet hat. Eine Zufallsauswahl kann die Übertragung auf eine Grundgesamtheit stützen, wenn Auswahlrahmen und Teilnahmeprozess dazu passen. Selbstselektion, Nonresponse und Ausschlüsse können dagegen dazu führen, dass bestimmte Gruppen über- oder unterrepräsentiert sind.
Auch das Erhebungsinstrument prägt die Messwerte. Frageformulierung, Antwortskala, Interviewtechnik und Messgerät können systematische Messfehler verursachen. Werden Definitionen während der Erhebung verändert, sind Messwerte über mehrere Zeiträume möglicherweise nicht vergleichbar. Die statistische Analyse muss diese Bedingungen berücksichtigen, statt Unterschiede allein aus den Zahlen abzuleiten.
Repräsentativität und Verzerrungen
Repräsentativität bezieht sich immer auf eine bestimmte Grundgesamtheit und eine konkrete Fragestellung. Es genügt nicht, dass eine Stichprobe groß oder demografisch ausgewogen erscheint. Auswahlverzerrung, Antwortausfälle, Erinnerungsfehler und soziale Erwünschtheit können Ergebnisse beeinflussen, auch wenn viele Fälle vorliegen. Gewichtung gleicht bekannte Abweichungen zwischen Stichprobe und Grundgesamtheit aus, beseitigt aber nicht automatisch unbekannte Verzerrungen.
Die Qualität eines Messverfahrens lässt sich zusätzlich über Objektivität, Reliabilität und Validität beurteilen. Objektivität betrifft, ob Durchführung und Auswertung unabhängig von der untersuchenden Person zu denselben Ergebnissen führen. Reliabilität beschreibt die Zuverlässigkeit der Messung; Validität fragt, ob tatsächlich das vorgesehene Merkmal erfasst wird. Eine Messung kann zuverlässig sein und trotzdem am Untersuchungsziel vorbeigehen.
Achsen und Bezugsgrößen prüfen
Eine grafische Darstellung kann Unterschiede optisch verstärken oder abschwächen. Ein verkürzter Achsenbeginn verändert den sichtbaren Größenvergleich; ungleich lange Zeiträume oder wechselnde Einheiten können Trends verzerren. Auch Prozentangaben ohne Fallzahl, wechselnde Nenner und unterschiedliche Definitionen erschweren den Vergleich. Deshalb gehören Achsenskalierung, Beschriftung, Datenbasis und Bezugsgröße zur kritischen Prüfung einer Statistik.
Grenzen der Schlussfolgerungen
Jede statistische Schlussfolgerung gilt unter bestimmten Daten- und Modellannahmen. Ein Konfidenzintervall beschreibt die Präzision einer Schätzung, aber nicht sämtliche systematischen Fehler der Datenerhebung. Ein signifikanter Test beseitigt weder Confounding noch Auswahlverzerrung; eine nicht signifikante Differenz beweist nicht, dass zwei Gruppen identisch sind. Kausale Aussagen benötigen ein dafür geeignetes Forschungsdesign und eine begründete Kontrolle relevanter Einflussgrößen.
Darum sollte ein Ergebnisbericht zwischen Beschreibung, Schätzung und Interpretation unterscheiden. Er benennt, welche Population untersucht wurde, welche statistischen Verfahren zum Einsatz kamen und wie groß die verbleibende Unsicherheit ist. So lässt sich beurteilen, ob eine Aussage belastbar, eingeschränkt übertragbar oder mit den vorliegenden Daten nicht zu beantworten ist.
Beispiel
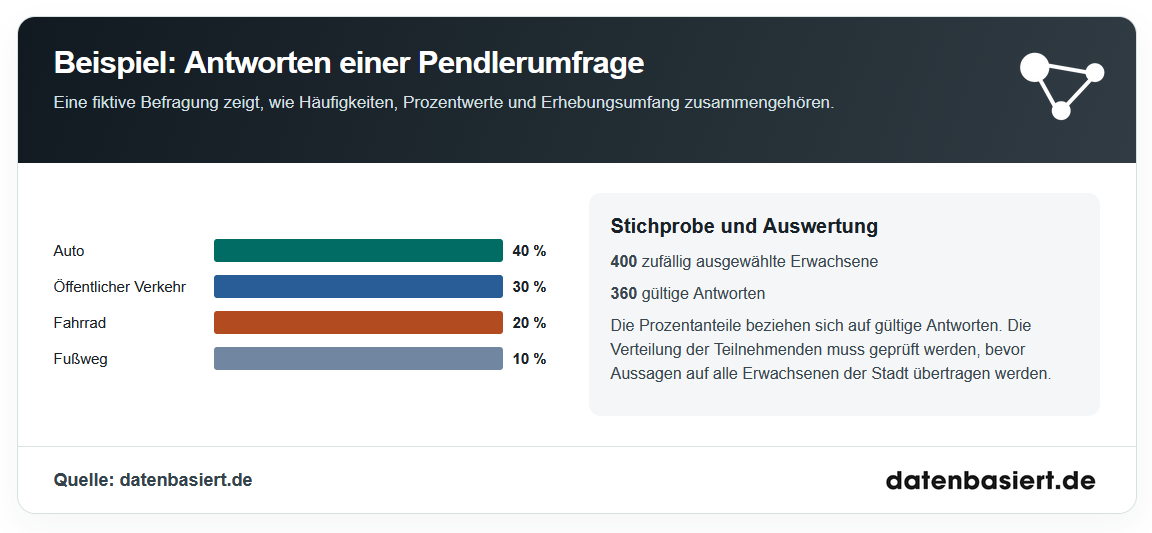
Eine fiktive Stadt möchte wissen, mit welchem Verkehrsmittel Erwachsene gewöhnlich zur Arbeit fahren. Dafür werden 400 Personen zufällig ausgewählt; 360 geben eine gültige Antwort. Die Variable „Hauptverkehrsmittel“ ist kategorial und nominalskaliert. Noch bevor Anteile berechnet werden, wird geprüft, ob die Antwortoptionen vollständig sind, Mehrfachnennungen ausgeschlossen wurden und alle Antworten dieselbe Frage abbilden.
Die Häufigkeitstabelle enthält 144 Antworten für das Auto, 108 für den öffentlichen Verkehr, 72 für das Fahrrad und 36 für den Fußweg. Bezogen auf 360 gültige Antworten ergeben sich relative Häufigkeiten von 40, 30, 20 und 10 Prozent. Für diese nominale Variable sind absolute Häufigkeiten, Prozentanteile und der Modus geeignete Kennzahlen. Ein Mittelwert aus Zahlencodes für die vier Verkehrsmittel wäre dagegen statistisch nicht interpretierbar, weil die Codes keine Rangfolge und keine messbaren Abstände ausdrücken.
Die Ergebnisse beschreiben zunächst die gültigen Antworten. Eine Übertragung auf alle Erwachsenen setzt voraus, dass Auswahlverfahren, Teilnahmequote und Zusammensetzung der Befragten dafür sprechen. Die 40 Personen ohne gültige Antwort werden deshalb nicht aus dem Bericht ausgeblendet: Unterscheiden sie sich systematisch von den Teilnehmenden, kann Nonresponse die Häufigkeitsverteilung verändern.
Ein Balkendiagramm macht die vier Kategorien und ihre relativen Häufigkeiten sichtbar. Im Bericht stehen zugleich Stichprobengröße, Erhebungszeitraum und Bezugsgruppe. Damit werden Statistik, grafische Darstellung und Datenbasis gemeinsam lesbar, ohne aus einer deskriptiven Umfrageauswertung eine kausale Erklärung für die Verkehrsmittelwahl abzuleiten.
Statistische Ergebnisse darstellen
Tabellen und Diagramme auswählen
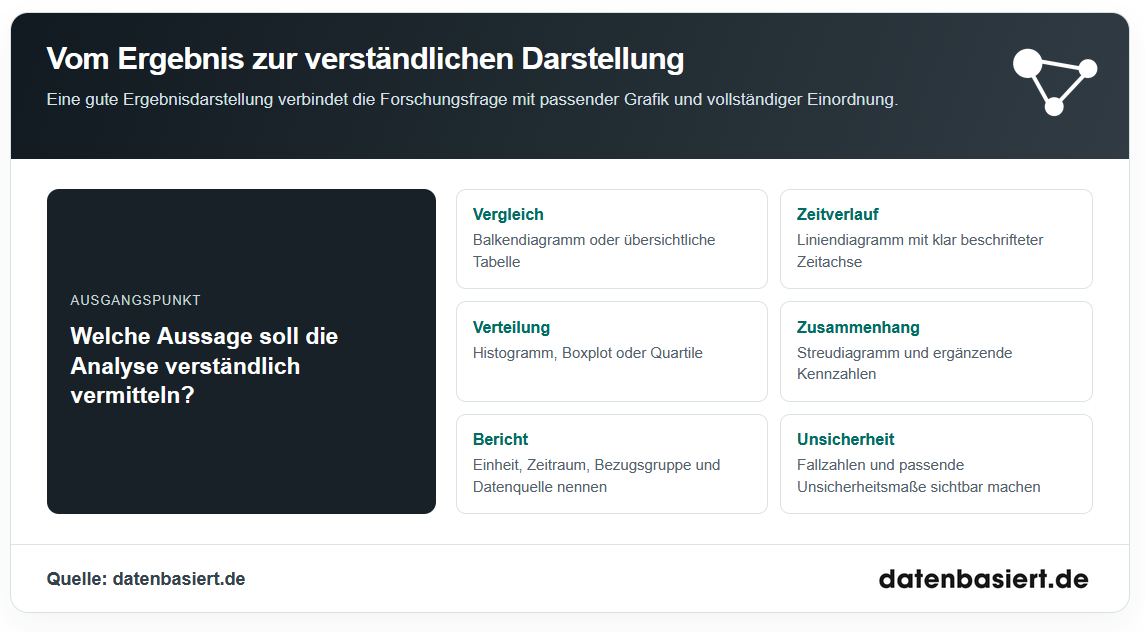
Die passende Visualisierung richtet sich nach Analyseziel, Datentyp und Skalenniveau. Eine Tabelle eignet sich, wenn genaue Kennzahlen und Fallzahlen im Vordergrund stehen. Balkendiagramme vergleichen kategoriale Werte; Liniendiagramme zeigen zeitliche Entwicklungen; Histogramme und Boxplots beschreiben Verteilungen numerischer Messwerte. Ein Streudiagramm macht sichtbar, wie sich zwei quantitative Variablen gemeinsam verändern, während ein Kreisdiagramm nur bei wenigen Anteilen eines klar definierten Ganzen sinnvoll bleibt.
Für die Auswahl ist auch die Lesbarkeit wichtig. Achsen, Einheiten, Legende und Datenquelle müssen erkennbar sein; unnötige 3D-Effekte oder abgeschnittene Skalen erschweren den Vergleich. Eine Grafik sollte die zentrale statistische Aussage hervorheben, aber die zugrunde liegenden Fallzahlen und Unsicherheitsintervalle nicht verdecken.
Ergebnisse verständlich zusammenfassen
Ein Ergebnistext verbindet Kennzahl, Bezugsgruppe und Zeitraum in einem Satz. Statt einen Mittelwert ohne Kontext zu nennen, sollte klar sein, welche Variable gemessen wurde und auf wie vielen gültigen Beobachtungen die Berechnung beruht. Bei Gruppenvergleichen gehören die Differenz, die Effektgröße und – sofern berechnet – das Konfidenzintervall zusammen. So bleibt verständlich, wie groß ein Befund ist und wie präzise er geschätzt wurde.
Datenbasis und Unsicherheit angeben
Zum statistischen Bericht gehören Erhebungsmethode, Stichprobengröße, Umgang mit fehlenden Werten und verwendete Analyseverfahren. Bei einer Inferenzstatistik sollten Schätzwerte nicht ohne Standardfehler oder Konfidenzintervall präsentiert werden, wenn diese Angaben für die Interpretation wichtig sind. Auch eine Vollerhebung kann Messfehler, Definitionswechsel oder nicht erfasste Fälle enthalten. Transparenz über Datenqualität und Modellannahmen macht eine Auswertung überprüfbar.
Eine statistische Analyse wird aussagekräftig, wenn Forschungsfrage, Datenerhebung, statistische Methode und Interpretation aufeinander abgestimmt sind. Vertiefende Beiträge zu Korrelation und Kausalität sowie zur Zeitreihenanalyse zeigen, wie spezifische Fragestellungen mit passenden Verfahren weiter untersucht werden.


