
Was ist Explainable-AI?
Explainable-AI bezeichnet Methoden, mit denen Menschen die Vorhersagen und Entscheidungswege künstlicher Intelligenz nachvollziehen können. Die deutsche Bezeichnung lautet erklärbare KI; die Abkürzung XAI steht für Explainable Artificial Intelligence. XAI untersucht, welche Merkmale eine Ausgabe beeinflussen, wie sich ein Modell bei veränderten Eingaben verhält und welche Zusammenhänge seine Vorhersagen prägen.
Erklärbare KI ist ein Forschungs- und Anwendungsfeld innerhalb der künstlichen Intelligenz. Zum Einsatz kommen interpretierbare Modelle sowie zusätzliche Erklärverfahren für komplexe Modelle. Eine XAI-Auswertung kann Merkmalsbeiträge darstellen, Entscheidungsregeln sichtbar machen oder alternative Eingaben mit einem anderen Ergebnis ermitteln.
Explainability und Interpretierbarkeit
Interpretierbarkeit beschreibt, wie unmittelbar sich ein Modell verstehen lässt. Bei einem kleinen Entscheidungsbaum sind Entscheidungsregeln und Verzweigungen direkt ablesbar. Explainability bezeichnet häufig die Fähigkeit, auch schwer verständliches Modellverhalten mithilfe zusätzlicher Methoden zu erklären. In der Forschung überschneiden sich diese Begriffe; das zu erklärende Modell und die konkrete Fragestellung bestimmen die Auswahl des Verfahrens.
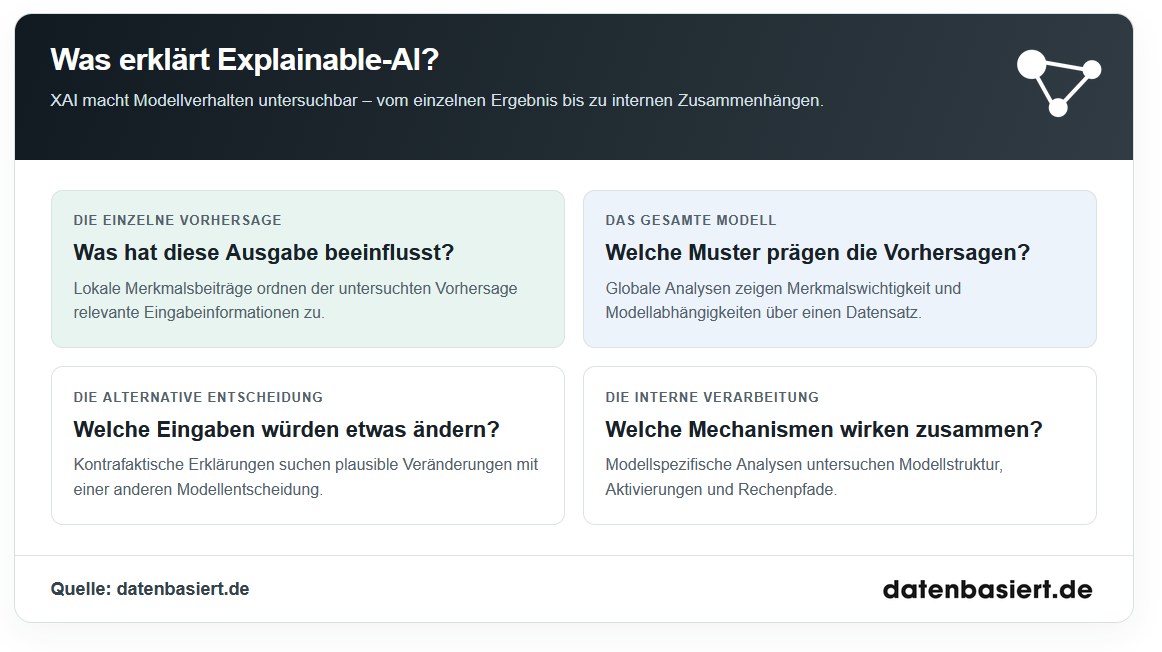
Bei Blackbox-KI fehlen verständliche Einblicke in die Entscheidungslogik. XAI kann einzelne Vorhersagen analysieren, ohne sämtliche Modellparameter zu entschlüsseln. Ziel ist eine Erklärung, die zum tatsächlichen Modellverhalten passt und den Empfängern eine fachliche Prüfung ermöglicht.
Erklärbarkeit und Transparenz
Transparenz betrifft den Zugang zu Informationen über Trainingsdaten, Modellarchitektur und Entwicklung. Erklärbarkeit betrifft das Verständnis einer Vorhersage oder eines Modellzusammenhangs. Veröffentlichter Quellcode schafft deshalb noch keine verständliche Erklärung. Umgekehrt kann ein modellagnostisches Erklärverfahren Erkenntnisse liefern, obwohl die Modellgewichte nicht zugänglich sind.
Für nachvollziehbare KI müssen außerdem Erklärung und Entscheidung auseinandergehalten werden. Eine Modellvorhersage kann durch feste Entscheidungsregeln, Schwellenwerte und menschliche Bewertungen ergänzt werden. Explainable-AI sollte deutlich machen, welchen Bestandteil eines solchen Entscheidungssystems die jeweilige Erklärung tatsächlich untersucht.
Wie funktioniert erklärbare KI?
Explainable-AI setzt an unterschiedlichen Stellen an: bei der Modellarchitektur, an den Eingaben und Ausgaben oder an internen Aktivierungen. Für die Auswahl eines XAI-Verfahrens sind insbesondere der Umfang der Erklärung und der verfügbare Modellzugang entscheidend.
Interpretierbare Modelle und Post-hoc-Erklärungen
Intrinsische Interpretierbarkeit entsteht durch eine verständliche Modellstruktur. Kurze Regellisten, überschaubare lineare Modelle und kleine Entscheidungsbäume erlauben eine direkte Analyse ihrer Entscheidungslogik. Additive Modelle zerlegen Vorhersagen in Beiträge einzelner Merkmale; ausdrücklich modellierte Wechselwirkungen können diese Darstellung ergänzen.
Post-hoc-Verfahren erklären dagegen ein bereits trainiertes Modell. Ein Erklärverfahren untersucht dessen Vorhersagen oder interne Berechnungen und erstellt eine zusätzliche Darstellung. Die Modellleistung bleibt dadurch zunächst unverändert. Ein besser erklärtes Modell wird erst dann besser, wenn die Analyse zu geeigneten Änderungen an Trainingsdaten, Modellarchitektur oder Entscheidungsregeln führt.
Lokale und globale Erklärungen
Eine lokale Erklärung untersucht eine bestimmte Eingabe und die zugehörige Vorhersage. Lokale Merkmalsbeiträge zeigen, welche Informationen die Ausgabe gegenüber einem Referenzwert erhöhen oder verringern. Ein lokales Ersatzmodell beschreibt das Verhalten in der Umgebung dieser Eingabe.
Eine globale Erklärung betrachtet das Modell über einen Datensatz hinweg. Globale Merkmalswichtigkeit ordnet Eingabevariablen nach einem festgelegten Kriterium. Effektkurven zeigen, wie Vorhersagen mit Merkmalswerten zusammenhängen. Die Zusammenfassung lokaler Erklärungen kann globale Muster sichtbar machen, aber Unterschiede zwischen Teilgruppen oder einzelnen Vorhersagen verdecken.
Modellagnostische und modellspezifische Verfahren
Modellagnostische Verfahren benötigen keine bestimmte Modellarchitektur. Sie verändern Eingaben und analysieren die resultierenden Ausgaben. LIME und Permutation Feature Importance lassen sich deshalb auf unterschiedliche Modelle des Machine Learning anwenden.
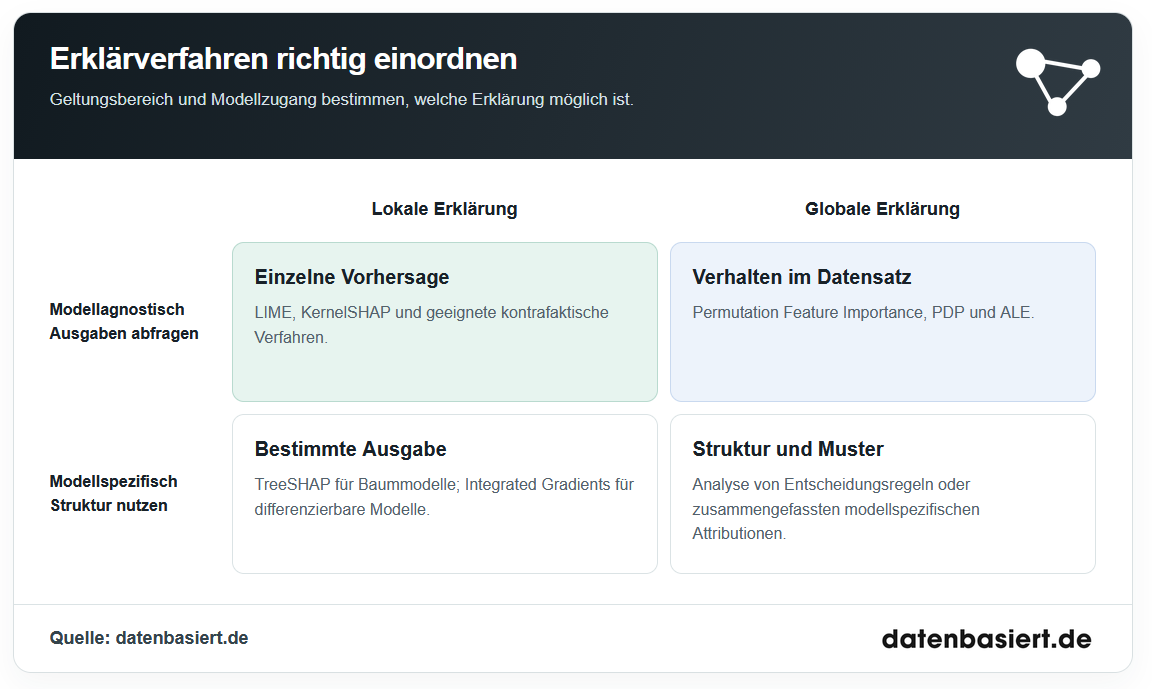
Modellspezifische Verfahren verwenden Eigenschaften einer Modellklasse. TreeSHAP nutzt die Struktur von Baummodellen; gradientenbasierte Attribution benötigt Zugriff auf geeignete differenzierbare Modelle. Bei neuronalen Netzen können zusätzlich Aktivierungen einzelner Schichten und gelernte Repräsentationen untersucht werden.
Quelle: datenbasiert.de
Explainable-AI: Methoden
XAI-Methoden beantworten unterschiedliche Fragen. Merkmalsattribution ordnet einer Vorhersage Beiträge zu. Merkmalswichtigkeit bewertet die Bedeutung von Variablen nach einem gewählten Kriterium. Effektkurven untersuchen Modellabhängigkeiten. Kontrafaktische Erklärungen suchen Eingaben, mit denen sich die Modellentscheidung ändert.
SHAP: Beiträge zu einer Vorhersage
SHAP steht für SHapley Additive exPlanations und verbindet lokale Erklärungen mit Shapley-Werten aus der kooperativen Spieltheorie. Die Vorhersage wird als Referenzwert plus Merkmalsbeiträge dargestellt. Die Beiträge berücksichtigen, wie sich ein Merkmal in unterschiedlichen Merkmalskombinationen auf die modellierte Ausgabe auswirkt.
Bei der Interpretation zählen Referenzdaten, Abhängigkeiten zwischen Merkmalen und Ausgabeskala. SHAP-Werte können sich auf einen Modellscore, eine Wahrscheinlichkeit oder eine andere transformierte Ausgabe beziehen. Ein positiver Beitrag bedeutet eine Erhöhung gegenüber dem Referenzwert. Ob diese Erhöhung erwünscht ist, hängt von der Zielgröße ab.
TreeSHAP ist auf Baummodelle ausgerichtet und eignet sich unter anderem für einen Random Forest. KernelSHAP ist ein modellagnostischer Ansatz. Für eine globale Übersicht werden häufig die absoluten SHAP-Werte über viele Vorhersagen zusammengefasst; die Richtung einzelner Beiträge geht in dieser Rangfolge verloren.
LIME: Lokale Ersatzmodelle
LIME bedeutet Local Interpretable Model-agnostic Explanations. Das Verfahren erzeugt veränderte Eingaben in der Nähe eines untersuchten Falls und ruft die zugehörigen Modellvorhersagen ab. Anschließend wird ein einfaches Surrogatmodell angepasst, das die lokale Entscheidungslogik möglichst gut nachbildet.
Ein solches Ersatzmodell erklärt die untersuchte Umgebung. Seine Gültigkeit hängt von den erzeugten Eingaben, ihrer Gewichtung und der Übereinstimmung mit dem ursprünglichen Modell ab. Für eine belastbare LIME-Auswertung sollten die Eingabevarianten plausibel sein. Wiederholungen mit unterschiedlichen Stichproben zeigen, wie stabil die lokale Erklärung ausfällt.
Kontrafaktische Erklärungen
Kontrafaktische Erklärungen, auch Counterfactual Explanations genannt, vergleichen eine ursprüngliche Eingabe mit einer veränderten Alternative. Gesucht werden Merkmalsänderungen, die eine andere Vorhersage oder Modellentscheidung erzeugen. Dabei bestimmt das Abstandsmaß, welche Veränderung als klein gilt.
Praktisch brauchbare kontrafaktische Erklärungen berücksichtigen unveränderliche Merkmale, zulässige Werte und Abhängigkeiten zwischen Eingabevariablen. Eine Alternative sollte erreichbar und verständlich sein. Mehrere unterschiedliche Alternativen können sinnvoller sein als eine einzige rechnerisch minimale Änderung. Die Reaktion des Modells ist dabei von der Wirkung einer tatsächlichen Handlung zu unterscheiden.
Permutation Feature Importance
Permutation Feature Importance misst Merkmalswichtigkeit anhand der Modellleistung. Die Werte eines Merkmals werden innerhalb eines Datensatzes vertauscht; anschließend wird der Vorhersagefehler erneut berechnet. Verschlechtert sich die Leistung deutlich, war die ursprüngliche Merkmalsinformation für die gewählte Kennzahl wichtig.
Die Methode erfordert einen geeigneten Bewertungsdatensatz und eine zur Aufgabe passende Fehlerkennzahl. Korrelierte Merkmale können sich gegenseitig ersetzen. Außerdem kann das Vertauschen unrealistische Merkmalskombinationen erzeugen. Gruppenweise oder bedingte Varianten der Permutation helfen, bestimmte Abhängigkeiten gezielter zu untersuchen.
Merkmalseffekte: PDP, ICE und ALE
Ein Partial Dependence Plot, kurz PDP, zeigt durchschnittliche Modellvorhersagen bei unterschiedlichen Werten eines Merkmals. Individual Conditional Expectation, kurz ICE, stellt entsprechende Kurven für einzelne Fälle dar. ICE-Kurven machen sichtbar, wenn das Modell für unterschiedliche Eingaben verschieden auf dasselbe Merkmal reagiert.
Accumulated Local Effects, kurz ALE, fasst lokale Änderungen der Vorhersage entlang der beobachteten Merkmalsverteilung zusammen. ALE reduziert damit bestimmte Probleme unplausibler Merkmalskombinationen, die bei PDPs entstehen können. Die Kurven beschreiben Modellabhängigkeiten. Für Aussagen über tatsächliche Ursachen bleibt die Unterscheidung zwischen Korrelation und Kausalität entscheidend.
Attribution für Bilder und Texte
Attributionsverfahren untersuchen, welche Eingabebestandteile eine Ausgabe beeinflussen. Bei Bildern können das Pixel oder Bildregionen sein, bei Texten Token oder Textabschnitte. Saliency Maps visualisieren solche Zuordnungen. Was eine Hervorhebung bedeutet, hängt vom verwendeten Attributionsverfahren und der untersuchten Ausgabe ab.
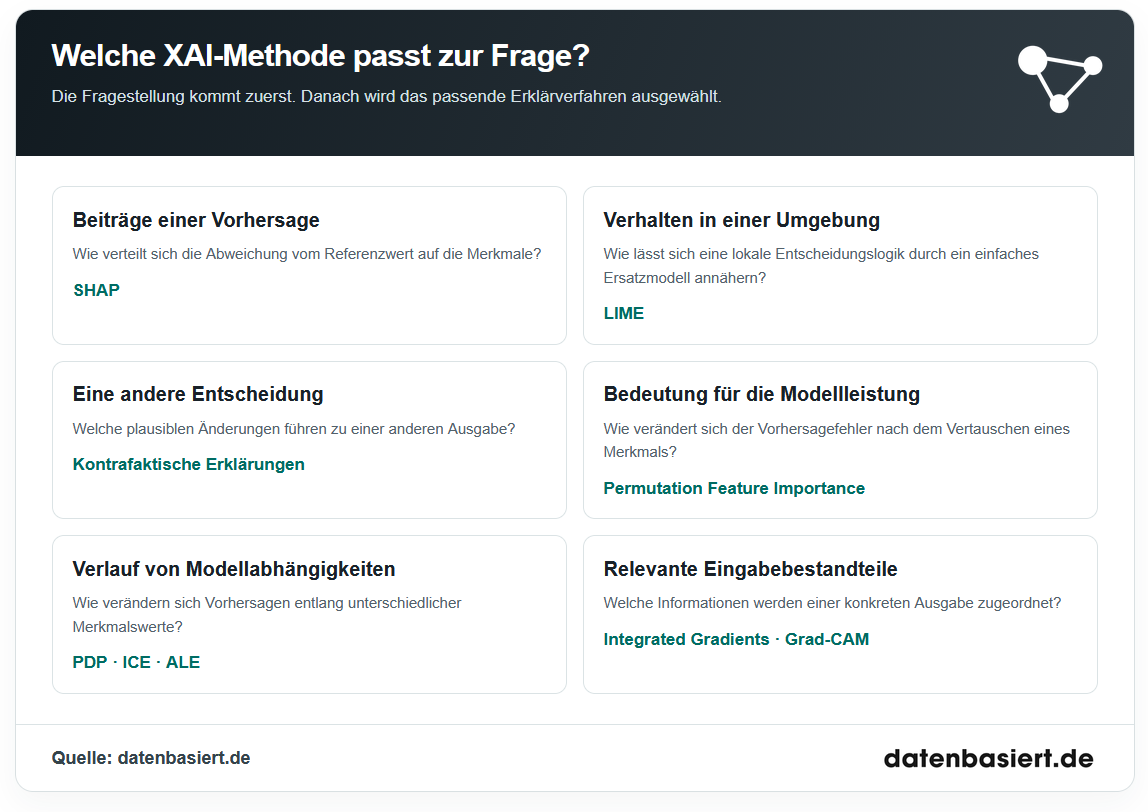
Integrated Gradients summiert Gradienten entlang eines Pfades von einer Referenzeingabe zur untersuchten Eingabe. Grad-CAM nutzt Gradienten und Aktivierungen geeigneter Bildmodelle, um relevante Regionen für eine Ausgabe hervorzuheben. Occlusion-Verfahren entfernen oder verdecken Eingabebestandteile und beobachten die veränderten Vorhersagen. Referenzeingabe und Art der Veränderung beeinflussen die resultierende Attribution.
Beispiele
Ein Spamfilter ordnet eingehende Nachrichten anhand verschiedener Merkmale ein. Eine bloße Ausgabe wie „Spam“ zeigt die Klassifikation. Explainable-AI ergänzt Informationen dazu, welche Merkmale den Modellscore beeinflusst haben und wie sich die Einstufung überprüfen lässt.
Eine Spam-Einstufung erklären
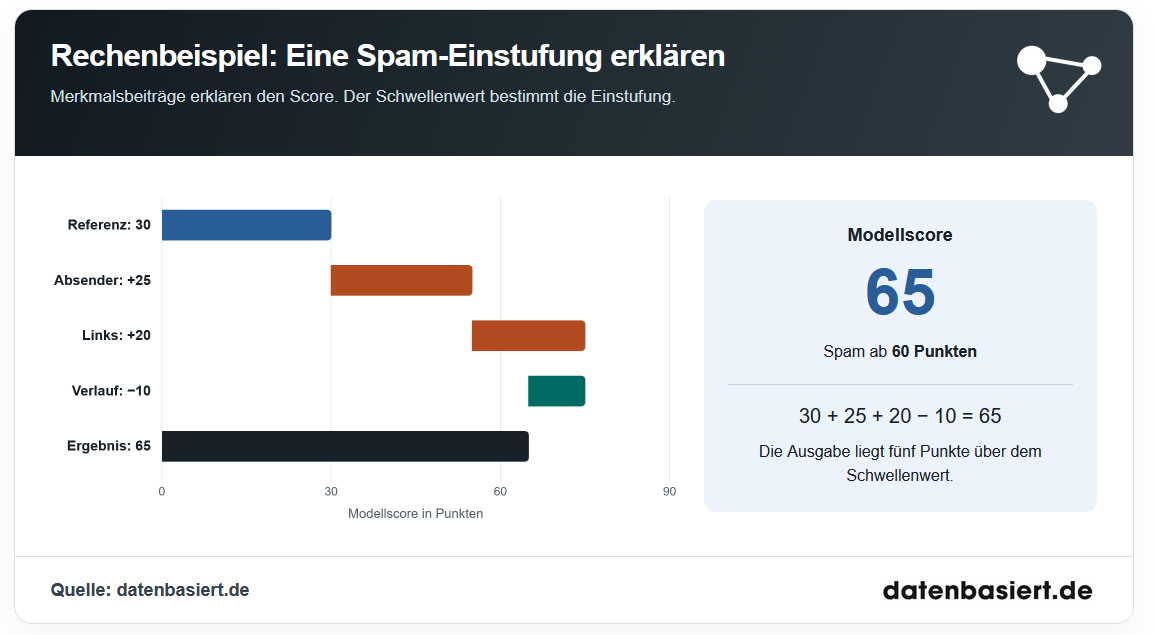
Im folgenden vereinfachten Rechenbeispiel beginnt eine additive Erklärung bei einem Referenzwert von 30 Scorepunkten. Merkmale der Nachricht erhöhen oder verringern diesen Wert. Das Entscheidungssystem stuft Nachrichten ab 60 Punkten als Spam ein.
| Bestandteil | Beitrag zum Modellscore | Bedeutung im Rechenbeispiel |
|---|---|---|
| Referenzwert | 30 Punkte | Ausgangswert der Erklärung |
| Auffälliges Absendermuster | +25 Punkte | Erhöht den Score |
| Verdächtige Verlinkungen | +20 Punkte | Erhöht den Score |
| Frühere unauffällige Nachrichten | −10 Punkte | Verringert den Score |
| Ergebnis | 65 Punkte | Liegt oberhalb des Schwellenwerts von 60 Punkten |
Die Beiträge ergeben gemeinsam 30 + 25 + 20 − 10 = 65 Punkte. Die Erklärung zeigt, wie die Merkmale zum Modellscore beitragen. Die Einstufung „Spam“ entsteht durch den zusätzlichen Schwellenwert. Diese Trennung macht erkennbar, ob eine Prüfung am Modell oder an der Entscheidungsregel ansetzen muss.
Die Erklärung überprüfen
Nun wird geprüft, ob die Merkmale korrekt erfasst wurden und plausible Änderungen die erwarteten Modellreaktionen auslösen. Dafür werden einzelne Linkmerkmale gezielt verändert, während die übrigen Nachrichteneigenschaften möglichst vergleichbar bleiben. Ändert sich der Score, liefert das weitere Informationen über die Abhängigkeit des Modells.
Eine kontrafaktische Erklärung würde eine veränderte Nachricht suchen, deren Score unter 60 Punkten liegt. Sie müsste auch Wechselwirkungen zwischen Merkmalen berücksichtigen. Aus dem Beitrag von +20 Punkten folgt deshalb nicht, dass das Entfernen beliebiger Links den Score exakt um 20 Punkte senkt. Merkmalsattribution und tatsächliche Modellreaktion werden getrennt überprüft.
Explainable-AI bei Sprachmodellen
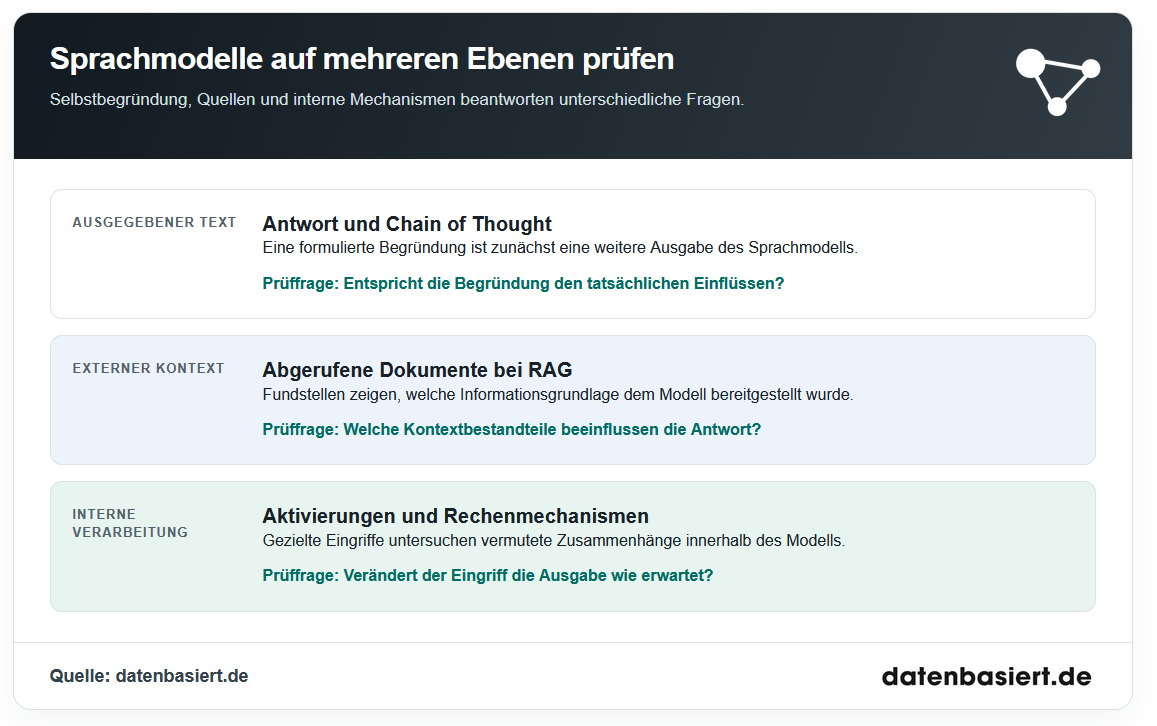
Große Sprachmodelle, auch Large Language Models oder LLMs genannt, stellen XAI vor besondere Aufgaben. Sie erzeugen längere Ausgaben, deren Token voneinander und vom Kontext abhängen. Eine Erklärung muss deshalb festlegen, ob sie einzelne Token, eine Antwortentscheidung oder interne Rechenmechanismen untersucht.
Selbstbegründungen und Chain of Thought
Ein Sprachmodell kann eine Antwort begründen oder eine Chain of Thought ausgeben. Diese Gedankenkette ist zunächst selbst generierter Text. Sie kann Hinweise auf die Verarbeitung liefern, aber entscheidende Einflüsse auslassen oder nachträglich eine plausible Begründung formulieren. Verständliche Formulierungen belegen deshalb noch keine Erklärungstreue.
Bei Systemen mit Retrieval-Augmented Generation, kurz RAG, können abgerufene Dokumente und Fundstellen dokumentiert werden. Das verbessert die Nachvollziehbarkeit der Informationsgrundlage. Eine Quellenangabe zeigt jedoch nicht automatisch, welchen Einfluss die Fundstelle auf die generierte Antwort hatte. Dafür werden zusätzlich Attribution, Gegenprüfungen und gezielte Veränderungen des Kontexts benötigt.
Mechanistische Interpretierbarkeit
Mechanistische Interpretierbarkeit untersucht interne Aktivierungen und gelernte Repräsentationen neuronaler Netze. Forschende suchen Rechenmechanismen, die bestimmte Ausgaben beeinflussen. Gezielte Eingriffe in Aktivierungen können prüfen, ob ein vermuteter Mechanismus tatsächlich zum Modellverhalten beiträgt.
Die Analyse kann auf einzelne Komponenten, Merkmale oder zusammenhängende Rechenpfade begrenzt sein. Attention-Gewichte allein reichen als vollständige Erklärung eines Transformers nicht aus. Entscheidend ist, ob ein untersuchter Zusammenhang durch Eingriffe bestätigt wird und wie weit sich die Ergebnisse auf andere Eingaben übertragen lassen.
Qualität von KI-Erklärungen prüfen
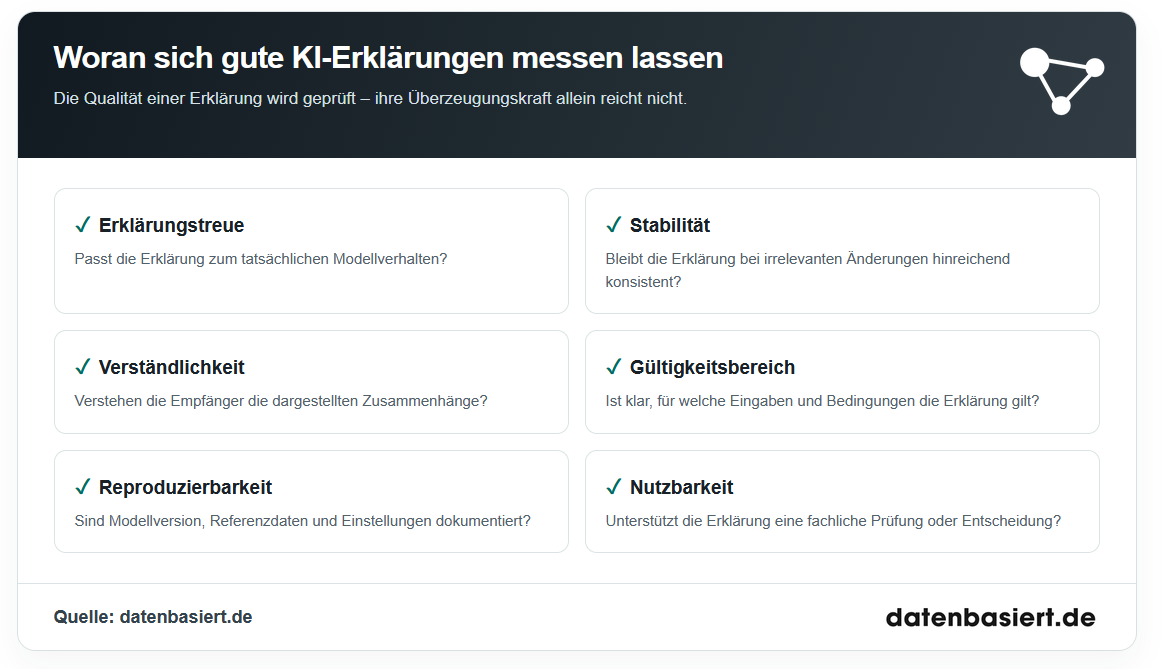
Eine überzeugende Visualisierung und eine zutreffende Modellerklärung sind unterschiedliche Ergebnisse. XAI sollte deshalb an klaren Kriterien bewertet werden. Die Prüfung verbindet technische Erklärungstreue, Stabilität und Verständlichkeit mit dem Zweck der jeweiligen Erklärung.
Erklärungstreue und Stabilität
Faithfulness bezeichnet die Übereinstimmung einer Erklärung mit dem tatsächlichen Modellverhalten. Für ein Surrogatmodell lässt sich prüfen, wie gut seine Vorhersagen in der untersuchten Umgebung mit den Ausgaben der Blackbox übereinstimmen. Bei Attributionen wird untersucht, ob als relevant markierte Eingabebestandteile die Modellvorhersage tatsächlich beeinflussen.
Stabilität betrifft die Frage, ob ähnliche Bedingungen ähnliche Erklärungen ergeben. Große Unterschiede nach kleinen irrelevanten Veränderungen können auf ein unzuverlässiges Erklärverfahren hinweisen. Nahe einer echten Entscheidungsgrenze kann sich allerdings auch das Modellverhalten stark ändern. Deshalb werden Modellrobustheit und Stabilität der Erklärung getrennt betrachtet.
Verständlichkeit und Nutzbarkeit
Eine Erklärung muss zur Zielgruppe passen. Entwickler benötigen häufig detaillierte Merkmalsbeiträge und Fehlermuster. Betroffene Personen benötigen verständliche Informationen zur konkreten Entscheidung. Nutzerstudien können prüfen, ob eine Erklärung das Verständnis verbessert und zu sachgerechteren Entscheidungen führt.
Dabei ist bloßes Vertrauen kein ausreichendes Erfolgskriterium. Eine Erklärung kann überzeugend wirken und trotzdem irreführen. Sinnvoller ist zu untersuchen, ob Nutzer fehlerhafte Vorhersagen erkennen, Unsicherheit angemessen einschätzen und relevante Informationen berücksichtigen. So wird die Erklärung an ihrer tatsächlichen Verwendung gemessen.
Modellleistung und Erklärungsgüte
Modellleistung und Erklärungsgüte benötigen unterschiedliche Prüfgrößen. Präzision und Recall bewerten Klassifikationen; Fehlerkennzahlen bewerten numerische Vorhersagen. Erklärungstreue bewertet dagegen die Übereinstimmung einer Erklärung mit dem Modellverhalten. Eine zutreffende Vorhersage kann mit einer unzutreffenden lokalen Erklärung verbunden sein.
| Prüfgegenstand | Geeigneter Prüfungsansatz |
|---|---|
| Vorhersagequalität | Unabhängige Testdaten und passende Fehlerkennzahlen |
| Lokales Ersatzmodell | Übereinstimmung mit Modellvorhersagen in der untersuchten Umgebung |
| Merkmalsattribution | Gezielte Eingabeveränderungen und Prüfung der resultierenden Vorhersagen |
| Kontrafaktische Erklärungen | Erreichbarkeit, zulässige Merkmale und tatsächliche Änderung der Modellentscheidung |
| Fairness | Gruppenbezogene Fehlerquoten und Prüfung relevanter Entscheidungsregeln |
Kalibrierung untersucht zusätzlich, ob ausgegebene Wahrscheinlichkeiten mit beobachteten Häufigkeiten übereinstimmen. Weder Kalibrierung noch Fairness lassen sich allein aus Merkmalswichtigkeit ableiten. Für eine vollständige Modellbewertung werden Leistungstests, XAI-Auswertungen und fachliche Kriterien zusammengeführt.
Referenzdaten und Kausalität
Referenzdaten beeinflussen, womit eine Vorhersage verglichen wird. Ändert sich die Referenzgruppe, können sich Merkmalsbeiträge verschieben. Für reproduzierbare XAI-Auswertungen werden deshalb Modellversion, Datengrundlage, Erklärverfahren und Einstellungen dokumentiert.
Auch eine hohe Erklärungstreue belegt keine Kausalität. Ein Modell kann zuverlässig auf einen statistischen Zusammenhang reagieren, ohne einen Ursache-Wirkungs-Mechanismus abzubilden. Ebenso beweist eine plausible Erklärung weder Fairness noch Fehlerfreiheit. Diese Eigenschaften benötigen passende Datenanalysen und eigene Prüfverfahren.
Quelle: datenbasiert.de
Explainable-AI-Tools
Für die praktische Umsetzung stehen mehrere Open-Source-Bibliotheken zur Verfügung. Die Auswahl richtet sich nach Modellarchitektur, Datentyp und Erklärziel. Eine Bibliothek stellt Erklärverfahren bereit; Datenaufbereitung und fachliche Interpretation bleiben Teil der Analyse.
| Tool | Schwerpunkt | Geeignet für |
|---|---|---|
| SHAP | Shapley-basierte Merkmalsattribution und Visualisierung | Lokale Beiträge und zusammengefasste Modellanalysen |
| LIME | Lokale interpretierbare Ersatzmodelle | Erklärungen für Tabellen, Texte und Bilder |
| Captum | Attribution für PyTorch-Modelle | Untersuchung von Eingaben, Schichten und Neuronen |
| InterpretML | Interpretierbare Modelle und Blackbox-Erklärverfahren | Vergleich verständlicher Modelle mit ergänzenden Erklärungen |
| Alibi Explain | Mehrere Verfahren für Modellinspektion und Erklärbarkeit | Unter anderem kontrafaktische Erklärungen und regelbasierte Anchors |
Captum bietet unter anderem Integrated Gradients für die Untersuchung neuronaler Netze. InterpretML enthält Explainable Boosting Machines, die Merkmalseffekte in additiven Modellen darstellen können. Anchors erzeugt lokale Wenn-dann-Regeln mit einer unter den gewählten Stichprobenbedingungen geschätzten Präzision. Diese unterschiedlichen Ansätze sollten nach ihrer Fragestellung ausgewählt werden.
Vor einer Integration werden unterstützte Modelltypen, benötigter Modellzugriff und Rechenaufwand geprüft. Manche Erklärverfahren benötigen viele zusätzliche Modellabfragen. Bei umfangreichen Datensätzen ist deshalb festzulegen, welche Vorhersagen einzeln erklärt werden und welche Auswertungen für die globale Modellanalyse erforderlich sind.
Explainable-AI einsetzen
XAI wird am besten als Bestandteil der Modellentwicklung und Modellüberwachung geplant. Eine Datenanalyse klärt zunächst Datenqualität, Zielgröße und Einsatzbedingungen. Danach wird festgelegt, welche Erklärungen für die Bewertung und Verwendung des Modells benötigt werden.
Erklärziel und Verfahren festlegen
Zuerst wird die Frage formuliert: Geht es um eine einzelne Vorhersage, globale Merkmalswichtigkeit oder eine erreichbare alternative Modellentscheidung? Danach werden Datentyp und Modellzugang geprüft. Daraus ergibt sich, welche lokalen, globalen oder modellspezifischen Verfahren infrage kommen.
Anschließend werden Referenzdaten und Bewertungsdaten ausgewählt. Ein erster XAI-Durchlauf wird auf Erklärungstreue und Stabilität untersucht. Erst danach folgt die Darstellung für die vorgesehenen Empfänger. Bei der Datenanalyse mit KI gehören die Erklärung und ihre fachliche Prüfung in denselben Arbeitsprozess.
Erklärungen im Betrieb überwachen
Nach einer Modelländerung können sich Vorhersagen und Merkmalsbeiträge verändern. Data Drift verändert die Verteilung der Eingabedaten; Concept Drift betrifft veränderte Beziehungen zwischen Eingaben und Zielgröße. Die Modellüberwachung sollte deshalb neben der Modellleistung auch auffällige Veränderungen der Erklärungen erfassen.
Eine veränderte Merkmalswichtigkeit ist ein Anlass für weitere Untersuchungen. Sie belegt für sich genommen noch keine Verschlechterung. Dokumentierte Modellversionen und vergleichbare Referenzdaten helfen, Veränderungen einzuordnen. Explainable-AI unterstützt so die laufende Prüfung eines KI-Systems und macht fachliche Entscheidungen über seinen Einsatz besser nachvollziehbar.


