
Was ist Blackbox-KI?
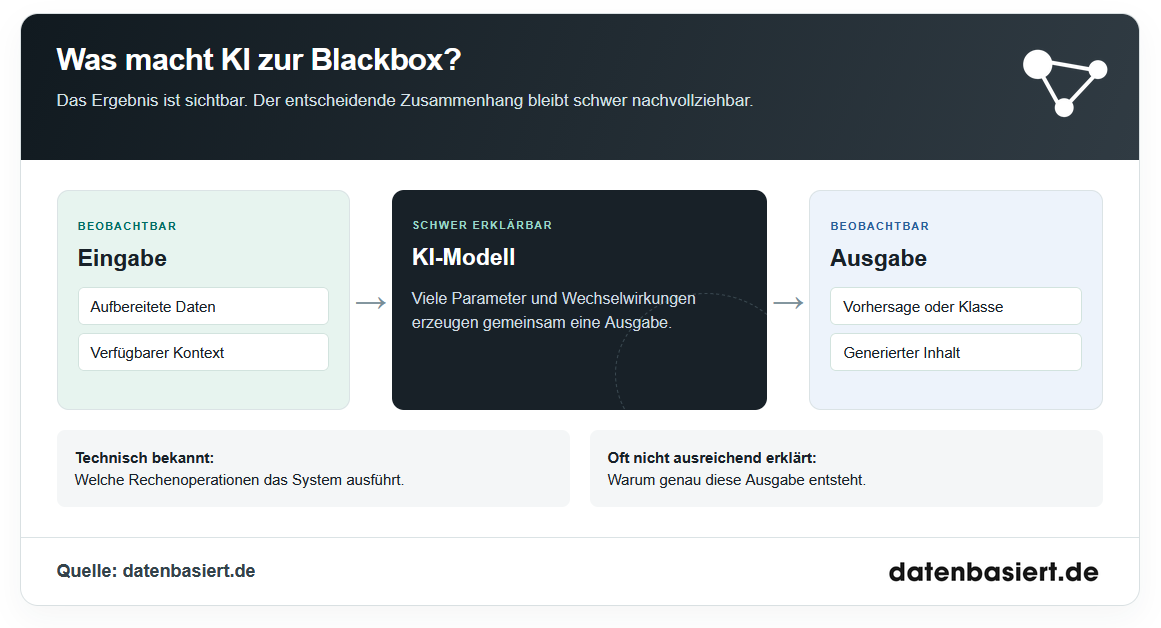
Blackbox-KI ist künstliche Intelligenz, deren Eingaben und Ergebnisse erkennbar sind, deren interne Entscheidungslogik sich jedoch nicht ausreichend erklären lässt. Ein Blackbox-Modell erzeugt eine Vorhersage, einen Score oder einen Text. Welche Merkmale und Wechselwirkungen diese Ausgabe bestimmen, bleibt für Menschen schwer nachvollziehbar.
Der Begriff Black Box AI beschreibt fehlende Interpretierbarkeit oder fehlende Transparenz eines KI-Systems. Besonders komplexe neuronale Netze und große Ensembles gelten häufig als Blackbox. Explainable-AI oder Erklärbare KI setzt genau hier an: Sie untersucht Modellverhalten, Merkmalsbeiträge und Entscheidungswege, damit sich KI-Ergebnisse gezielter prüfen lassen.
Eingaben und Ergebnisse
Ein KI-Modell verarbeitet Eingabedaten, auch Input genannt, zu einer Ausgabe, dem Output. Die Datenaufbereitung übersetzt Rohdaten in Merkmale oder numerische Repräsentationen. Das Modell berechnet daraus eine Klassifikation, eine numerische Vorhersage oder generierte Inhalte. Die Anwendung eines trainierten Modells heißt Inferenz.
Beim Machine Learning entstehen Modellparameter durch Training mit Daten. Entwickler bestimmen Modellarchitektur, Trainingsverfahren und Optimierungsziel. Das Training passt die Gewichte so an, dass die Vorhersagen die gewählte Verlustfunktion möglichst gut minimieren. Die Verlustfunktion bewertet dabei die Abweichung vom Trainingsziel.
Ein klassisch programmierter Algorithmus kann ausdrücklich formulierte Entscheidungsregeln abarbeiten. Ein gelerntes Modell verteilt seine Entscheidungslogik dagegen häufig über zahlreiche Parameter. Der Quellcode beschreibt dann den Rechenablauf, liefert aber noch keine verständliche Erklärung jeder Vorhersage.
Fehlende Nachvollziehbarkeit
Nachvollziehbarkeit betrifft unterschiedliche Ebenen. Eine globale Erklärung beschreibt das Modellverhalten über viele Eingaben hinweg. Eine lokale Erklärung untersucht eine einzelne Vorhersage. Merkmalswichtigkeit und Merkmalsbeiträge beantworten wiederum, welche Eingabeinformationen für die Modellleistung oder eine bestimmte Ausgabe relevant sind.
Interpretierbarkeit bezeichnet meist die unmittelbare Verständlichkeit eines Modells. Erklärbarkeit umfasst auch Verfahren, die ein komplexes Modell nachträglich untersuchen. Die Begriffe werden nicht überall einheitlich verwendet. Entscheidend ist deshalb, ob eine Erklärung die Modellstruktur, einzelne Vorhersagen oder durchschnittliche Zusammenhänge beschreibt.
Quelle: datenbasiert.de
Warum entsteht eine Blackbox?
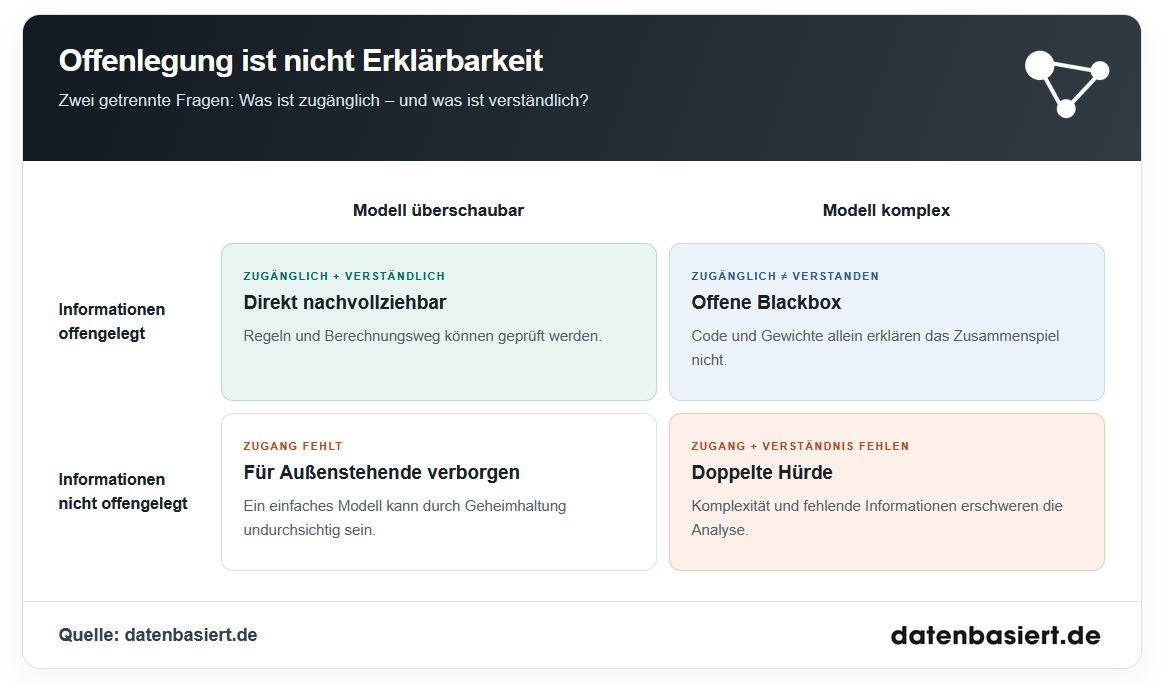
Eine Blackbox entsteht durch komplexe Modellarchitekturen, schwer deutbare Repräsentationen oder fehlenden Zugang zu Modellinformationen. Technische Interpretierbarkeit und organisatorische Transparenz sind getrennte Eigenschaften: Ein veröffentlichtes Modell kann schwer verständlich sein, während ein einfaches Modell durch Geheimhaltung undurchsichtig bleibt.
Komplexe neuronale Netze
Neuronale Netze verbinden künstliche Recheneinheiten über Gewichte. Aktivierungsfunktionen ermöglichen nichtlineare Zusammenhänge zwischen Eingaben und Ausgaben. Beim Deep Learning verarbeiten viele Schichten die Daten schrittweise. Das Training erzeugt interne Repräsentationen, die sich nicht durchgehend in menschlich verständliche Merkmale übersetzen lassen.
Einzelne Gewichte erklären das Modellverhalten deshalb kaum. Ihre Wirkung hängt von weiteren Parametern, Aktivierungen und den jeweiligen Eingaben ab. Auch Wechselwirkungen zwischen Merkmalen sind wichtig: Ein Merkmal kann je nach Kombination mit anderen Merkmalen unterschiedliche Beiträge zur Vorhersage leisten. Die bloße Anzahl der Modellparameter erfasst diese Komplexität nur teilweise.
Transformer verwenden unter anderem Attention-Mechanismen, um Informationen im Kontext zu gewichten. Attention-Gewichte können Einblicke liefern, bilden aber nicht automatisch den vollständigen Entscheidungsweg eines Sprachmodells ab. Mechanistische Interpretierbarkeit untersucht deshalb interne Repräsentationen und Rechenmechanismen durch gezielte Eingriffe in das Modell.
Auch andere Verfahren des maschinellen Lernens können Blackbox-Modelle sein. Ein Random Forest verbindet viele Entscheidungsbäume zu einem Ensemble. Gradient Boosting kombiniert Modelle schrittweise. Die gemeinsame Vorhersage kann präzise sein, obwohl die gesamte Entscheidungslogik schwer zu überblicken ist.
Nicht offengelegte Modelle und Daten
Bei proprietärer KI können Trainingsdaten, Quellcode, Modellgewichte oder Entscheidungsregeln unzugänglich bleiben. Über eine Programmierschnittstelle erhalten Nutzer dann lediglich die Ausgabe des KI-Systems. Ohne Informationen zur Datenaufbereitung und Modellversion ist die Prüfung der Vorhersagen zusätzlich eingeschränkt.
Open Source und Open Weights verbessern den Zugang zu bestimmten Modellinformationen. Open Weights bezeichnet die Veröffentlichung von Modellgewichten; daraus folgt noch keine Offenlegung aller Trainingsdaten und Trainingsverfahren. Auch ein vollständig dokumentiertes neuronales Netz bleibt erklärungsbedürftig. Transparenz erleichtert Modellanalysen, ersetzt jedoch keine Interpretierbarkeit.
Blackbox vs. Whitebox
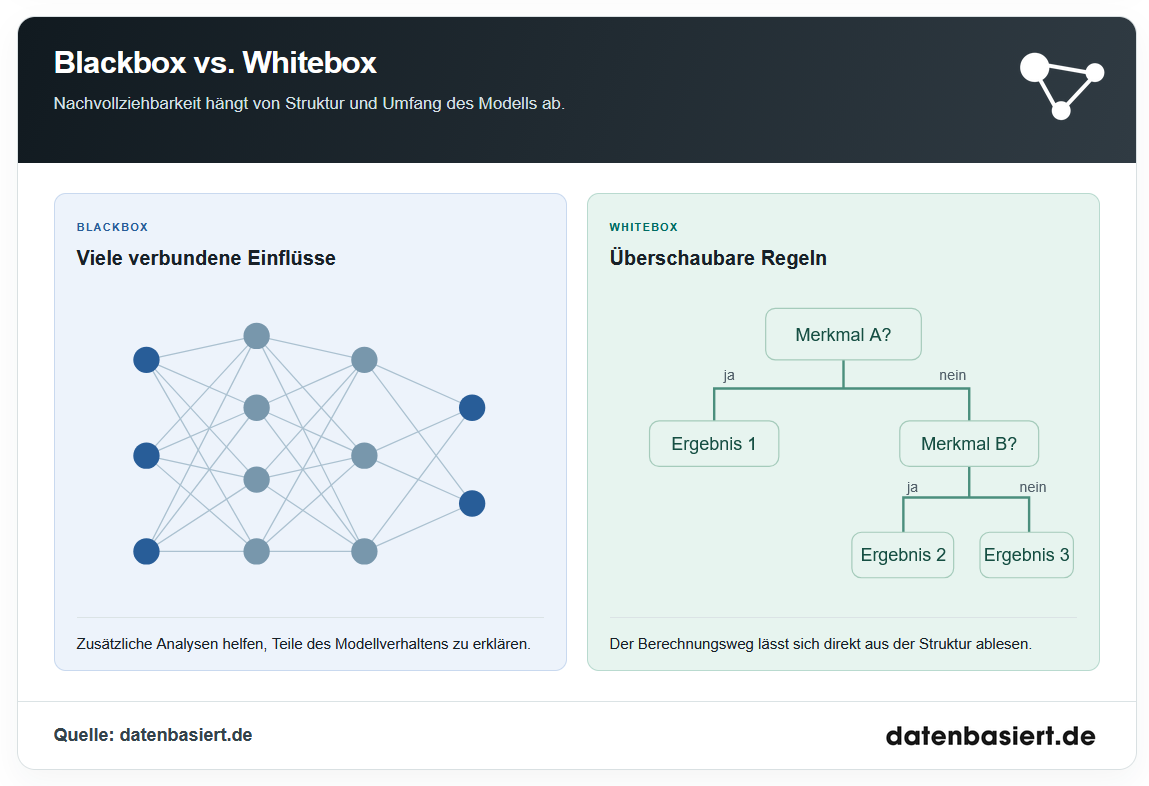
Whitebox-Modelle besitzen eine direkt nachvollziehbare Modellstruktur. Kleine Entscheidungsbäume und kurze Regellisten machen sichtbar, welche Entscheidungsregeln zu einer Ausgabe führen. Überschaubare lineare Modelle zeigen, wie Eingabemerkmale rechnerisch zur Vorhersage beitragen. Blackbox-Modelle benötigen häufiger zusätzliche Erklärverfahren.
| Vergleich | Blackbox | Whitebox |
|---|---|---|
| Entscheidungslogik | Viele schwer überschaubare Wechselwirkungen oder verborgene Regeln | Direkt nachvollziehbare Regeln oder Berechnungen |
| Typische Modelle | Tiefe neuronale Netze, große Ensembles | Kleine Entscheidungsbäume, kurze Regellisten, überschaubare lineare Modelle |
| Interpretierbarkeit | Häufig eingeschränkt; ergänzende XAI-Verfahren erforderlich | Durch die Modellstruktur unterstützt |
| Erklärung | Oft nachträgliche Analyse einer Vorhersage oder des Modellverhaltens | Häufig unmittelbar aus Entscheidungsregeln ableitbar |
| Transparenz | Quellcode und Modellgewichte können offen oder geschlossen sein | Auch hier entscheidet der Informationszugang über die Prüfbarkeit |
| Leistung | Vorhersagequalität durch unabhängige Testdaten prüfen | Vorhersagequalität ebenfalls durch unabhängige Testdaten prüfen |
Ein Entscheidungsbaum verliert mit zunehmender Tiefe an Übersichtlichkeit. Lineare Modelle mit zahlreichen Merkmalen und Wechselwirkungen können ebenfalls schwer interpretierbar werden. Whitebox und Blackbox beschreiben deshalb keine starre Rangfolge sämtlicher Modellklassen. Greybox bezeichnet einen Zwischenbereich mit teilweise zugänglicher Entscheidungslogik.
Bei der Modellauswahl sollten Interpretierbarkeit und Vorhersagequalität gemeinsam bewertet werden. Ein verständliches Modell mit vergleichbarer Leistung erleichtert die Prüfung von Entscheidungsregeln. Ein komplexes Modell muss seinen zusätzlichen Nutzen durch passende Leistungstests zeigen. Die Bezeichnung Blackbox allein belegt weder hohe Genauigkeit noch schlechte Qualität.
Blackbox-KI: Beispiele
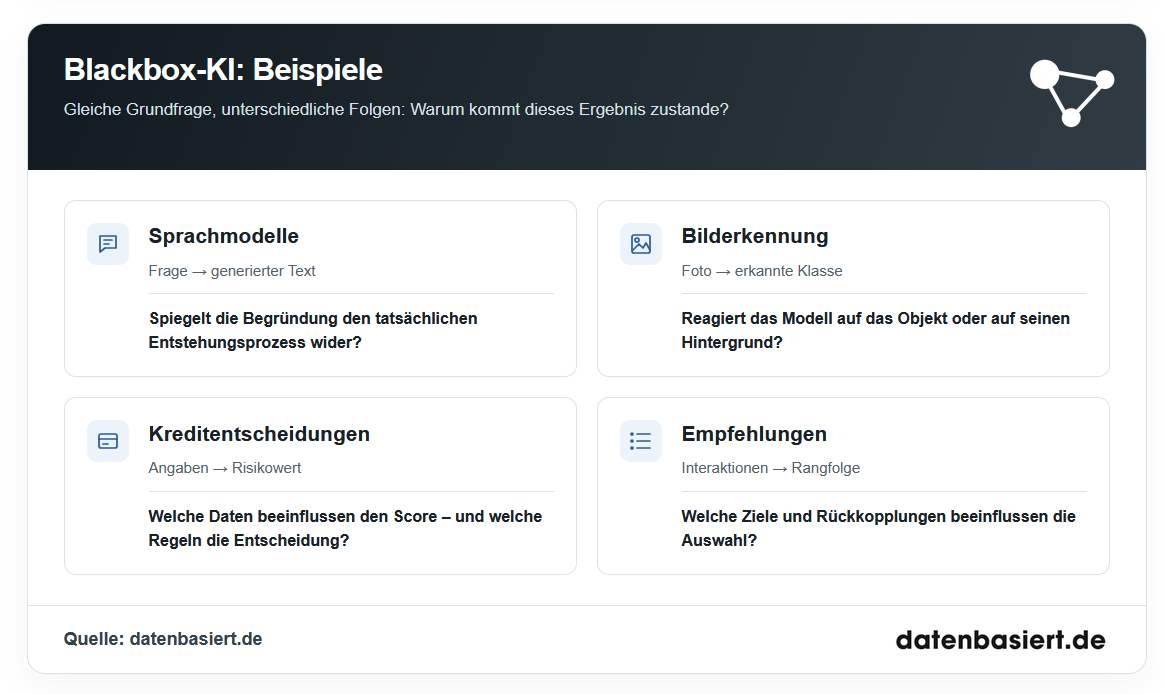
Das Blackbox-Problem zeigt sich bei generativer KI ebenso wie bei Klassifikationen und Empfehlungssystemen. Die folgenden Beispiele verdeutlichen, welche Informationen zur Erklärung einer Vorhersage fehlen können.
Sprachmodelle und Chatbots
Ein großes Sprachmodell, auch Large Language Model oder LLM genannt, verarbeitet einen Prompt und erzeugt Text Token für Token. Token sind die Texteinheiten, mit denen das Modell rechnet. Die Ausgabe beruht auf dem verfügbaren Kontext, den Modellgewichten und dem Verfahren zur Auswahl der nächsten Token.
Ein Chatbot kann seine Antwort begründen, ohne damit seine tatsächliche Entscheidungslogik offenzulegen. Auch eine Chain of Thought, eine ausgegebene Gedankenkette, bildet die internen Berechnungen nicht vollständig ab. Eine schlüssige Begründung kann daher mit einer Halluzination verbunden sein: einer erfundenen oder sachlich falschen Ausgabe. Textverständlichkeit und Erklärungstreue sind unterschiedliche Eigenschaften.
Bilderkennung
Ein Modell zur Bilderkennung soll Tierarten unterscheiden. In den Trainingsdaten erscheint eine Tierart häufig vor Schnee. Das neuronale Netz kann deshalb den Hintergrund statt der Tiermerkmale für die Klassifikation nutzen. Die Vorhersagen wirken richtig, solange die Testdaten ähnliche Bildhintergründe enthalten.
Saliency Maps markieren Bildbereiche, die für eine Ausgabe relevant erscheinen. Grad-CAM verwendet bei geeigneten neuronalen Netzen Gradienten und Aktivierungen, um wichtige Regionen für eine Klassifikation hervorzuheben. Solche Visualisierungen helfen bei der Suche nach unerwünschten Zusammenhängen. Gezielte Veränderungen des Hintergrunds prüfen anschließend, ob die vermutete Abhängigkeit tatsächlich im Modellverhalten sichtbar wird.
Kreditentscheidungen
Ein Kreditmodell berechnet aus Eingabedaten einen Risikowert. Für einen abgelehnten Antrag ist relevant, welche Merkmale den Score beeinflusst haben und ob die verwendeten Daten korrekt sind. Eine lokale Erklärung kann Merkmalsbeiträge aufschlüsseln; eine kontrafaktische Erklärung kann veränderte Eingaben mit einem anderen Modellergebnis zeigen.
Der Score ist jedoch nur ein Bestandteil des Entscheidungssystems. Weitere Entscheidungsregeln, Schwellenwerte und menschliche Prüfungen beeinflussen die Kreditentscheidung. Eine Untersuchung des Blackbox-Modells sollte deshalb mit der Prüfung des gesamten Ablaufs verbunden werden. Sonst erklärt man eine Vorhersage, obwohl die entscheidende Regel außerhalb des Modells liegt.
Personalisierte Empfehlungen
Ein Empfehlungsalgorithmus sortiert Inhalte anhand erwarteter Reaktionen. Beim YouTube-Algorithmus betrifft das die Auswahl und Rangfolge empfohlener Videos. Das Empfehlungssystem verarbeitet Nutzersignale und bewertet mögliche Inhalte anhand seiner Optimierungsziele.
Eine Rückkopplung entsteht, wenn ausgespielte Empfehlungen das Nutzerverhalten verändern und diese Interaktionen spätere Vorhersagen beeinflussen. Zur Erklärung gehören deshalb neben Merkmalen und Modellgewichten auch die Auswahl der Trainingsdaten und das Optimierungsziel. Die sichtbare Rangfolge allein zeigt diese Zusammenhänge nicht.
Das Blackbox-Problem
Das Blackbox-Problem erschwert die Beurteilung, ob ein KI-System aus belastbaren Zusammenhängen lernt und unter neuen Bedingungen zuverlässig arbeitet. Besonders wichtig sind Fehlermuster, Bias und die Ursachen fehlerhafter Vorhersagen. Eine hohe durchschnittliche Vorhersagequalität beantwortet diese Fragen nicht vollständig.
Richtige Ergebnisse aus falschen Gründen
Shortcut Learning bezeichnet gelernte Abkürzungen, mit denen ein Modell das Trainingsziel erfüllt, ohne die gewünschten Merkmale ausreichend zu berücksichtigen. Datenleckage, auffällige Nebenmerkmale und unrepräsentative Trainingsdaten können solche Abhängigkeiten begünstigen. Die Modellleistung sinkt dann, sobald sich die Datenverteilungen verändern.
Eine Korrelation ist keine Kausalität. Ein Modell kann statistische Zusammenhänge für präzise Vorhersagen nutzen, ohne die tatsächlichen Ursachen abzubilden. Erklärbare KI macht solche Zusammenhänge zugänglicher. Sie verwandelt eine Korrelation jedoch nicht automatisch in einen kausalen Mechanismus.
Verzerrungen und Diskriminierung
Bias bezeichnet systematische Verzerrungen, die durch Trainingsdaten, Datenaufbereitung oder ungeeignete Zielgrößen entstehen können. Unterrepräsentierte Gruppen, fehlerhafte Kennzeichnungen und historische Benachteiligungen beeinflussen das Training. Bei einer Blackbox ist schwerer erkennbar, welche Merkmale diese Verzerrungen transportieren.
Proxy-Merkmale wirken als Stellvertreter für andere Eigenschaften. Das Entfernen eines sensiblen Merkmals verhindert Bias daher nicht automatisch. Zur Prüfung der Fairness gehören gruppenspezifische Fehlerquoten und die Untersuchung ungerechtfertigter Unterschiede. Auch Whitebox-Modelle benötigen diese Prüfung: Nachvollziehbare Entscheidungsregeln können ebenfalls diskriminierende Zusammenhänge enthalten.
Schwierige Ursachenanalyse
Fehlerhafte KI-Ergebnisse können auf Trainingsdaten, Modellparameter oder nachgelagerte Entscheidungsregeln zurückgehen. Bei Overfitting passt sich das Modell zu stark an Besonderheiten der Trainingsdaten an. Diese Überanpassung verschlechtert die Generalisierung, also die Vorhersagequalität für neue Eingaben.
Eine Root-Cause-Analyse untersucht deshalb die vollständige Verarbeitungskette. Dokumentierte Datenversionen, Modellversionen und Transformationen ermöglichen reproduzierbare Leistungstests. Sensitivitätsanalysen und Merkmalswichtigkeit helfen, auffällige Abhängigkeiten einzugrenzen. Die Ursache muss anschließend anhand der Daten und des Modellverhaltens überprüft werden.
Vertrauen und Verantwortung
Ein hoher Score zeigt zunächst eine Modellbewertung. Wird eine Ausgabe als Wahrscheinlichkeit interpretiert, ist ihre Kalibrierung entscheidend: Stimmen vorhergesagte Wahrscheinlichkeiten und beobachtete Häufigkeiten hinreichend überein? Vorhersagequalität, Kalibrierung und Erklärbarkeit sollten getrennt untersucht werden.
Automation Bias entsteht, wenn Menschen automatisierte Ausgaben übermäßig übernehmen. Eine überzeugende Erklärung kann dieses Vertrauen verstärken, obwohl die Vorhersage falsch ist. Menschliche Kontrolle benötigt deshalb Fachwissen, Vergleichsdaten und tatsächliche Eingriffsmöglichkeiten. Die Verantwortung für ein KI-System bleibt bei den Menschen und Organisationen, die seine Verwendung gestalten.
Explainable-AI: Lösungsansätze
Explainable-AI oder Erklärbare KI heißt auf Englisch Explainable Artificial Intelligence, kurz XAI. Das verwandte Forschungsfeld Interpretable Machine Learning untersucht die Interpretierbarkeit gelernter Modelle. XAI umfasst sowohl verständliche Modellarchitekturen als auch Post-hoc-Verfahren, die ein trainiertes Modell nachträglich erklären.
Modellagnostische Verfahren untersuchen Eingaben und Ausgaben unabhängig von einer bestimmten Modellarchitektur. Modellspezifische Verfahren nutzen dagegen Eigenschaften einer Modellklasse, etwa Gradienten neuronaler Netze. Für die Auswahl eines Erklärverfahrens zählen der verfügbare Modellzugang und die Frage, die beantwortet werden soll.
Quelle: datenbasiert.de
LIME: Einzelne Vorhersagen erklären
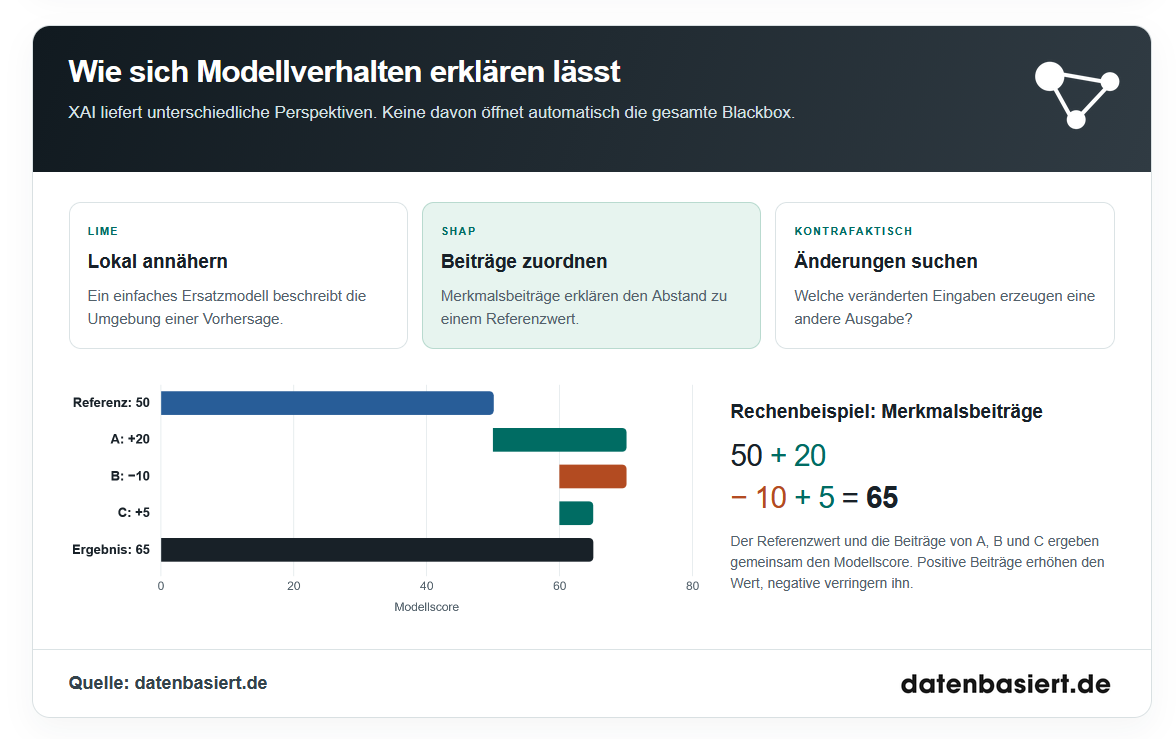
LIME steht für Local Interpretable Model-agnostic Explanations. Das Verfahren erzeugt Varianten einer Eingabe und fragt deren Vorhersagen beim Blackbox-Modell ab. Ein einfaches Ersatzmodell, auch Surrogatmodell genannt, bildet anschließend das lokale Modellverhalten nach. Nahe Varianten erhalten beim Anpassen dieses Ersatzmodells ein höheres Gewicht.
Die lokale Erklärung von LIME gilt für die untersuchte Umgebung. Ihre Erklärungstreue hängt davon ab, wie gut das Ersatzmodell dort die Vorhersagen der Blackbox trifft. Unplausible Eingaben, eine ungeeignete Definition von Nähe oder wechselnde Stichproben können die Merkmalsbeiträge verändern. Deshalb werden lokale Modellgüte und Stabilität der Erklärung mitgeprüft.
SHAP: Merkmalsbeiträge bestimmen
SHAP bedeutet SHapley Additive exPlanations. Grundlage sind Shapley-Werte aus der kooperativen Spieltheorie: Der Beitrag eines Merkmals wird unter Berücksichtigung unterschiedlicher Merkmalskombinationen zugeordnet. SHAP zerlegt eine Vorhersage in einen Referenzwert und additive Merkmalsbeiträge auf der gewählten Ausgabeskala.
Positive Merkmalsbeiträge erhöhen die Ausgabe gegenüber dem Referenzwert; negative Beiträge verringern sie. Die Referenzdaten und Annahmen über abhängige Merkmale beeinflussen die Erklärung. KernelSHAP ist ein modellagnostischer Ansatz, während TreeSHAP die Struktur von Baummodellen nutzt. SHAP erklärt das Modell und belegt für sich genommen keine Kausalität.
Kontrafaktische Erklärungen
Kontrafaktische Erklärungen, auch Counterfactual Explanations genannt, suchen veränderte Eingaben mit einer gewünschten Modellentscheidung. Anders als eine Rangfolge der Merkmalswichtigkeit beschreiben sie konkrete Unterschiede zwischen der ursprünglichen Eingabe und einer Alternative. Welche Änderungen als klein gelten, hängt vom verwendeten Abstandsmaß ab.
Gute kontrafaktische Erklärungen berücksichtigen unveränderliche Merkmale, realistische Wertebereiche und Abhängigkeiten zwischen Variablen. Die Alternative sollte erreichbar und mit den übrigen Eingabedaten vereinbar sein. Eine andere Vorhersage nach einer rechnerischen Veränderung garantiert noch keine entsprechende Wirkung einer Handlung in der Realität. Dafür braucht es zusätzlich Wissen über kausale Zusammenhänge.
Weitere XAI-Methoden
Neben lokalen Erklärungen ermöglichen weitere XAI-Verfahren die Untersuchung globaler Merkmalswichtigkeit und einzelner Modellabhängigkeiten. Die Verfahren unterscheiden sich darin, ob sie Vorhersagefehler, veränderte Ausgaben oder interne Gradienten auswerten.
| Verfahren | Was untersucht wird | Bedeutung für die Erklärung |
|---|---|---|
| Permutation Feature Importance | Veränderung des Vorhersagefehlers, wenn die Werte eines Merkmals vertauscht werden | Misst Merkmalswichtigkeit für die gewählte Leistungskennzahl |
| Partial Dependence Plot (PDP) | Durchschnittliche Vorhersagen bei variierten Merkmalswerten | Zeigt modellierte Zusammenhänge über einen Datensatz hinweg |
| Accumulated Local Effects (ALE) | Zusammengefasste lokale Änderungen der Vorhersage in datenbelegten Bereichen | Verringert bestimmte Probleme korrelierter Merkmale bei PDPs |
| Integrated Gradients | Aufsummierte Gradienten entlang eines Pfades von einer Referenzeingabe zur untersuchten Eingabe | Ordnet Eingabemerkmalen Beiträge bei differenzierbaren Modellen zu |
| Grad-CAM | Gradienten und Aktivierungen in geeigneten Bildmodellen | Hebt relevante Bildregionen für eine Ausgabe hervor |
Bei korrelierten Merkmalen kann die Permutation Feature Importance irreführend sein: Das Vertauschen erzeugt möglicherweise unrealistische Merkmalskombinationen, oder andere Merkmale ersetzen die verlorene Information. Auch ein Partial Dependence Plot kann Eingaben außerhalb plausibler Kombinationen auswerten. ALE berücksichtigt die beobachtete Datenverteilung stärker. Die Datenqualität bleibt für jede dieser Modellanalysen entscheidend.
Grenzen der Erklärbarkeit
Faithfulness, auch Erklärungstreue genannt, bezeichnet die Übereinstimmung einer Erklärung mit dem tatsächlichen Modellverhalten. Eine leicht verständliche Darstellung ist nur dann hilfreich, wenn sie die untersuchte Vorhersage zutreffend beschreibt. Erklärungen sollten außerdem bei ähnlichen Eingaben hinreichend stabil sein und relevante Merkmalsänderungen abbilden.
Lokale Erklärung und globale Erklärung sind nicht austauschbar. Eine einzelne SHAP-Auswertung beschreibt nicht sämtliche Entscheidungsregeln. Eine globale Merkmalswichtigkeit erklärt nicht automatisch jeden Einzelfall. Auch Saliency Maps liefern keine vollständige Rekonstruktion neuronaler Netze. XAI unterstützt die Prüfung von Blackbox-KI; Datenqualität, Fairness und Robustheit benötigen zusätzliche Untersuchungen.
KI-Ergebnisse überprüfen
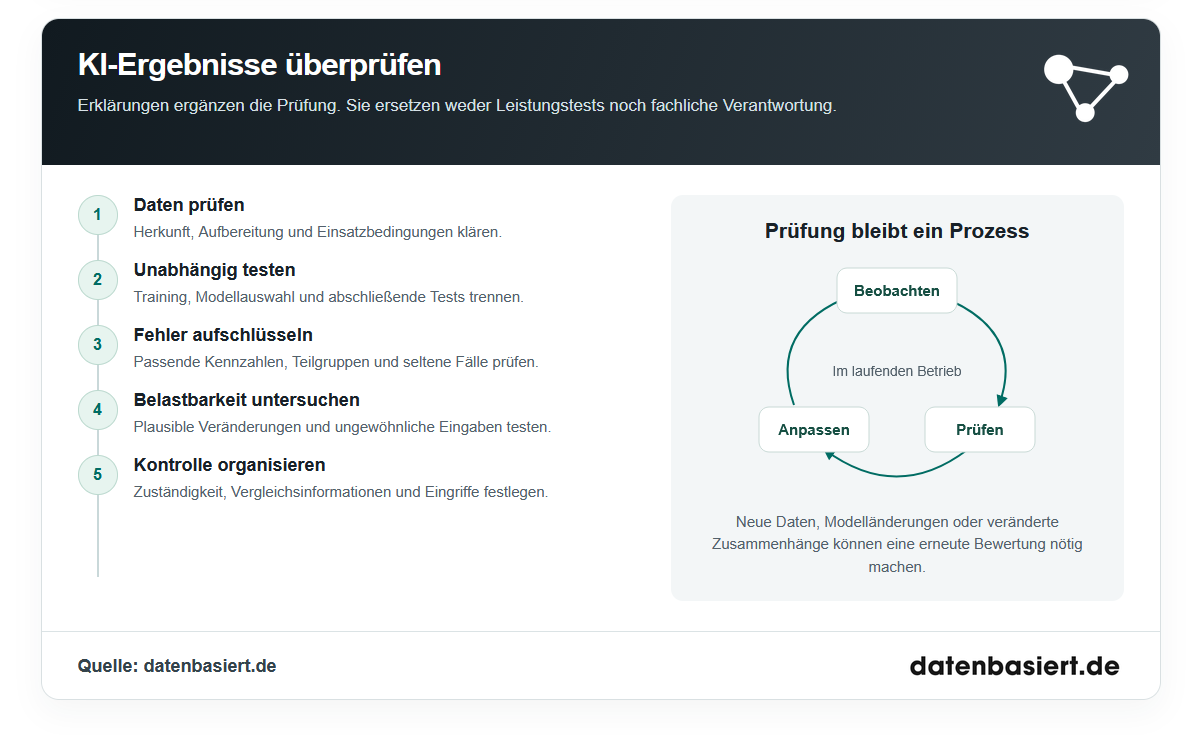
Die Prüfung einer Blackbox verbindet Leistungstests, Erklärbarkeit und fachliche Kontrolle. Vor dem Einsatz werden Testdaten, Bewertungsmaßstäbe und Zuständigkeiten festgelegt. Im laufenden Betrieb wird untersucht, ob Modellleistung und Datenverteilungen weiterhin zu den ursprünglichen Annahmen passen.
Unabhängige Tests und Vergleichsdaten
Trainingsdaten, Validierungsdaten und abschließende Testdaten erfüllen unterschiedliche Aufgaben. Das Training bestimmt die Modellparameter; die Validierung unterstützt die Modellauswahl. Der abschließende Test bewertet die Vorhersagequalität unabhängig von diesen Anpassungen. Datenleckage zwischen diesen Schritten kann die gemessene Modellleistung überzeichnen.
Für Klassifikationen zeigt eine Konfusionsmatrix richtige und falsche Zuordnungen. Präzision beschreibt, wie häufig positive Vorhersagen tatsächlich richtig sind. Recall beschreibt, welcher Anteil der tatsächlich positiven Fälle erkannt wird. Bei numerischen Vorhersagen messen Fehlerkennzahlen die Abweichung vom Zielwert. Welche Kennzahl zählt, hängt von den Folgen der jeweiligen Fehler ab.
Eine Datenanalyse der Modellleistung betrachtet außerdem Teilgruppen, seltene Fälle und Unsicherheit. Eingaben außerhalb der bekannten Datenverteilung werden als Out-of-Distribution bezeichnet. Robustheitstests untersuchen, wie das Modell auf solche Eingaben oder gezielte Veränderungen reagiert. Erklärverfahren helfen anschließend, auffällige Fehlermuster einzugrenzen.
Quelle: datenbasiert.de
Data Drift bezeichnet Veränderungen der Eingabedatenverteilung. Concept Drift betrifft veränderte Beziehungen zwischen Eingaben und Zielgröße. Beide Entwicklungen können die Modellleistung beeinträchtigen. Modellüberwachung, dokumentierte Modellversionen und erneute Leistungstests helfen, solchen Veränderungen nachzugehen.
Menschliche Kontrolle
Menschliche Kontrolle bedeutet, KI-Ergebnisse mit fachlichen Kriterien und unabhängigen Informationen zu prüfen. Verantwortliche müssen erkennen können, wann Testdaten unzureichend sind, Merkmalsbeiträge missverstanden werden oder eine Vorhersage nicht zum Einsatzfall passt. Sie benötigen die Möglichkeit, eine Modellentscheidung zurückzuweisen und Fehler untersuchen zu lassen.
Gerade bei der Datenanalyse mit KI gehören Einheiten, Datenaufbereitung und Berechnungswege zur Kontrolle. Eine plausible Ausgabe reicht nicht aus. Belastbare KI-Ergebnisse entstehen durch passende Daten, überprüfte Modellleistung und einen nachvollziehbaren Umgang mit Unsicherheit. Erklärbare KI liefert dafür wichtige Einblicke in die Blackbox.


