
Arten von Daten
Die Arten von Daten unterscheiden sich je nach Messniveau, Personenbezug, Struktur und technischer Darstellung. Diese Kategorien beantworten unterschiedliche Fragen und schließen sich nicht gegenseitig aus. Derselbe Datensatz kann gleichzeitig quantitativ, personenbezogen, strukturiert und digital sein.
Welche Einteilung sinnvoll ist, hängt davon ab, wofür Daten benötigt werden. In der Statistik bestimmt das Skalenniveau, welche Auswertungen passen. Im Datenschutz zählt, ob sich Personen identifizieren lassen. Im Datenmanagement geht es um Struktur und Verarbeitung; bei analog und digital um die technische Repräsentation.
Daten und Informationen
Daten sind aufgezeichnete Zeichen, Werte, Beobachtungen oder Messungen, die nach einer vereinbarten Bedeutung interpretiert werden können. Informationen entstehen, wenn diese Daten in einen Zusammenhang gestellt werden. Ein einzelner Wert ist deshalb noch nicht automatisch aussagekräftig: Definition, Einheit, Erhebungszeitpunkt und Herkunft entscheiden mit, was sich aus ihm ableiten lässt.
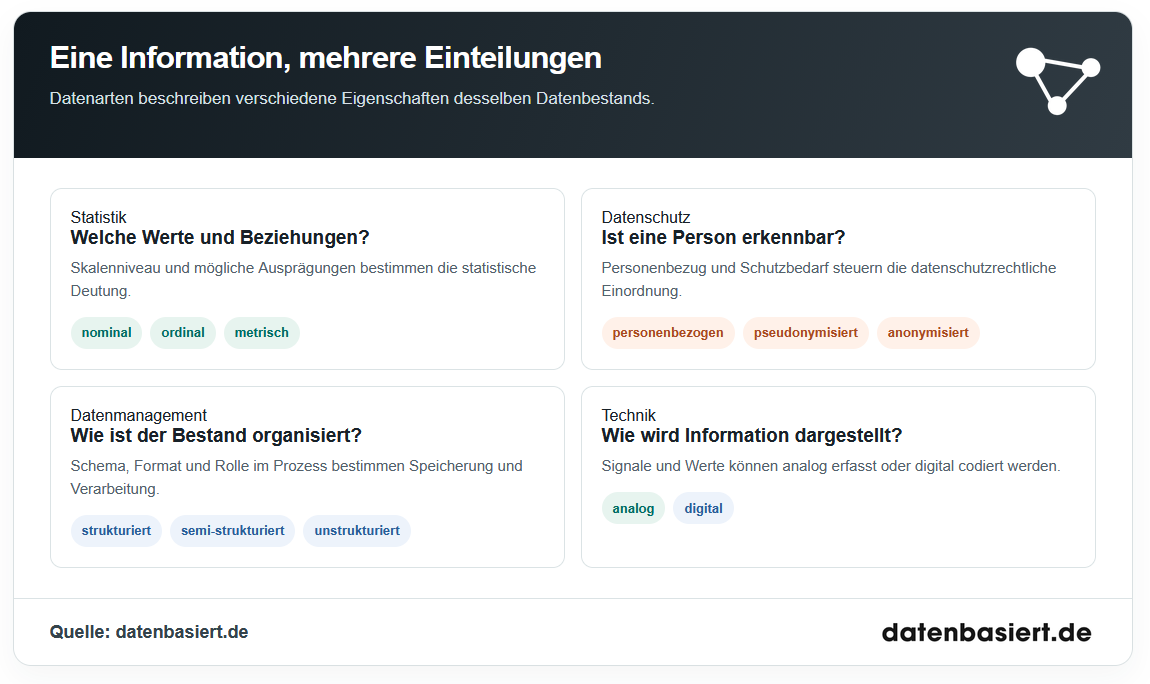
Die Bezeichnung „Datenart“ hat keine einzige fachübergreifende Taxonomie. Statistik, Datenschutz und Informatik ordnen Daten nach verschiedenen Achsen. Eine Einteilung nach Kategorien oder Skalenniveaus ist daher etwas anderes als eine Einteilung nach Dateiformat oder Personenbezug.
Datenarten nach Merkmal und Skalenniveau
In der empirischen Forschung und der statistischen Analyse werden Daten häufig als qualitative beziehungsweise kategoriale oder als quantitative beziehungsweise numerische Merkmale beschrieben. Zusätzlich unterscheidet man Skalenniveaus und die Anzahl möglicher Ausprägungen. Diese Unterscheidungen hängen zusammen, sind aber nicht identisch.
Qualitative und kategoriale Daten
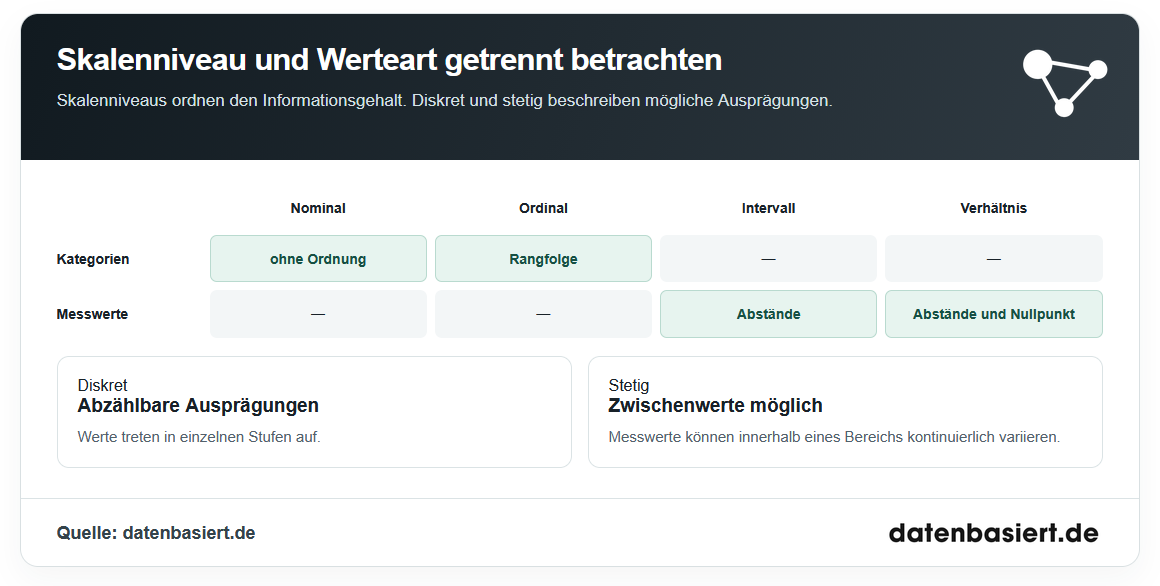
Qualitative Daten beschreiben Klassen, Eigenschaften oder Zugehörigkeiten. Ihre Ausprägungen stehen für Kategorien. Bei nominalskalierten Daten gibt es keine natürliche Reihenfolge. Ordinalskalierte Daten lassen sich ordnen; die Abstände zwischen den Rangstufen sind jedoch nicht automatisch messbar.
Kategoriale Daten können als Text oder als Zahl codiert sein. Eine Zahl, die lediglich eine Kategorie kennzeichnet, wird durch ihre Schreibweise nicht zu einer Messgröße. Entscheidend ist, welche Bedeutung die Codes in der Datendefinition erhalten.
Quantitative und numerische Daten
Quantitative Daten drücken eine messbare oder zählbare Größe durch Zahlenwerte aus. Bei diskreten Daten sind nur abgezählte Ausprägungen zulässig. Stetige Daten können theoretisch jeden Wert innerhalb eines Bereichs annehmen. Rundung und begrenzte Messgenauigkeit können stetige Messgrößen in gespeicherten Datensätzen allerdings abgestuft erscheinen lassen.
Diskret versus stetig beschreibt mögliche Werte; nominal, ordinal, Intervall und Verhältnis beschreiben den Informationsgehalt und die sinnvoll interpretierbaren Beziehungen einer Messung. Eine statistische Variable sollte daher nicht allein anhand ihrer Zahlenform eingeordnet werden.
Die vier Skalenniveaus
| Skalenniveau | Ordnung | Abstände | Absoluter Nullpunkt | Zulässige Deutung |
|---|---|---|---|---|
| Nominalskala | Keine natürliche Ordnung | Nicht interpretierbar | Nein | Kategorien unterscheiden und Häufigkeiten bestimmen |
| Ordinalskala | Rangfolge vorhanden | Abstände nicht festgelegt | Nein | Reihenfolge und Rangplätze vergleichen |
| Intervallskala | Rangfolge vorhanden | Gleich große Abstände interpretierbar | Nein | Differenzen bilden und Abstände vergleichen |
| Verhältnisskala | Rangfolge vorhanden | Gleich große Abstände interpretierbar | Ja | Zusätzlich Verhältnisse wie „doppelt so groß“ deuten |
Das Skalenniveau begrenzt, welche Kennzahlen und statistischen Verfahren sinnvoll sind. Für nominale Merkmale lassen sich Häufigkeiten vergleichen. Ordinaldaten erhalten eine Rangfolge. Bei Intervallskalen sind Differenzen interpretierbar; Verhältnisvergleiche benötigen einen sinnvollen absoluten Nullpunkt. Wer Zahlenwerte falsch einordnet, kann rechnerisch korrekte, aber inhaltlich unpassende Ergebnisse erhalten.
Welche Datenarten gibt es nach dem Datenschutz?
Für den Datenschutz ist entscheidend, ob sich die Daten auf eine identifizierte oder identifizierbare natürliche Person beziehen. Personenbezug kann direkt entstehen oder erst durch die Verbindung mehrerer Informationen. Datenschutzrechtliche Kategorien beschreiben den Schutzbedarf und die rechtliche Behandlung; sie sind keine statistischen Skalenniveaus.
Personenbezogene Daten
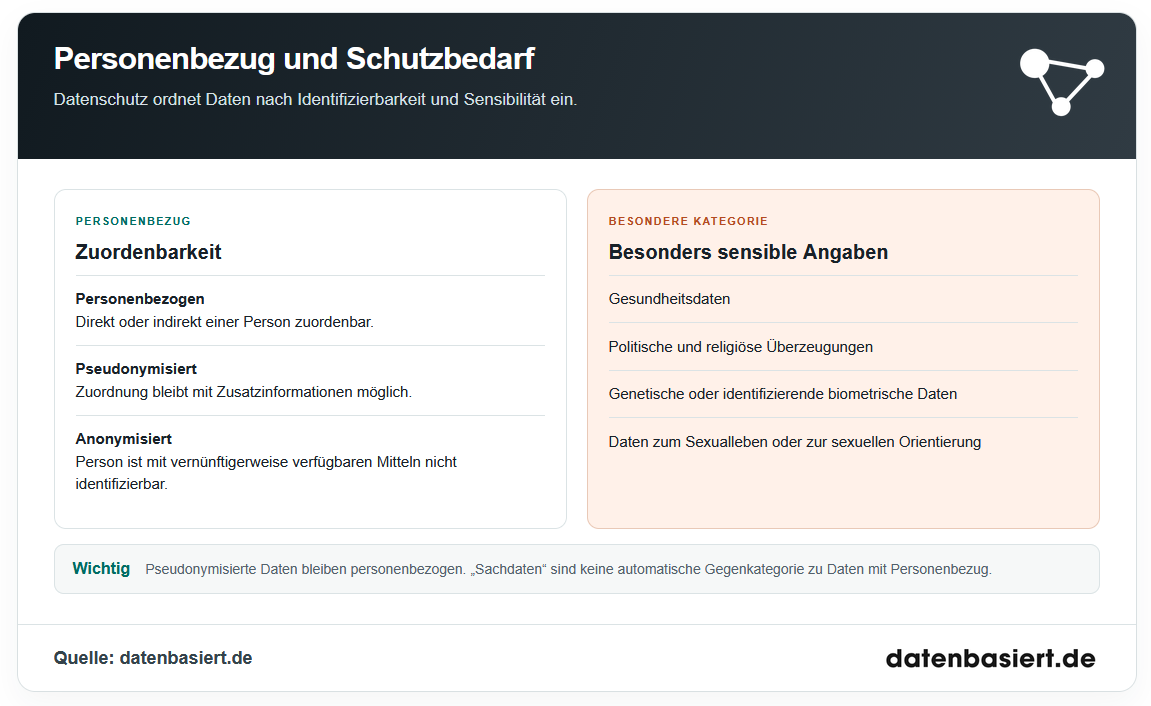
Personenbezogene Daten sind alle Informationen, die sich auf eine identifizierte oder identifizierbare Person beziehen. Eine Zuordnung kann über ein einzelnes Merkmal oder durch die Verknüpfung verschiedener Angaben möglich sein. Ob eine Information personenbezogen ist, hängt daher auch vom verfügbaren Zusatzwissen und dem Verarbeitungskontext ab.
Besondere Kategorien personenbezogener Daten
Die Datenschutz-Grundverordnung (DSGVO) nennt besondere Kategorien personenbezogener Daten, darunter Angaben zur rassischen oder ethnischen Herkunft, zur Gesundheit, zur politischen Meinung, zur Religion, zur Gewerkschaftszugehörigkeit, genetische Daten sowie Daten zum Sexualleben oder zur sexuellen Orientierung. Für diese Verarbeitung gelten besondere Schutzregeln und gesetzliche Voraussetzungen.
Biometrische Daten gehören in diesem Sinn dazu, wenn sie mit speziellen technischen Verfahren verarbeitet werden, um eine Person eindeutig zu identifizieren. Nicht jede Bilddatei oder jedes biometrische Merkmal fällt allein deshalb in diese besondere Kategorie; entscheidend sind Merkmal und Verarbeitungszweck.
Pseudonymisierte und anonymisierte Daten
Bei der Pseudonymisierung werden direkte Kennungen durch ein Pseudonym ersetzt oder getrennt verwahrt. Eine Zuordnung kann mit zusätzlichen Informationen weiterhin möglich sein. Pseudonymisierte Daten bleiben deshalb personenbezogene Daten und unterliegen weiterhin der DSGVO.
Anonymisierte Daten sind so verändert, dass eine Person unter Berücksichtigung vernünftigerweise einsetzbarer Mittel nicht mehr identifizierbar ist. Wirklich anonymisierte Daten fallen nicht mehr unter den Datenschutz für personenbezogene Daten. Die bloße Entfernung eines Namens reicht dafür nicht in jedem Fall aus.
„Sachdaten“ ist keine Gegenkategorie zu personenbezogenen Daten. Angaben über einen Sachverhalt können sich zugleich auf eine identifizierbare Person beziehen. Personenbezug, Sensibilität und Sachinhalt müssen deshalb getrennt geprüft werden.
Datenarten nach Struktur und Nutzung
In Unternehmen und Datenbanken werden Daten nach dem Aufbau ihrer Datensätze und ihrer Rolle im Geschäftsprozess organisiert. Die Struktur bestimmt, wie Daten gespeichert, abgefragt und für weitere Auswertungen aufbereitet werden können.
Strukturierte, semi-strukturierte und unstrukturierte Daten
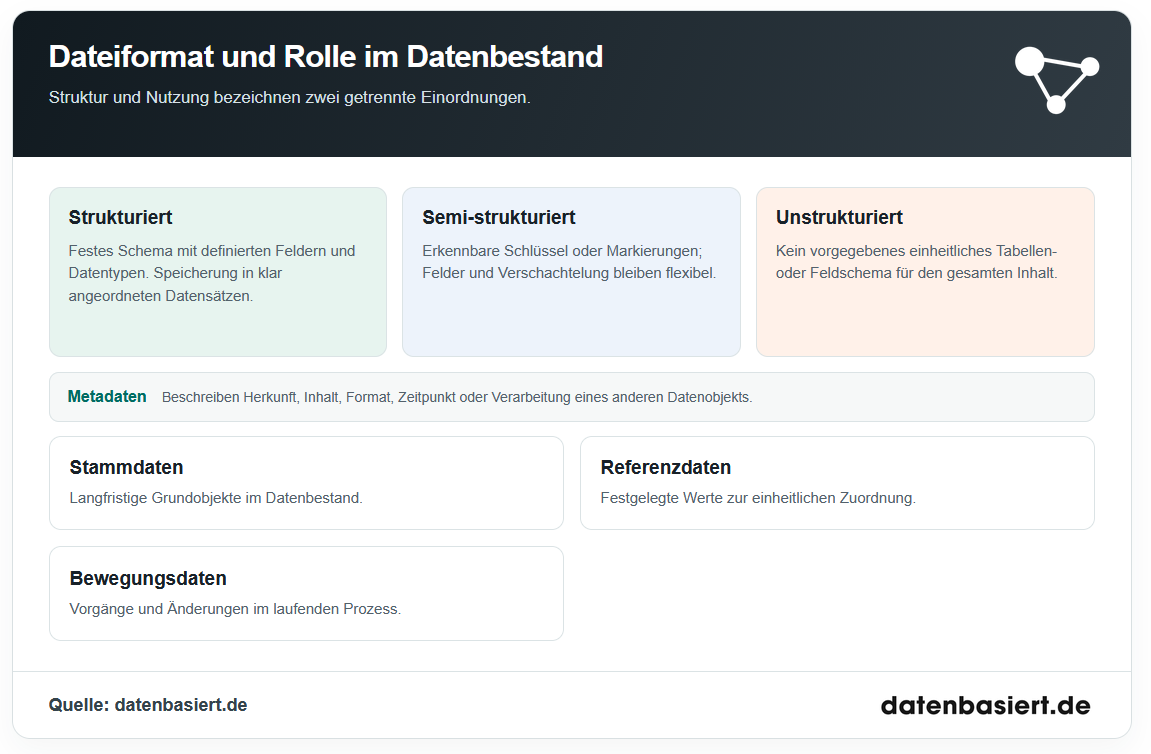
Strukturierte Daten folgen einem festgelegten Schema. Felder, Datentypen und Beziehungen sind vorgegeben, sodass Datenbanksysteme sie gezielt speichern und abfragen können. Semi-strukturierte Daten besitzen erkennbare Markierungen oder Schlüssel, lassen aber flexiblere Felder und verschachtelte Strukturen zu. Unstrukturierte Daten haben kein vorab einheitliches tabellarisches Schema.
Diese Kategorien bezeichnen Organisationsformen. Unstrukturierte Daten können zusätzlich durch Metadaten oder eine Datenbankbeschreibung erschlossen werden. Umgekehrt enthalten strukturierte Tabellen nicht automatisch qualitativ hochwertige oder korrekt erhobene Werte.
Metadaten beschreiben andere Daten
Metadaten sind Angaben über Entstehung, Inhalt, Herkunft, Format oder Verarbeitung von Daten. Sie helfen, Datensätze zu finden, einzuordnen und ihre Entstehung nachzuvollziehen. Metadaten können selbst personenbezogene Informationen enthalten, wenn sie auf eine Person oder deren Verhalten verweisen.
Stamm-, Referenz- und Bewegungsdaten
Stammdaten beschreiben längerfristig benötigte Grundobjekte eines Datenbestands. Referenzdaten liefern festgelegte Werte oder Codes, die zur einheitlichen Einordnung verwendet werden. Bewegungsdaten dokumentieren Vorgänge und Änderungen im laufenden Geschäftsbetrieb. Die Begriffe können je nach Organisation und Datenmodell unterschiedlich abgegrenzt sein.
Datenarten nach Herkunft und Zeitbezug
Auch Herkunft und zeitliche Erhebung bilden eigene Einteilungsachsen. Primärdaten werden für eine konkrete Untersuchung selbst erhoben, etwa durch Befragung, Beobachtung oder Messung. Sekundärdaten liegen bereits vor und werden für eine neue Fragestellung weiterverwendet. Entscheidend ist dabei die Quelle: Ein Datensatz kann inhaltlich passend sein, aber mit einer anderen Definition, Grundgesamtheit oder Erhebungsmethode entstanden sein.
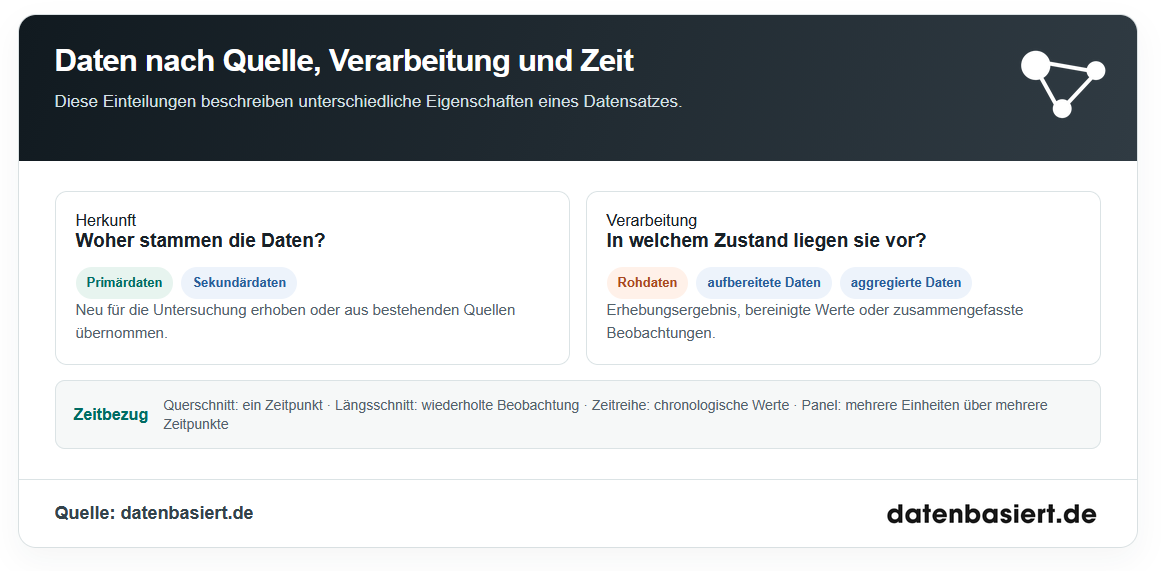
Nach der Verarbeitung unterscheidet man Rohdaten von aufbereiteten oder aggregierten Daten. Rohdaten entsprechen dem dokumentierten Erhebungsergebnis; aufbereitete Daten wurden zum Beispiel bereinigt, vereinheitlicht oder umcodiert. Aggregierte Daten fassen einzelne Beobachtungen zusammen, etwa als Monatsmittel oder Gruppensumme. Für die Analyse sollte nachvollziehbar bleiben, welche Transformationen vorgenommen wurden.
Der Zeitbezug trennt Querschnittsdaten, die Merkmale zu einem bestimmten Zeitpunkt abbilden, von Längsschnittdaten, die dieselben Untersuchungseinheiten wiederholt erfassen. Zeitreihendaten ordnen Beobachtungen chronologisch, häufig in regelmäßigen Abständen. Paneldaten verbinden beide Perspektiven: Mehrere Einheiten werden über mehrere Zeitpunkte hinweg beobachtet. Diese Kategorien beschreiben Erhebung und Aufbau; sie können mit quantitativen, strukturierten oder personenbezogenen Daten zusammenfallen.
Analoge und digitale Daten
Analog und digital beschreiben, wie Signale oder Werte dargestellt und verarbeitet werden. Ein analoges Signal kann sich kontinuierlich über die Zeit oder innerhalb eines Wertebereichs verändern. Digitale Systeme speichern und verarbeiten Informationen als diskrete Zustände, in Computern meist binär codiert.
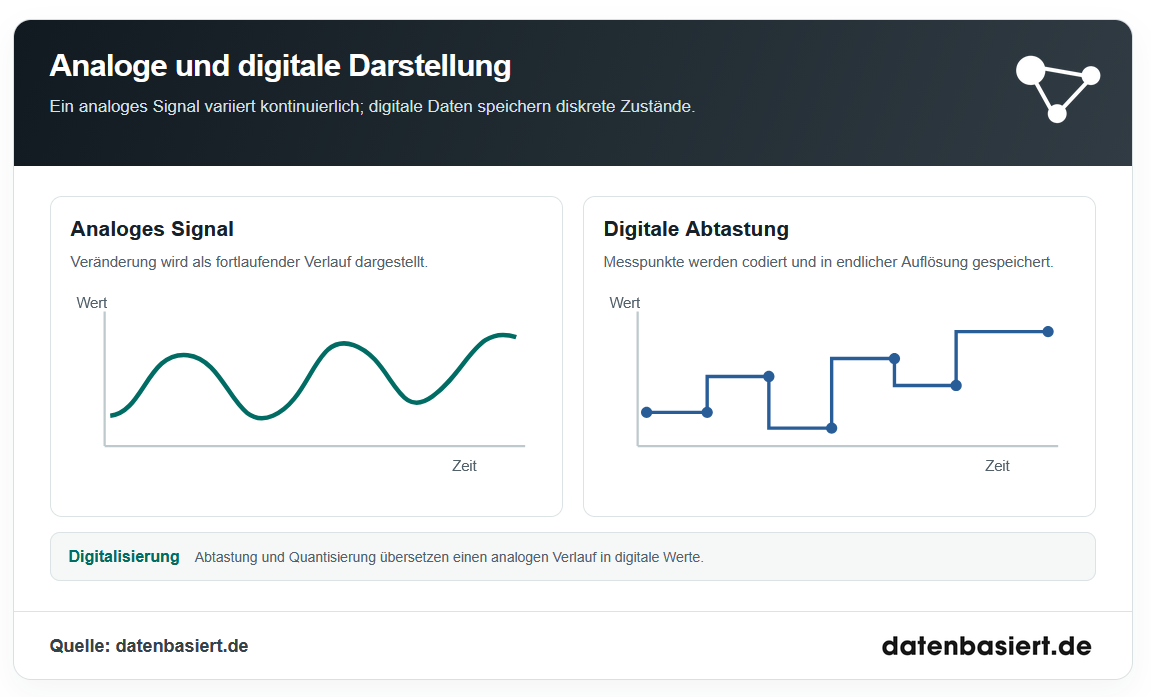
Bei der Digitalisierung wird ein analoger Verlauf abgetastet und in Zahlenwerte übersetzt. Abtastrate und Auflösung beeinflussen, wie genau sich der ursprüngliche Verlauf digital darstellen lässt. Analoge und digitale Daten sind damit nicht zwei verschiedene Bedeutungen von Information, sondern unterschiedliche Repräsentationen.
Digitale Daten können kontinuierliche Vorgänge abbilden, aber die gespeicherte Darstellung ist endlich genau. Ebenso bedeutet ein analoger Datenträger nicht, dass jede darauf notierte Information mathematisch stetig wäre. Repräsentationsform und Datentyp müssen getrennt beurteilt werden.
Beispiel: Ein digitaler Kassenbon als mehrere Datenarten
Ein Foto eines Kassenbons zeigt, wie mehrere Einteilungen gleichzeitig auf denselben Vorgang zutreffen. Die Bilddatei ist digital und im Ausgangsformat unstrukturiert. Aufnahmezeitpunkt und technische Dateiinformationen sind Metadaten. Eine Texterkennung kann daraus einzelne Felder in strukturierte Daten überführen.
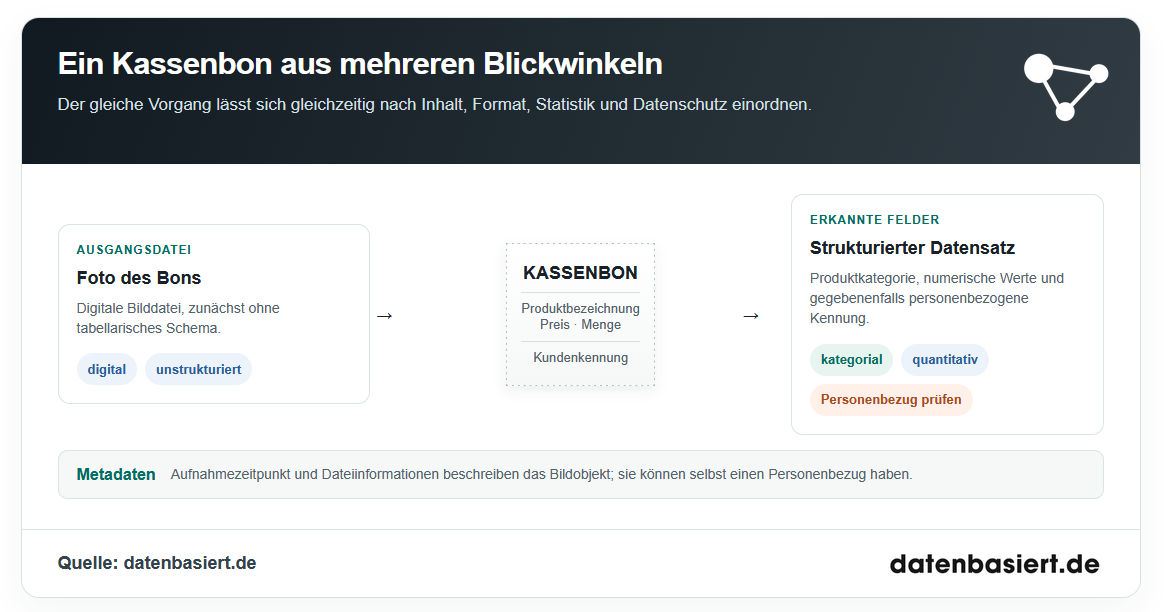
Die erkannten Produktbezeichnungen bilden Kategorien; Preise und Mengen enthalten numerische Werte. Enthält der Bon eine Kundenkennung oder lässt er sich über weitere Angaben einer Person zuordnen, können die betreffenden Daten personenbezogen sein. Eine abgetrennt verwahrte Kundenkennung kann den Datensatz pseudonymisieren, macht ihn aber nicht automatisch anonym.
Das Bild bleibt als Datei unstrukturiert, während extrahierte Felder zugleich strukturiert vorliegen können. Die Einordnung hängt also davon ab, ob die Bilddatei, erkannte Textfelder oder der gesamte Datensatz betrachtet werden.
Welche Datenart passt zur Analyse?
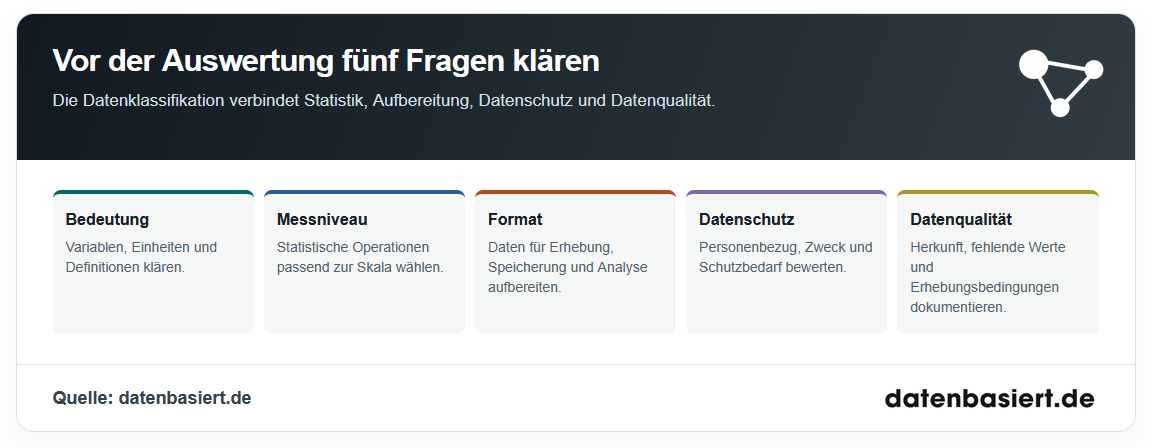
Vor der Auswertung sollten Daten aus mehreren Blickwinkeln geprüft werden. Die Forschungsfrage bestimmt, welche Merkmale benötigt werden. Das Skalenniveau begrenzt statistische Operationen; Format und Struktur bestimmen die Datenaufbereitung. Personenbezug beeinflusst den zulässigen Zugriff und die Schutzmaßnahmen.
Quelle: datenbasiert.de
Bei einer Datenanalyse ist es wichtig, Zahlencodes nicht mit Messwerten zu verwechseln und Kategorien nicht ohne Begründung numerisch zu verrechnen. Machine Learning benötigt ebenfalls passende Merkmalsrepräsentationen und eine dokumentierte Datenaufbereitung. Die Zuordnung entscheidet mit, welche Zusammenhänge ein Modell überhaupt lernen kann.
Für sensible Informationen muss die Datennutzung zusätzlich am Personenbezug und Zweck ausgerichtet werden. Bei Daten aus einer Datenanalyse mit KI sollten Herkunft, Definition und Verarbeitungsstufen nachvollziehbar bleiben. Eine passende Datenart-Einordnung erleichtert so die Auswahl von Methoden, Formaten und Schutzmaßnahmen.


