
Definition
Deep Learning ist ein Teilgebiet des maschinellen Lernens, in dem tiefe künstliche neuronale Netze aus Daten trainiert werden. Mehrere Verarbeitungsschichten bilden aus Eingaben gelernte Repräsentationen, die für Klassifikation, Vorhersage oder Generierung genutzt werden. Die Tiefe bezieht sich auf diese Schichten, nicht auf ein menschliches Verständnis der Daten.
Einordnung in Machine Learning
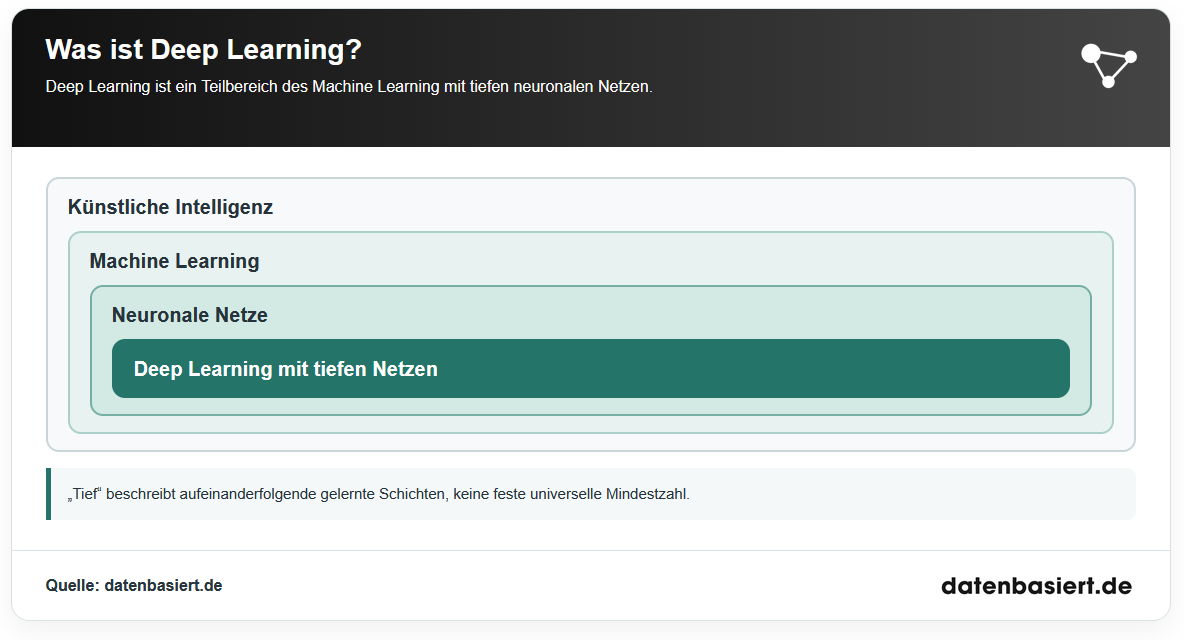
Beim Machine Learning lernt ein Modell aus Beispieldaten statt seine gesamte Entscheidungslogik als feste Regeln vorgegeben zu bekommen. Deep Learning verwendet dafür mehrschichtige neuronale Netze. Andere Verfahren des maschinellen Lernens, etwa Entscheidungsbäume und Random Forests, lernen ebenfalls aus Daten, besitzen aber eine andere Modellstruktur.
Deep Learning liegt damit innerhalb von Machine Learning; dieses wiederum gehört zur künstlichen Intelligenz. Nicht jede KI-Anwendung enthält ein tiefes Netz. Auch ein trainiertes Modell arbeitet nur für die Aufgaben und Eingaben, für die Architektur, Daten und Lernziel geeignet sind.
Unterschied zu neuronalen Netzen
Ein künstliches neuronales Netz verbindet Recheneinheiten über trainierbare Gewichte und Aktivierungsfunktionen. Deep Learning bezeichnet die Nutzung und das Training solcher Netze mit mehreren Verarbeitungsebenen. Wie viele Schichten ein Modell „tief“ machen, ist keine universelle feste Grenze; wichtiger ist, dass das Netz mehrere aufeinanderfolgende Repräsentationen lernt.
Ein kurzes Netz kann ebenso ein neuronales Netz sein, ohne dass jeder es als Deep Learning bezeichnen würde. Die Grundbegriffe Knoten, Gewichte, Bias und Aktivierung werden im Artikel über neuronale Netze ausführlicher erklärt.
Quelle: datenbasiert.de
Aufbau eines Deep-Learning-Modells
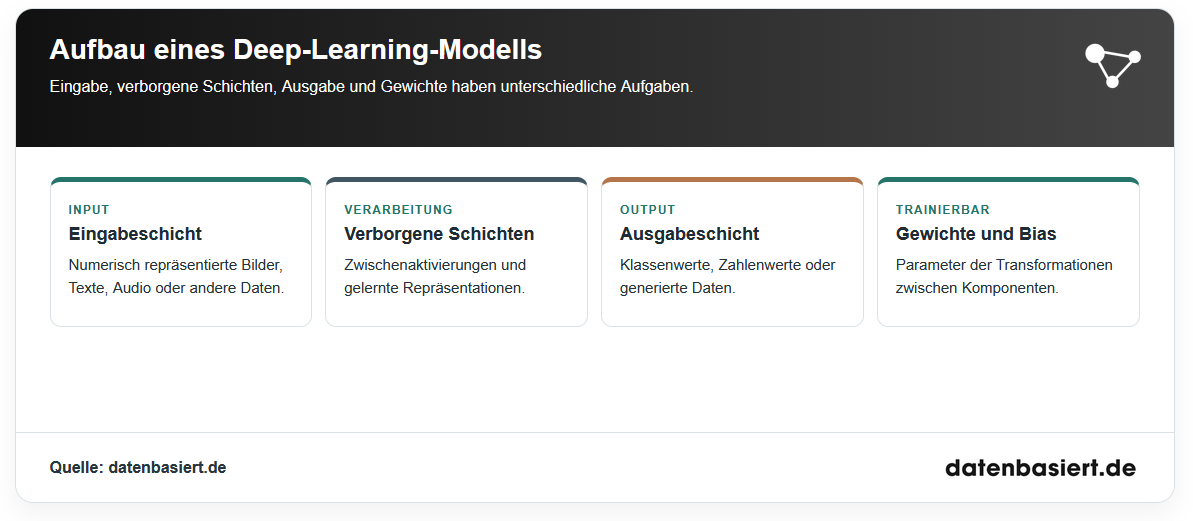
Ein Deep-Learning-Modell verarbeitet Eingaben über eine Eingabeschicht, mehrere verborgene Schichten und eine Ausgabeschicht. Trainierbare Gewichte, Bias-Werte und weitere Parameter bestimmen die Transformationen zwischen den Schichten. Welche Verbindungen möglich sind, legt die Architektur des Netzes fest.
Eingabeschicht
Die Eingabeschicht übernimmt numerisch dargestellte Daten. Bilder werden als Pixelwerte in Tensoren verarbeitet; Text benötigt zunächst eine Tokenisierung und eine numerische Repräsentation; Audiosignale werden in geeignete Abschnitte oder Merkmalsformen überführt. Die Vorverarbeitung muss bei Training und späterer Nutzung nach denselben Regeln erfolgen.
Die bloße Eingabe roher Daten löst das Problem der Datenqualität nicht. Auflösung, fehlende Werte, Zeichencodierung und Messbedingungen können bestimmen, welche Information das Modell überhaupt sieht.
Verborgene Schichten
Verborgene Schichten berechnen Zwischenwerte aus den Aktivierungen der vorherigen Verarbeitungsebene. Mehrere solcher Transformationen erlauben gelernte Repräsentationen unterschiedlicher Abstraktion. Je nach Architektur verarbeitet eine Schicht lokale Bildbereiche, zeitliche Zustände oder Beziehungen zwischen Positionen einer Eingabefolge.
Eine größere Zahl von Schichten vergrößert nicht automatisch die Vorhersagegüte. Verbindungen, Trainingsziel, Daten und Optimierung müssen zusammenpassen. Sehr tiefe Netze können außerdem schwieriger zu trainieren und teurer in der Inferenz sein.
Ausgabeschicht
Die Ausgabeschicht liefert Werte in einer Form, die zum Lernziel passt. Bei einer Klassifikation können mehrere Klassenwerte entstehen; bei einer Regression ein numerischer Wert. Generative Modelle liefern dagegen eine Folge neuer Tokens, Bildwerte oder andere erzeugte Daten. Die Interpretation hängt von der Ausgabefunktion und ihrer Kalibrierung ab.
Ein hoher Klassenscore ist ein Modellwert. Für eine verlässliche Wahrscheinlichkeitsangabe muss geprüft werden, ob Klassenwerte und tatsächlich beobachtete Häufigkeiten zusammenpassen.
Gewichte und Parameter
Gewichte bestimmen, wie stark Informationen zwischen Komponenten des Netzes wirken; Bias-Werte verschieben berechnete Aktivierungen. Zusammen bilden sie die trainierbaren Parameter. Auch Filter eines CNN oder Projektionsmatrizen eines Transformers enthalten solche Parameter. Beim Training werden sie angepasst; bei einer normalen Inferenz bleiben sie fest.
Millionen Parameter bedeuten nicht automatisch Millionen verständlicher Regeln. Die Bedeutung eines einzelnen Gewichts ergibt sich häufig erst aus seinem Zusammenspiel mit anderen Schichten und Eingaben.
Quelle: datenbasiert.de
Funktionsweise
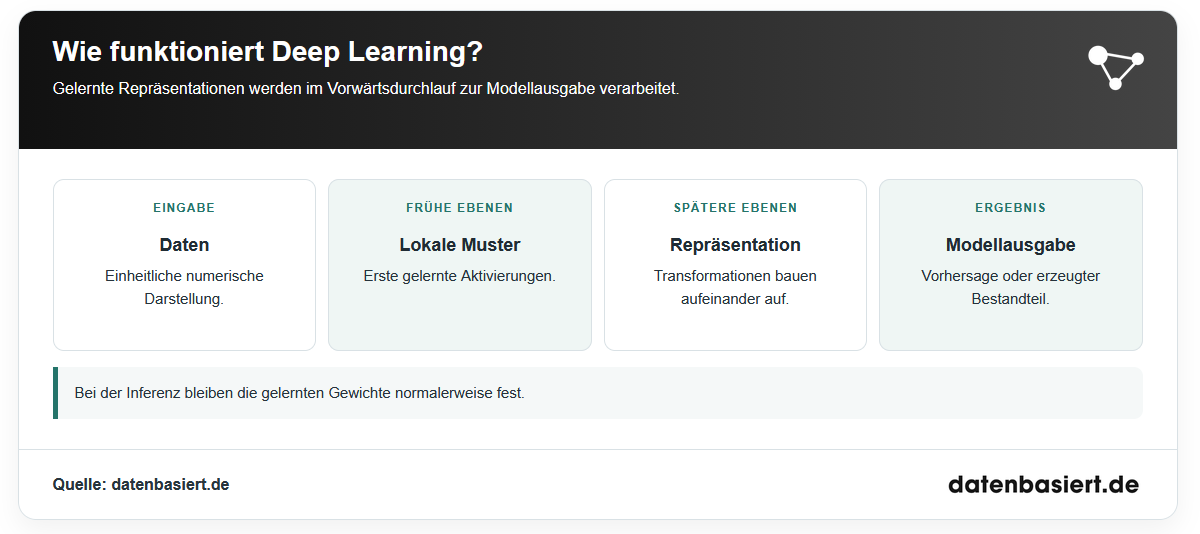
Deep Learning verarbeitet eine Eingabe schrittweise durch ein trainiertes Netz. Jede Schicht wandelt vorhandene Aktivierungen in neue Werte um; die Ausgabeschicht liefert die Vorhersage oder einen Teil der generierten Ausgabe. Diese Berechnung bei festen Parametern heißt Inferenz.
Hierarchische Merkmale
Hierarchisches Repräsentationslernen bedeutet, dass spätere Schichten auf Zwischenwerten früherer Schichten aufbauen. Das Modell muss nicht für jede Aufgabe ausschließlich von Menschen festgelegte Merkmale erhalten. Es lernt aus Daten Transformationen, die dem Trainingsziel dienen. Welche Eigenschaften tatsächlich erfasst werden, hängt von Eingaben und Architektur ab.
Die Formulierung „automatische Merkmalsextraktion“ bedeutet nicht, dass ein Netz von selbst die fachlich richtigen Daten auswählt. Labels, Zieldefinition, Vorverarbeitung und die Qualität der Trainingsfälle bleiben entscheidend.
Vorwärtsdurchlauf
Beim Vorwärtsdurchlauf fließen die numerischen Eingabewerte durch die aufeinanderfolgenden Rechenoperationen zur Ausgabe. Eine Schicht kombiniert vorhandene Werte mit ihren Parametern und reicht das Ergebnis nach einer passenden Transformation weiter. Der genaue Rechenweg ist bei einem CNN, RNN und Transformer unterschiedlich; das Prinzip der Berechnung einer Ausgabe aus Eingabe und Parametern bleibt.
Der Vorwärtsdurchlauf findet sowohl im Training als auch in der Anwendung statt. Nur beim Training folgt auf die berechnete Ausgabe die Bewertung gegen ein Lernziel und eine Aktualisierung der Parameter.
Aktivierungsfunktionen
Aktivierungsfunktionen bringen nichtlineare Beziehungen in das Modell. Würden Schichten nur lineare Transformationen ohne passende Nichtlinearität hintereinanderschalten, ließe sich ihre Zusammensetzung wieder als eine lineare Transformation ausdrücken. ReLU ist eine verbreitete Aktivierung in verborgenen Schichten; Ausgabeschichten nutzen Funktionen, die zum Zieltyp passen.
Nicht jedes Modul eines modernen Netzes besteht aus derselben simplen Neuronformel. Aufmerksamkeit, Normalisierung und Residualverbindungen ergänzen die Rechenoperationen vieler Architekturen.
Inferenz
Inferenz ist die Anwendung des trainierten Modells auf neue Eingaben, ohne die Gewichte bei jeder normalen Vorhersage neu zu lernen. Die Eingabe durchläuft die zuvor festgelegte Vorverarbeitung und den Vorwärtsdurchlauf. Inferenz kann auch bei großen Modellen Rechenzeit und Speicher benötigen, besonders wenn Ausgaben schrittweise erzeugt werden.
Ob die Vorhersage für neue Fälle brauchbar ist, ergibt sich aus einer Prüfung mit Daten, die nicht zur Parameterauswahl oder Anpassung verwendet wurden.
Quelle: datenbasiert.de
Training
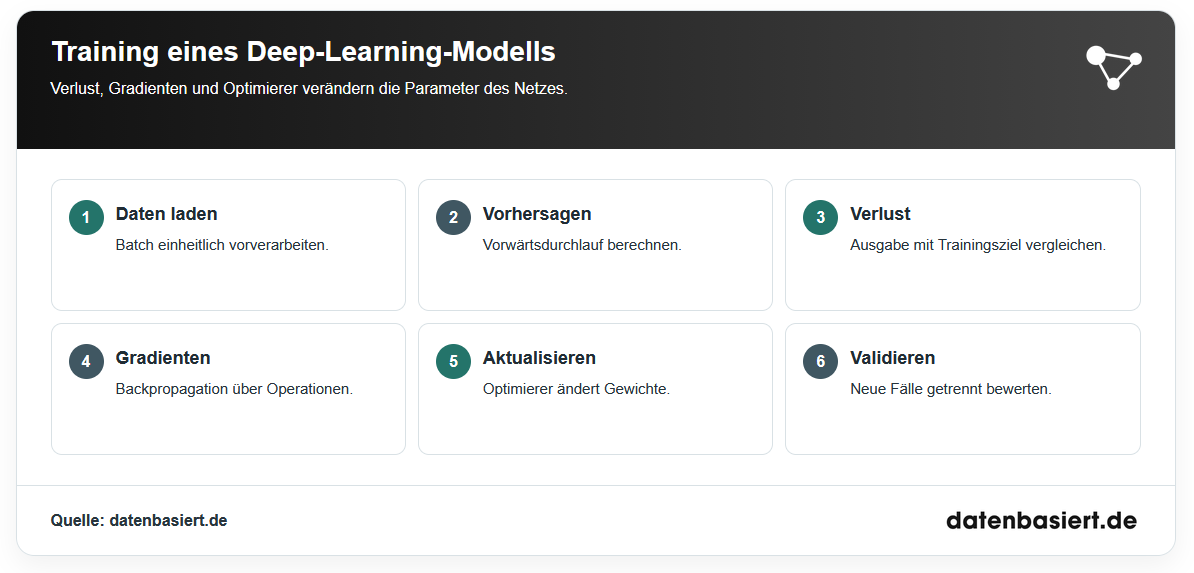
Beim Training passt ein Deep-Learning-Verfahren die Parameter des Netzes an, damit seine Ausgabe besser zum definierten Lernziel passt. Ein Durchlauf berechnet zunächst die Vorhersage, dann den Verlust und schließlich Gradienten für eine Aktualisierung. Viele solcher Schritte verändern das Modell, bis die gewählte Trainingsprozedur endet.
Verlustfunktion
Eine Verlustfunktion, auch Loss-Funktion genannt, übersetzt die Abweichung zwischen Modellausgabe und Trainingsziel in einen Wert für die Optimierung. Für Klassen, Zahlenwerte oder generative Aufgaben werden unterschiedliche Ziele definiert. Ein sinkender Trainingsverlust bedeutet, dass das Modell die Trainingsdaten besser trifft; er allein sagt wenig über unbekannte Fälle.
Bei überwachten Aufgaben stammen die Ziele aus Labels oder Messwerten. Andere Trainingsverfahren lernen auch aus unbeschrifteten Daten, etwa indem Teile der Eingabe rekonstruiert oder spätere Bestandteile vorhergesagt werden.
Backpropagation
Backpropagation berechnet mit der Kettenregel, wie Änderungen trainierbarer Parameter den Verlust beeinflussen. Dafür werden die im Vorwärtsdurchlauf entstandenen Zwischenwerte verwendet. Die berechneten Gradienten laufen rechnerisch von der Ausgabe durch die beteiligten Operationen zurück; die Eingabedaten werden dadurch nicht rückwärts „gelesen“.
Gradientenabstieg
Ein Optimierer nutzt die Gradienten, um Gewichte in Richtung eines niedrigeren Verlusts zu verändern. Stochastischer Gradientenabstieg und Adam sind verbreitete Optimierungsverfahren. Die Lernrate legt wesentlich fest, wie groß ein Aktualisierungsschritt ist. Zu große Schritte können das Training instabil machen; zu kleine Schritte verlängern es.
Weitere Entscheidungen wie Initialisierung, Regularisierung und Normalisierung beeinflussen, ob ein tiefes Netz zuverlässig trainiert werden kann. Die konkrete Einstellung wird anhand der Validierung gewählt, nicht nach dem Trainingsverlust allein.
Batches und Epochen
Ein Batch ist eine Gruppe von Trainingsfällen, die gemeinsam einen Optimierungsschritt liefert. Eine Epoche bezeichnet einen Durchlauf durch die vorgesehenen Trainingsdaten. Kleinere oder größere Batches ändern Speicherbedarf und Verlauf der Gradienten. Die Anzahl der Epochen bestimmt, wie lange die Daten wiederholt genutzt werden.
Wenn die Validierungsleistung trotz sinkenden Trainingsverlusts schlechter wird, kann Early Stopping das Training beenden. So wird das Modell anhand unabhängigerer Rückmeldungen ausgewählt.
- Trainingsdaten laden und nach derselben Regel vorverarbeiten.
- Im Vorwärtsdurchlauf eine Modellausgabe berechnen.
- Den Verlust gegenüber dem Lernziel bestimmen.
- Gradienten per Backpropagation berechnen.
- Parameter mit einem Optimierer aktualisieren.
- Den Verlauf auf Validierungsdaten beobachten.
Quelle: datenbasiert.de
Deep-Learning-Architekturen
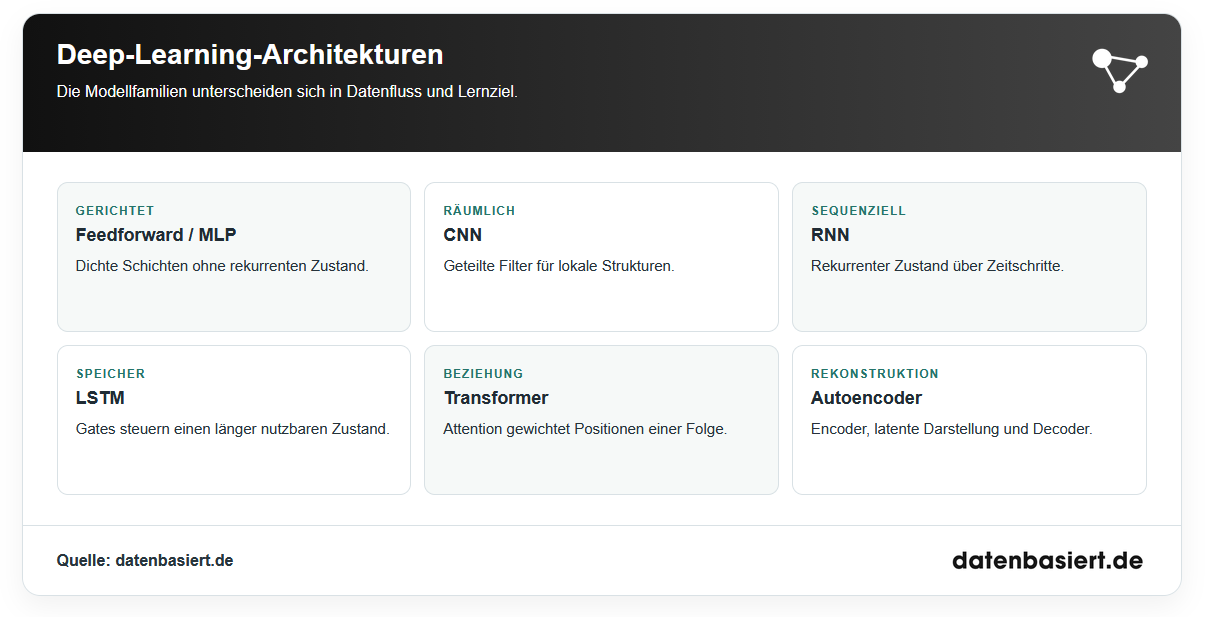
Deep-Learning-Architekturen unterscheiden sich darin, welche Verbindungen, Rechenoperationen und Datenfolgen sie verarbeiten. Feedforward-Netze, CNNs, RNNs, LSTMs, Transformer und Autoencoder verwenden trainierbare Schichten für unterschiedliche Aufgaben. Die Architektur wird nach Eingabeform und Lernziel gewählt.
Feedforward-Netze
Ein Feedforward-Netz berechnet seine Ausgabe entlang eines gerichteten Datenflusses ohne rekurrenten Zustand. Ein mehrschichtiges Perzeptron (MLP) verwendet dafür mehrere trainierbare Schichten mit Aktivierungen. Bei tabellarischen Daten kann ein solches Netz sinnvoll sein; die Güte sollte gegen einfachere Lernverfahren auf denselben Testfällen geprüft werden.
Convolutional Neural Networks (CNN)
Ein CNN nutzt Faltungsfilter, deren Gewichte an verschiedenen Positionen einer Eingabe gemeinsam verwendet werden. Dadurch kann es lokale Muster verarbeiten, ohne für jede Bildposition unabhängige Filter zu lernen. Mehrere Schichten bilden aufeinander aufbauende räumliche Repräsentationen. CNNs werden häufig für Bildklassifikation, Objekterkennung und Segmentierung eingesetzt.
Recurrent Neural Networks (RNN)
Ein RNN verarbeitet geordnete Eingaben Schritt für Schritt. Sein Zustand enthält Informationen aus vorherigen Schritten und beeinflusst die nächste Berechnung. Das macht rekurrente Netze für Sequenzen geeignet. Bei langen Abhängigkeiten kann das Training einfacher RNNs jedoch schwierig werden, weil Gradienten beim Rückfluss durch viele Schritte klein oder groß werden.
Long Short-Term Memory (LSTM)
Ein LSTM ist eine rekurrente Architektur mit einem kontrollierten Speicherzustand. Gates bestimmen, welche Information übernommen, behalten oder für die Ausgabe genutzt wird. So lassen sich manche längerfristigen Beziehungen in Sequenzen besser verarbeiten als mit einem einfachen RNN. LSTM und RNN gehören eng zusammen, sind aber nicht dieselbe Architektur.
Transformer
Ein Transformer nutzt Attention-Mechanismen, damit Positionen einer Eingabefolge Informationen von anderen Positionen gewichten können. Positionsinformationen machen dabei die Reihenfolge zugänglich. Diese Architektur trägt viele große Sprachmodelle und wird auch für Bild-, Audio- und multimodale Daten verwendet. Je nach Modell unterscheiden sich Encoder, Decoder und Trainingsziel.
Das Attention-Muster ist eine berechnete Modellkomponente. Eine einzelne Attention-Gewichtung erklärt nicht schon vollständig, warum ein Modell eine Ausgabe erzeugt hat.
Autoencoder
Ein Autoencoder bildet eine Eingabe über einen Encoder in eine latente Repräsentation ab und versucht mit einem Decoder, sie zu rekonstruieren. Das Rekonstruktionsziel kann die Struktur der Eingaben erfassbar machen. Varianten unterscheiden sich stark: Ein gewöhnlicher Autoencoder ist nicht automatisch ein gutes generatives Modell, während ein Variational Autoencoder eine probabilistische latente Struktur trainiert.
| Architektur | Kennzeichen | Typische Eingabe |
|---|---|---|
| Feedforward / MLP | Gerichtete Verarbeitung durch dichte Schichten | Numerische Merkmale |
| CNN | Geteilte lokale Filter | Bilder und räumliche Daten |
| RNN | Rekurrenter Zustand | Geordnete Sequenzen |
| LSTM | Gesteuerter Speicherzustand | Längere Sequenzen |
| Transformer | Attention und Positionsinformationen | Tokens und multimodale Folgen |
| Autoencoder | Encoder und Decoder mit Rekonstruktion | Daten zur Repräsentationsbildung |
Quelle: datenbasiert.de
Beispiel
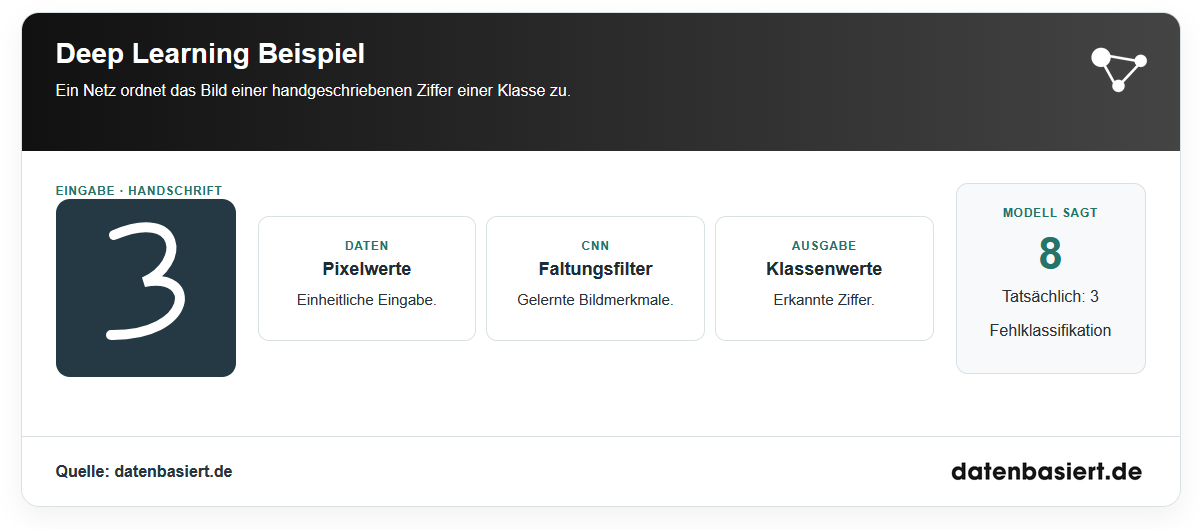
Ein Deep-Learning-Modell soll handgeschriebene Ziffern auf digitalisierten Briefumschlägen erkennen. Die Bilddaten werden einheitlich vorbereitet, ein CNN verarbeitet sie über mehrere Schichten und die Ausgabeschicht liefert Klassenwerte für die Ziffern. An diesem einen Fall lassen sich Merkmalslernen, Training und Prüfung zusammenhängend verfolgen.
Bilddaten als Eingabe
Jedes Bild enthält einen Ausschnitt mit einer einzelnen handgeschriebenen Ziffer und erhält im Training das passende Label. Die Pixelwerte werden in ein einheitliches numerisches Format überführt. Die Aufteilung in Trainings-, Validierungs- und Testdaten erfolgt so, dass keine nahezu identischen Aufnahmen desselben Originals in verschiedenen Gruppen landen.
Die Vorbereitung darf die spätere Anwendung nicht vereinfachen, indem sie Informationen aus dem Testdatensatz nutzt. Auch unscharfe oder schlecht belichtete Ausschnitte gehören zur Prüfung, wenn solche Bilder im tatsächlichen Posteingang auftreten.
Merkmale in den Schichten
Frühe Faltungsschichten reagieren auf lokale Kanten, Krümmungen und Kontraste der Bilddaten. Spätere Schichten kombinieren gelernte Zwischenwerte. Das Netz erhält keine von Menschen fertig formulierte Regel für jede Schreibweise der Ziffer. Es passt seine Filter so an, dass die Ausgabewerte der beschrifteten Trainingsbilder besser zu ihren Labels passen.
Diese Beschreibung ist eine Veranschaulichung des Lernprinzips. Ob bestimmte Filter tatsächlich einen gewünschten Bildbestandteil kodieren, muss am trainierten Modell untersucht werden.
Vorhersage und Prüfung
Für ein neues Bild berechnet der Vorwärtsdurchlauf Klassenwerte. Angenommen, die Ausgabe bevorzugt „8“, während das echte Label „3“ lautet: Der Fall ist eine Fehlklassifikation. Eine Konfusionsmatrix über viele Testbilder zeigt, welche Ziffern das Modell regelmäßig verwechselt. Entscheidend ist die Leistung auf Bildern, die zuvor nicht zur Anpassung verwendet wurden.
Wenn auf schlecht belichteten Briefen besonders viele Fehler auftreten, ist eine Gesamtquote allein zu grob. Die Testfälle werden nach Aufnahmequalität aufgeschlüsselt. So wird sichtbar, ob zusätzliche passende Trainingsdaten oder eine andere Vorverarbeitung den konkreten Einsatz verbessern.
Quelle: datenbasiert.de
Anwendungen
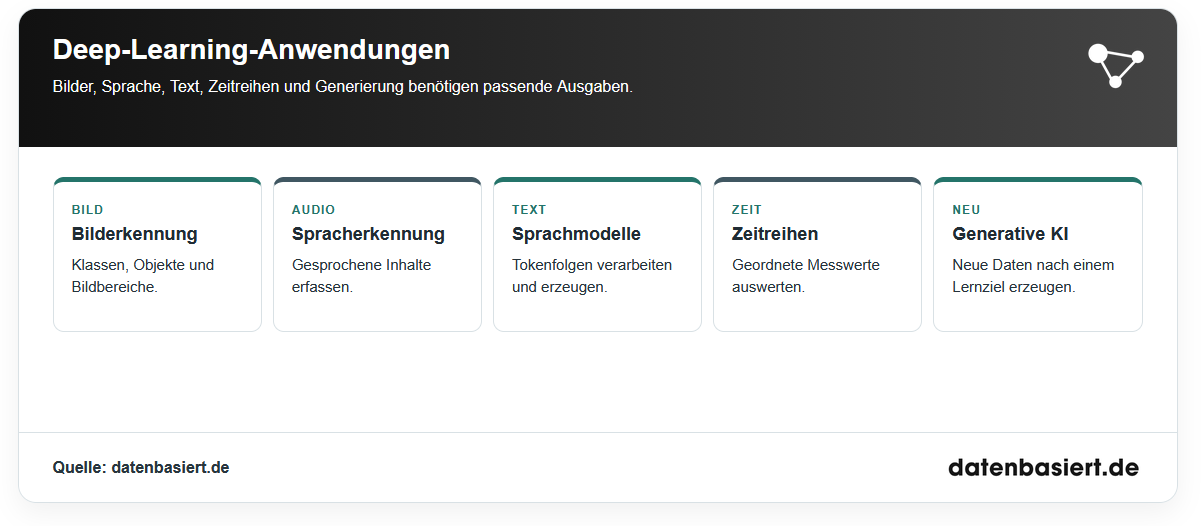
Deep Learning wird für Bild-, Sprach-, Text- und Zeitreihendaten sowie für die Generierung neuer Inhalte eingesetzt. Die Ausgabe kann eine Klasse, ein erkannter Abschnitt, eine numerische Prognose oder ein erzeugter Datenbestandteil sein. Anwendung und Zielgröße müssen vor dem Training eindeutig feststehen.
Bilderkennung
Bei der Bilderkennung verarbeitet ein Modell Pixelwerte, um Bildklassen, Objekte oder einzelne Bildbereiche zu bestimmen. Bildklassifikation gibt eine Kategorie für eine Eingabe aus; Objekterkennung lokalisiert zusätzlich Bereiche; Segmentierung ordnet Bildbereiche oder Pixel Kategorien zu. Diese Aufgaben verlangen unterschiedliche Labels und Ausgabestrukturen.
Spracherkennung
Spracherkennung wandelt Audiodaten in sprachliche Einheiten oder geschriebenen Text um. Schwankungen durch Aufnahmegerät, Akzent, Sprechtempo und Hintergrundgeräusche beeinflussen die Aufgabe. Sprachsynthese verfolgt die andere Richtung und erzeugt ein Audiosignal aus vorgegebenen Informationen. Die beiden Ziele sollten bei der Bewertung getrennt bleiben.
Sprachmodelle
Sprachmodelle lernen statistische Beziehungen zwischen Tokens und generieren oder bewerten Textfolgen. Transformer ermöglichen die Verarbeitung vieler Beziehungen innerhalb eines Kontextfensters. Ein flüssiger Text belegt nicht automatisch, dass jede enthaltene Tatsachenbehauptung richtig ist; für wissensbasierte Anwendungen gehört eine inhaltliche Prüfung zur Nutzung.
Zeitreihen
Bei Zeitreihen werden zeitlich geordnete Messwerte für Klassifikation, Anomalieerkennung oder eine spätere Prognose genutzt. Eine seriöse Prüfung wahrt die zeitliche Reihenfolge und vergleicht das Modell mit einer einfachen Referenz. Der Vorhersagehorizont und die zum Entscheidungszeitpunkt verfügbaren Merkmale müssen zum Einsatzzweck passen. Mehr zur Zeitreihenanalyse.
Generative KI
Generative Modelle erzeugen neue Texte, Bilder, Audio oder andere Daten. Trainingsziele und Verfahren unterscheiden sich von einer reinen Klassifikation: Ein Sprachmodell schätzt etwa die nächste Tokenverteilung, während andere Modelle latente Variablen oder schrittweise Änderungen eines Signals lernen. Die Ausgabe wird nach passenden Qualitäts- und Sicherheitskriterien geprüft.
Quelle: datenbasiert.de
Voraussetzungen
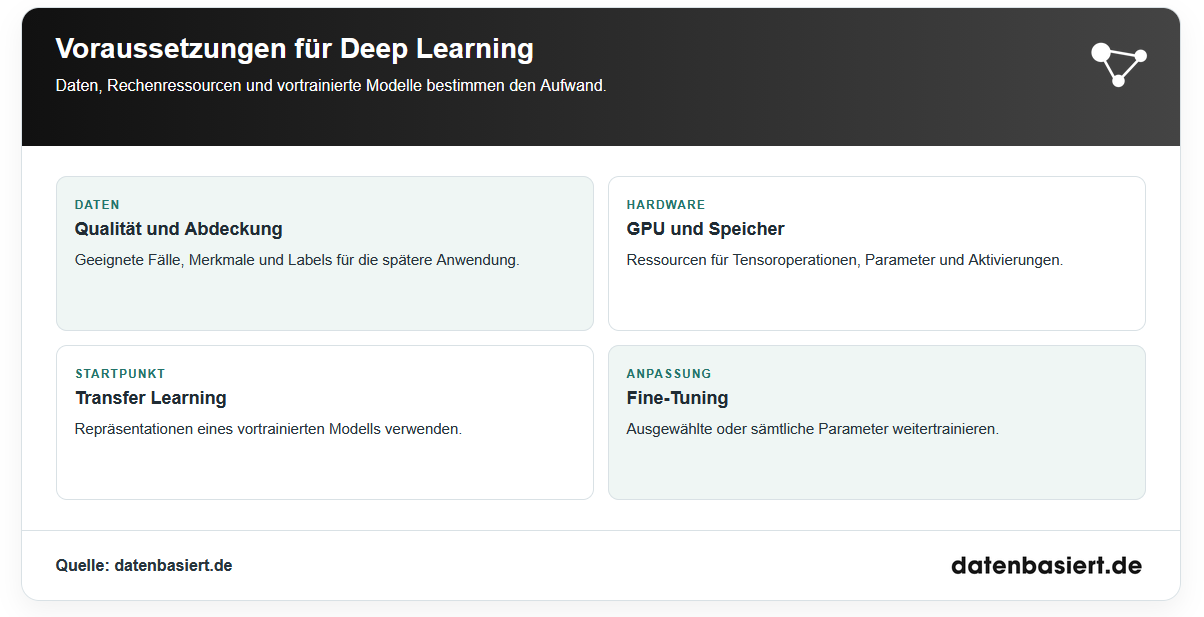
Deep Learning benötigt eine zum Lernziel passende Datenbasis, ausreichende Rechenressourcen und eine überprüfbare Trainingsstrategie. Für manche Aufgaben senken vortrainierte Modelle den Bedarf an neuem Training. Weder eine große Datenmenge noch eine leistungsfähige GPU behebt jedoch fehlerhafte Labels oder ungeeignete Zieldefinitionen.
Trainingsdaten und Datenqualität
Die Trainingsdaten müssen relevante Variationen des späteren Einsatzes abdecken. Bei überwachten Aufgaben sind außerdem verlässliche Labels erforderlich. Doppelte Fälle, ungleiche Erfassungsbedingungen und veränderte Merkmalsdefinitionen können die Modellbewertung verzerren. Datenqualität betrifft deshalb Herkunft, Repräsentativität und die Trennung von Training und Test.
Die oft wiederholte Aussage, Deep Learning brauche immer riesige eigene Datensätze, greift zu kurz. Datenbedarf hängt von Architektur, Aufgabe und Vortraining ab. Wenige eigene Fälle können für eine eng umrissene Anpassung genügen, wenn eine geeignete vortrainierte Repräsentation vorhanden ist; die Leistung auf neuen Fällen muss trotzdem gezeigt werden.
Rechenleistung und GPUs
Das Training tiefer Netze umfasst viele Matrix- und Tensoroperationen. GPUs beschleunigen zahlreiche dieser parallelen Berechnungen; je nach Modell kommen auch andere Beschleuniger zum Einsatz. Speicher für Parameter, Aktivierungen und Optimiererzustände begrenzt die mögliche Modell- und Batchgröße. Große Modelle verursachen zusätzlich Kosten im späteren Betrieb.
Rechenaufwand ist keine Kennzahl für fachliche Güte. Ein kleineres Modell kann für eine konkrete Aufgabe schneller, günstiger und ausreichend genau sein. Die benötigte Antwortzeit zählt ebenso wie die Trainingsdauer.
Transfer Learning
Transfer Learning nutzt Wissen aus einem zuvor trainierten Modell für eine neue Aufgabe. Ein vortrainierter Encoder kann Repräsentationen bereitstellen, auf denen eine neue Ausgabeschicht trainiert wird. So muss nicht jede Verarbeitungsebene von Anfang an aus den neuen Daten gelernt werden. Voraussetzung ist, dass Vortraining und neue Eingaben genügend relevante Gemeinsamkeiten besitzen.
Fine-Tuning
Beim Fine-Tuning werden Parameter eines vortrainierten Modells mit Daten der neuen Aufgabe weiter angepasst. Dabei können alle oder nur ausgewählte Teile trainierbar sein. Das unterscheidet sich vom bloßen Verwenden fester vortrainierter Repräsentationen. Lernrate, Datenmenge und Validierung bestimmen, wie weit die Anpassung gehen sollte.
Zu starke Anpassung kann bereits gelernte Fähigkeiten beeinträchtigen oder die wenigen neuen Trainingsfälle auswendig lernen. Der Erfolg wird daher auf getrennten Daten der neuen Aufgabe geprüft.
Quelle: datenbasiert.de
Modellbewertung
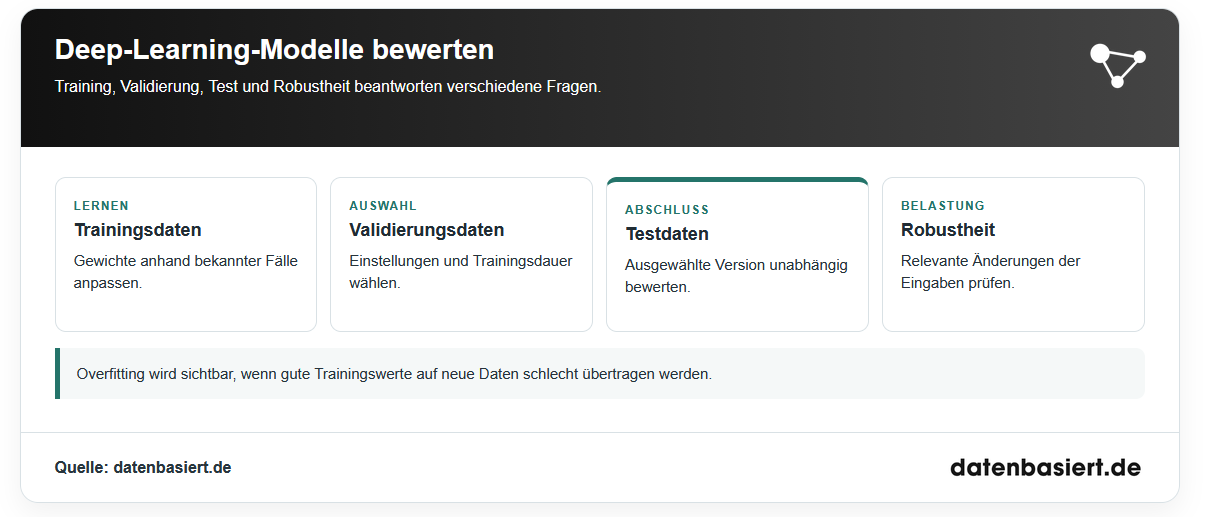
Ein Deep-Learning-Modell wird an zuvor nicht gelernten Daten und mit zur Aufgabe passenden Kennzahlen bewertet. Trainingswerte zeigen die Anpassung an bekannte Fälle; Validierung unterstützt die Modellauswahl; ein getrenntes Testset liefert die abschließende Prüfung. Zusätzlich zählen Robustheit und Leistung bei veränderten Eingaben.
Validierungsdaten
Validierungsdaten helfen bei der Wahl von Architektur, Lernrate, Trainingsdauer und anderen Einstellungen. Sie werden nicht für die gewöhnlichen Gewichtsaktualisierungen wie Trainingsbatches verwendet. Weil Entscheidungen wiederholt anhand derselben Validierung getroffen werden, ist ihre Leistung keine vollständig unabhängige Abschlussbewertung.
Testdaten
Testdaten werden erst für die Beurteilung des ausgewählten Modells verwendet. Die Aufteilung muss zur späteren Anwendung passen: Wiederholungen desselben Falls, dieselbe Person oder später erst verfügbare Information dürfen keine unbemerkten Abkürzungen zwischen den Gruppen erzeugen. Nur so beschreibt der Test die Generalisierung auf tatsächlich unbekannte Eingaben.
Overfitting
Overfitting liegt vor, wenn ein Modell Besonderheiten der Trainingsdaten erlernt, die auf neue Daten schlecht übertragbar sind. Eine wachsende Lücke zwischen Trainings- und Validierungsleistung ist ein Warnsignal. Regularisierung, Datenaugmentation, eine angepasste Modellgröße und Early Stopping können helfen; welche Maßnahme passt, zeigt der getrennte Vergleich.
Robustheit
Robustheit beschreibt, wie ein Modell auf veränderte, aber relevante Eingaben reagiert. Unterschiede durch Messgeräte, Bildqualität, Sprachvarianten oder zeitliche Verschiebungen können die Datenverteilung verändern. Eine Gesamtkennzahl wird daher um geeignete Teilgruppen, Stressprüfungen und eine Beobachtung der späteren Modellleistung ergänzt.
| Prüfbereich | Frage | Geeignete Beobachtung |
|---|---|---|
| Trainingsverlauf | Lernt das Modell das definierte Ziel? | Verlust und Kennzahl während des Trainings |
| Validierung | Welche Modellversion ist geeignet? | Leistung auf getrennten Validierungsfällen |
| Abschlusstest | Wie gut ist die ausgewählte Version? | Kennzahl auf zurückgehaltenen Testdaten |
| Robustheit | Bleibt die Leistung bei relevanten Änderungen erhalten? | Fehler nach Teilgruppen und Bedingungen |
Quelle: datenbasiert.de
Erklärbarkeit
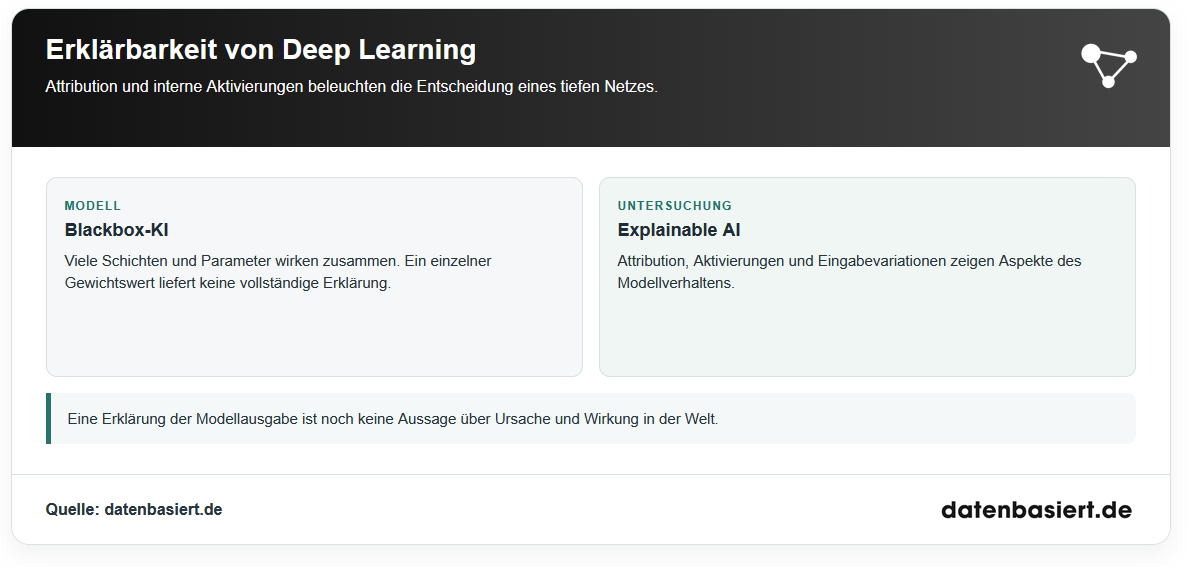
Die Erklärbarkeit von Deep Learning fragt, welche Eingaben und internen Repräsentationen zu einer Modellausgabe beitragen. Bei tiefen Netzen ist die Gesamtberechnung auf viele Schichten und Parameter verteilt. Einzelne Aktivierungen lassen sich untersuchen, ergeben aber nicht automatisch eine kurze, vollständige Begründung.
Blackbox-KI
Als Blackbox-KI bezeichnet man Modelle, deren konkrete Entscheidungen für Menschen schwer nachzuvollziehen sind. Bei tiefen Netzen können viele Parameter und nichtlineare Transformationen zusammenspielen. Dass Eingabe und Ausgabe sichtbar sind, beantwortet noch nicht, welche Teile des Rechenwegs die Entscheidung tragen.
Diese Schwierigkeit ist von der Vorhersagegüte zu trennen. Ein Modell kann auf Testdaten gute Kennzahlen erreichen und bei einzelnen Entscheidungen trotzdem schwer erklärbar sein.
Explainable AI
Explainable AI untersucht unter anderem Eingabeattribution, Aktivierungen, Gegenfaktualen und vereinfachte Ersatzmodelle. Die Verfahren beantworten unterschiedliche Fragen: Welche Eingabeteile beeinflussen einen bestimmten Score? Was verändert sich bei einer Variation? Welche Muster zeigen Zwischenschichten? Die Methode muss zur jeweiligen Architektur und Aussage passen.
Eine Erklärung des Modellverhaltens ist nicht gleichbedeutend mit einer kausalen Erklärung des untersuchten Sachverhalts. Auch ein anschauliches Wärmebild oder eine hervorgehobene Textstelle benötigt eine Prüfung, ob die Darstellung stabil und fachlich sinnvoll ist.
Quelle: datenbasiert.de
Fazit
Deep Learning trainiert tiefe neuronale Netze, damit mehrere Schichten aus Daten geeignete Repräsentationen und Ausgaben bilden. Architektur und Lernziel entscheiden, ob das Modell Bilder erkennt, Sprache verarbeitet, einen Zahlenwert schätzt oder neue Inhalte erzeugt. Die Leistung entsteht aus dem Zusammenspiel von Daten, Training und Prüfung, nicht allein aus der Zahl der Parameter.
Für die Auswahl eines Modells zählen ein klar definiertes Ziel, die Qualität der Trainingsdaten und der Vergleich auf neuen Fällen. Vortrainierte Netze können den Aufwand senken; GPUs können das Training beschleunigen. Testkennzahlen, Robustheit, Rechenkosten und Erklärbarkeit zeigen, ob die Lösung für ihren vorgesehenen Einsatz geeignet ist.
Quelle: datenbasiert.de


