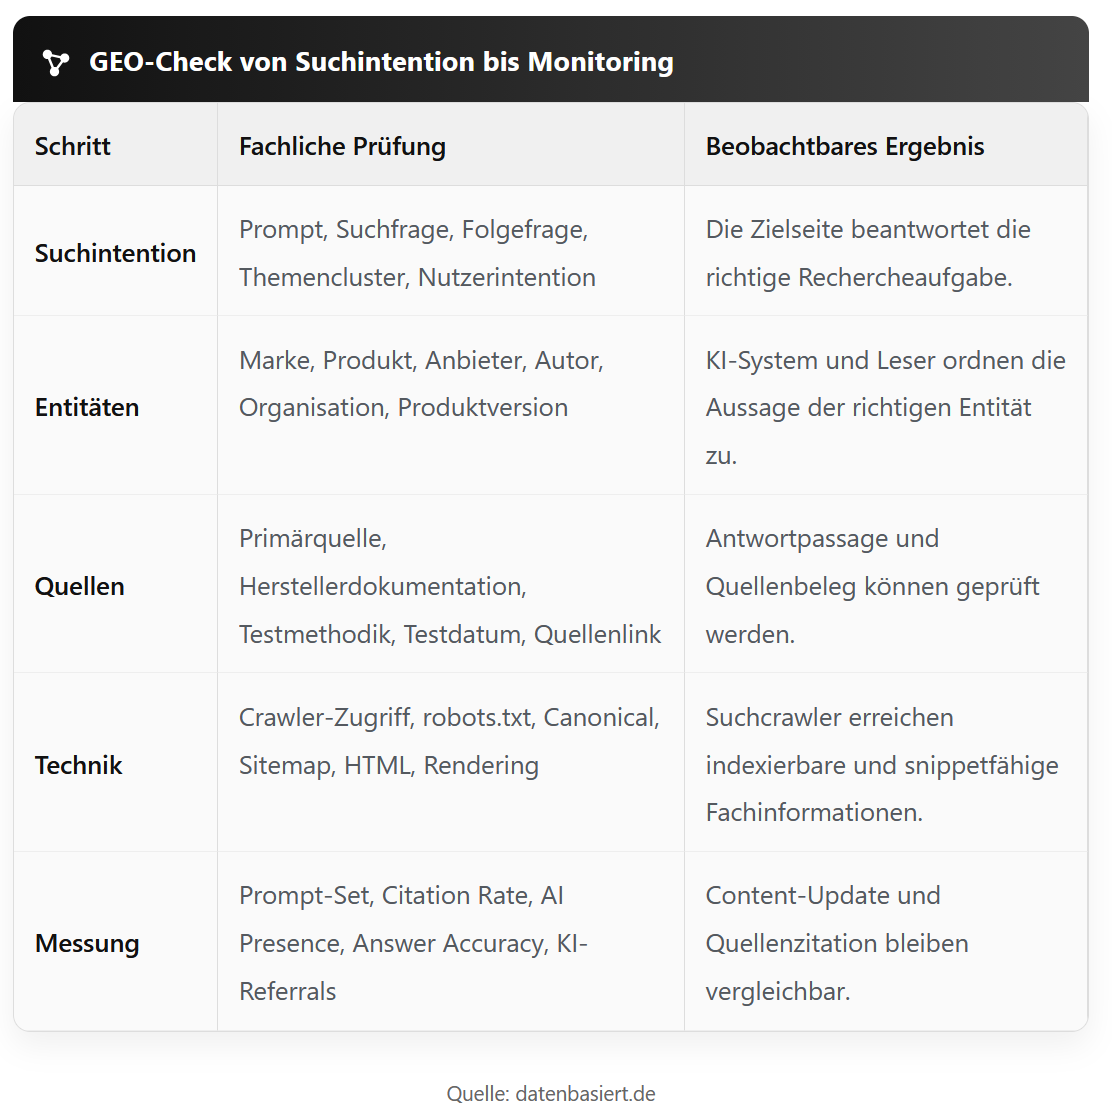
GEO-Optimierung sorgt dafür, dass deine Inhalte in KI-generierten Suchantworten besser sichtbar werden. Plattformen wie ChatGPT, Perplexity und Google AI Overviews wählen Quellen aus, verarbeiten Informationen und formulieren daraus eigene Antworten. Entscheidend ist deshalb nicht nur, ob deine Website als Quelle erscheint, sondern auch, wie deine Marke dargestellt wird und welche Inhalte die KI übernimmt. GEO setzt genau hier an: mit gezielter Content-Optimierung, technischen Grundlagen und der systematischen Analyse von KI-Antworten.
Klassische SEO bleibt die Grundlage: Suchintention, zugängliche URLs und interne Verlinkung helfen beim Auffinden relevanter Zielseiten. GEO ergänzt Prompt-Recherche, Quellenanalyse und Antwortprüfung. Dieser Ratgeber erklärt, wie Crawler-Zugriff, zitierfähige Antwortpassagen und Offpage-Signale zusammenarbeiten. Du erfährst außerdem, wie sich KI-Plattformen im Quellenmonitoring vergleichen lassen und welche GEO-KPIs Quellenpräsenz, Markennennungen sowie erkennbare KI-Referrals beschreiben.
Wenn du die SEO-Grundlagen auffrischen möchtest, findest du im SEO-Guide die Zusammenhänge zwischen Crawling, Indexierung und Suchrankings. Generative Engine Optimization lernen ergänzt den Einstieg; der Leitfaden zu SEO für ChatGPT vertieft die Optimierung für ChatGPT Search.
Was ist GEO-Optimierung?
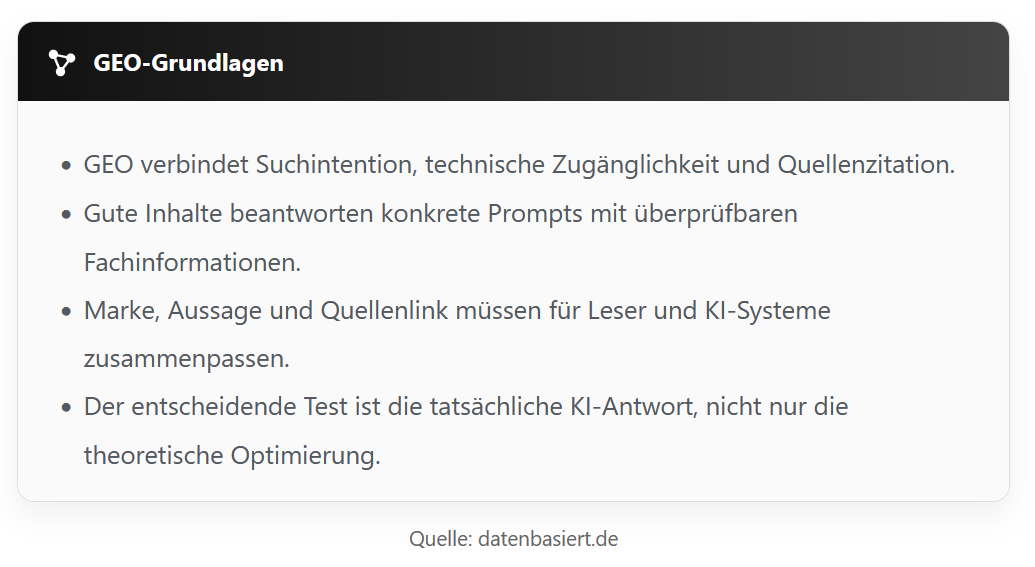
Bei der GEO-Optimierung geht es darum, Inhalte nicht nur für die Suche auffindbar zu machen, sondern auch ihre Verwendung in KI-generierten Antworten zu verbessern. Dafür betrachtet GEO die Suchintention, die Content-Relevanz und die Qualität der verwendeten Quellen im Zusammenhang mit den tatsächlichen Antworten. Wenn ChatGPT Search deine Website zitiert, ist das zunächst ein positives Signal.
Ob die Antwort wirklich hilfreich ist, hängt aber auch davon ab, ob der Quellenlink stimmt, deine Marke korrekt dargestellt wird und die enthaltenen Informationen sachlich richtig sind. Eine korrekte Quellenzitation schützt beispielsweise nicht davor, dass eine KI veraltete Lizenzkosten nennt. Deshalb werden mit Citation Rate, AI Presence und Answer Accuracy mehrere Kennzahlen benötigt, um die Sichtbarkeit und Antwortqualität sinnvoll zu bewerten.
Ein typischer Anwendungsfall ist z.B. die Suche nach passender SaaS-Software. Fragt jemand nach einem CRM mit einer bestimmten Schnittstelle, spielen neben dem Produktnamen auch Lizenzkosten, verfügbare Integrationen und Möglichkeiten zum Datenexport eine Rolle. Damit eine KI-Suche diese Informationen zuverlässig einordnen kann, braucht sie belastbare Quellen wie Herstellerdokumentationen und transparent dokumentierte Tests.
Diese Anforderungen lassen sich bereits bei der Content-Planung berücksichtigen. Während ein klassisches SEO-Briefing vor allem Keywords, Suchvolumen und Wettbewerber betrachtet, ergänzt GEO konkrete Nutzerfragen zu Integrationen, Datenmigration und weiteren Entscheidungskriterien. Diese Fragen lassen sich in einem Prompt-Cluster bündeln, das die Struktur einer Vergleichsseite mitbestimmt.
Werden Lizenzkosten, Schnittstellen und Testbedingungen dort klar und nachvollziehbar dargestellt, kann ein Retrieval-System passende Inhalte leichter abrufen. Idealerweise verweist die KI-Antwort über einen Quellenlink direkt auf die entsprechende Fachinformation.
Wie Modellwissen, Websuche und Quellenzitation zusammenhängen
Ein Large Language Model (LLM) nutzt Modellwissen aus dem Training, auch Foundational Model Knowledge genannt. Zum Trainingskorpus können aufbereitete Webdaten gehören; Common Crawl stellt solche Crawl-Daten bereit. Welche Trainingsdaten ein bestimmtes Sprachmodell verwendet, lässt sich daraus allein nicht ableiten. Trainingsbasierte Systeme antworten aus Modellwissen, suchbasierte Systeme rufen Webquellen ab; hybride Systeme verbinden beide Wege. Diese Einteilung beschreibt den jeweiligen Betrieb, keine feste Produkteigenschaft. Retrieval-Augmented Generation (RAG) ergänzt den Antwortkontext um externe Quellenbelege. Ein Content-Update verändert keine Trainingsdaten, kann aber über Web-Retrieval als aktualisierte Referenzseite verfügbar werden.
Zwischen Prompt und Quellenzitation bewertet das Suchsystem Relevanz und wählt Antwortpassagen aus. Komplexe Prompts können über Query Fan-out zusätzliche Suchanfragen auslösen. Beim CRM-Vergleich betreffen Teilabfragen etwa Schnittstellen, Datenexport und Migration. Eine Zielseite kann als Quellenbeleg für eine Teilfrage dienen, ohne den gesamten Softwarevergleich abzudecken.
Semantische Klarheit entsteht durch Kontextualisierung: Eine Antwortpassage zum Datenexport verbindet Produktname, Exportformat und Einschränkung. Bei Lizenzkosten gehören Lizenzmodell, Testzeitpunkt und Herstellerquelle zusammen. So bleiben Entitäten und Antwortkontext beim Quellenabruf zuordenbar. Für die Content-Planung bedeutet semantische Dichte, relevante Beziehungen präzise auszudrücken. Eine isolierte Preisangabe ohne Produktversion liefert trotz Fachbegriffen keinen verlässlichen Vergleichsmaßstab.



Warum eigene Informationen einen Unterschied machen
Commodity Content wiederholt Grundlagenwissen; Non-Commodity Content ergänzt Informationsgewinn, auch Information Gain genannt. Eine eigene GEO-Auswertung liefert beispielsweise Prompt-Set, Quellenzitationen und Vergleichsdaten. Dokumentierte Testmethodik verbindet Content-Updates mit Messbedingungen. Leser können Quellenprüfung und Quellenvergleich nachvollziehen und zwischen Primärquellen, Herstellerangaben und eigenen Beobachtungen unterscheiden. Der Mehrwert liegt im überprüfbaren Ergebnis, nicht in zusätzlichen Fachwörtern.
Answer Engine Optimization (AEO), Large Language Model Optimization (LLMO) und Generative AI Optimization (GAIO) überschneiden sich mit GEO. Während AEO direkte Antworten einschließlich Featured Snippets betrachtet, rückt LLMO die Verarbeitung durch Sprachmodelle in den Vordergrund. GAIO fasst Optimierung für generative KI breiter. KI-SEO und AI Visibility begegnen dir ebenfalls: Gemeint sind KI-Suchmaschinenoptimierung und KI-Sichtbarkeit. Für dein GEO-Audit zählt die konkrete Aufgabe: Suchintention prüfen, Quellenbelege sichern und Markenempfehlungen im Antwortkontext bewerten.
Vergleich GEO vs. SEO
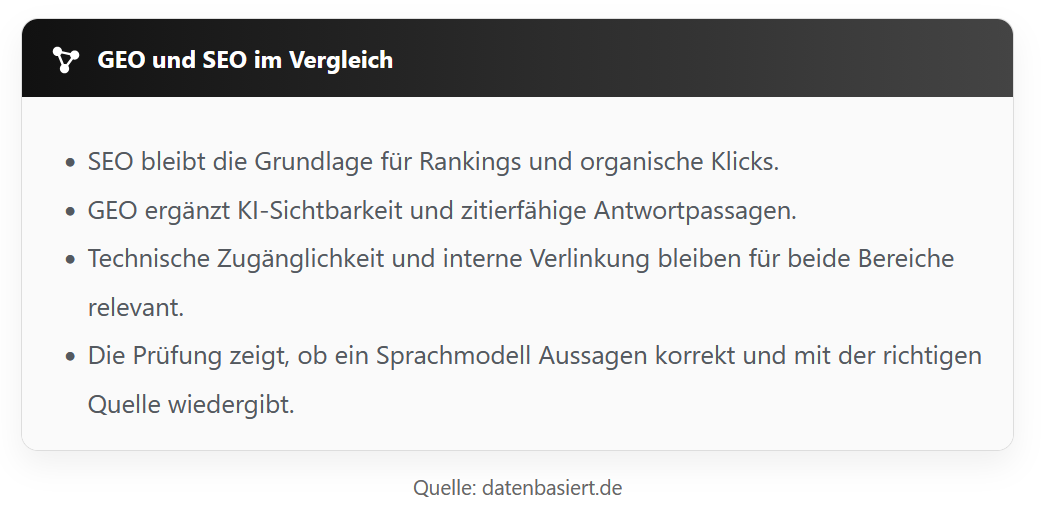
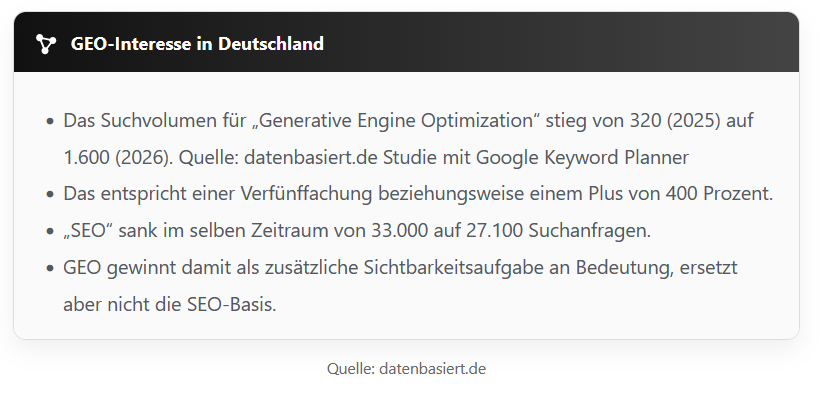
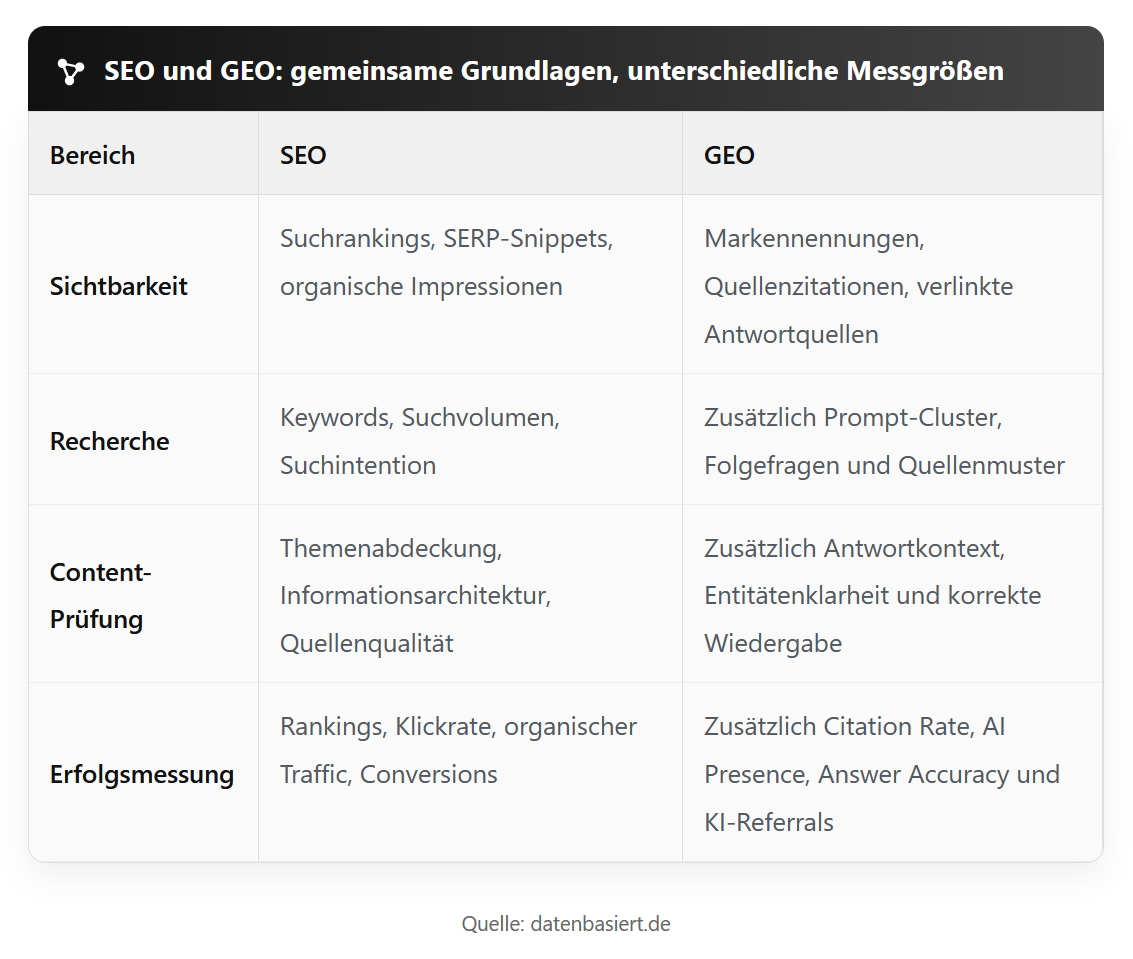
GEO ersetzt SEO nicht. Suchmaschinenoptimierung verbindet bereits Suchintention, Quellenqualität und Crawler-Zugriff. In der KI-Suche kommt eine Antwortgenerierung hinzu: Die KI-Zusammenfassung kann Fachinformationen mehrerer Domains verknüpfen und einzelne Quellenlinks anzeigen. Für die Content-Optimierung prüfst du deshalb neben Suchrankings auch Antwortpassagen und Quellenzitationen. Die Landingpage muss weiterhin liefern, was die Suchanfrage beziehungsweise KI-Empfehlung verspricht.
Verbinde SEO und GEO, trenne aber die Messgrößen. Suchrankings, Impressionen und Klickrate beschreiben klassische Suchergebnisse; Citation Rate und AI Presence beziehen sich auf dein Prompt-Set. Answer Accuracy prüft Markendarstellung und Fakten. Dokumentiere im GEO-Reporting Quellenlinks und Antwortkontext, um Quellenzitationen unabhängig vom Suchranking bewerten zu können.
Eine URL kann Antwortpassagen für mehrere Suchintentionen liefern: Die Vergleichstabelle behandelt Lizenzkosten, die Integrationsdokumentation Schnittstellen. Erfasse im Content-Audit Quellenzitation, Zielseite und zitierte Teilfrage. Beim Quellenabgleich prüfst du, ob Quellenbeleg und KI-Antwort dieselbe Produktversion betreffen.
Entitätenklarheit verbindet Markenname, Autorenprofil und Produktbezeichnung. Frühere Produktnamen brauchen eine nachvollziehbare Zuordnung zur aktuellen Produktdetailseite. Interne Links führen zur Referenzseite; das Quellenmonitoring kontrolliert Produktversion und Quellenzitation. Konsistente Markenangaben vermeiden Widersprüche zwischen Vergleichstabelle, Herstellerdokumentation und KI-Antwort.
Quellenpräsenz erzeugt nicht automatisch KI-Traffic. Eine KI-Zusammenfassung kann Definitionsfragen ohne Quellenklick beantworten. Für diesen Zero-Click-Effekt braucht die Landingpage einen sinnvollen Anschluss: Originaldaten, Testmethodik oder Integrationsdokumentation. Prüfe Quellenzitationen, KI-Referrals und Conversions getrennt, damit Linkeinblendungen nicht als Website-Besuche gezählt werden.
Query Fan Out
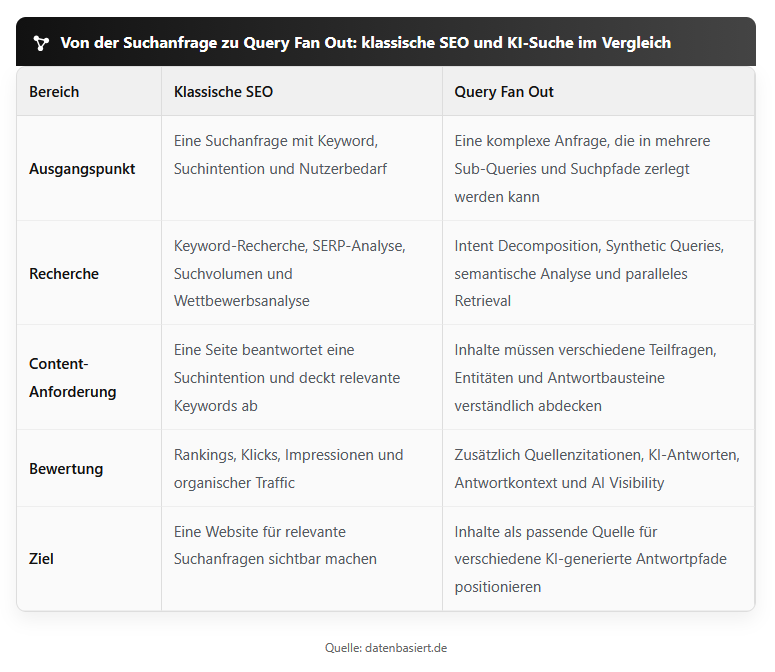
Bei klassischen Suchmaschinen steht häufig eine einzelne Suchanfrage im Mittelpunkt. Generative Suchsysteme arbeiten zunehmend anders: Eine komplexe Frage kann in mehrere verbundene Suchpfade zerlegt werden. Dieser Prozess wird als Query Fan Out bezeichnet. Aus einer Haupt-Query entstehen mehrere Sub-Queries, die unterschiedliche Informationsbereiche untersuchen und passende Quellen für eine KI-generierte Antwort suchen.
Für die GEO-Optimierung verändert sich dadurch der Blick auf Content. Nicht nur die komplette URL zählt, sondern auch einzelne Abschnitte, Entitäten und Antwortpassagen können für verschiedene Teilfragen relevant werden.
Eine Anfrage wie „GEO-Agentur für B2B-SaaS-Unternehmen gesucht“ enthält mehrere Informationsdimensionen. Ein KI-System kann daraus beispielsweise Suchpfade zu folgenden Bereichen ableiten:
- Erfahrung mit Generative Engine Optimization und AI Search
- Branchenkenntnis im B2B- und SaaS-Umfeld
- Methoden wie Content-Analyse, Prompt-Monitoring und Quellenanalyse
- Referenzen, Ergebnisse und technische Umsetzung
- Kostenmodelle und Leistungsumfang
Diese Aufteilung bedeutet nicht, dass für jede Teilfrage eine eigene Seite entstehen muss. Für GEO ist entscheidend, dass Inhalte einen Themenbereich verständlich strukturieren und einzelne Abschnitte konkrete Informationsbedürfnisse beantworten.
Besonders relevant sind dabei:
- klare Beziehungen zwischen Entitäten und Themen
- verständliche Überschriften und Inhaltsstrukturen
- präzise Antwortpassagen für konkrete Nutzerfragen
- interne Verlinkung zwischen zusammengehörigen Inhalten
- verlässliche Informationen mit nachvollziehbarem Kontext
Query Fan Out zeigt damit einen zentralen Unterschied zwischen klassischer Suchmaschinenoptimierung und GEO: Inhalte werden nicht nur für ein Ranking erstellt, sondern müssen als verwertbare Informationsquelle innerhalb mehrerer KI-Recherchepfade funktionieren.
Wie Query Fan Out technisch arbeitet, welche Rolle Synthetic Queries, Retrieval und Quellenzitation spielen und wie sich Inhalte dafür strukturieren lassen, erklären wir ausführlich im Beitrag Query Fan Out erklärt.
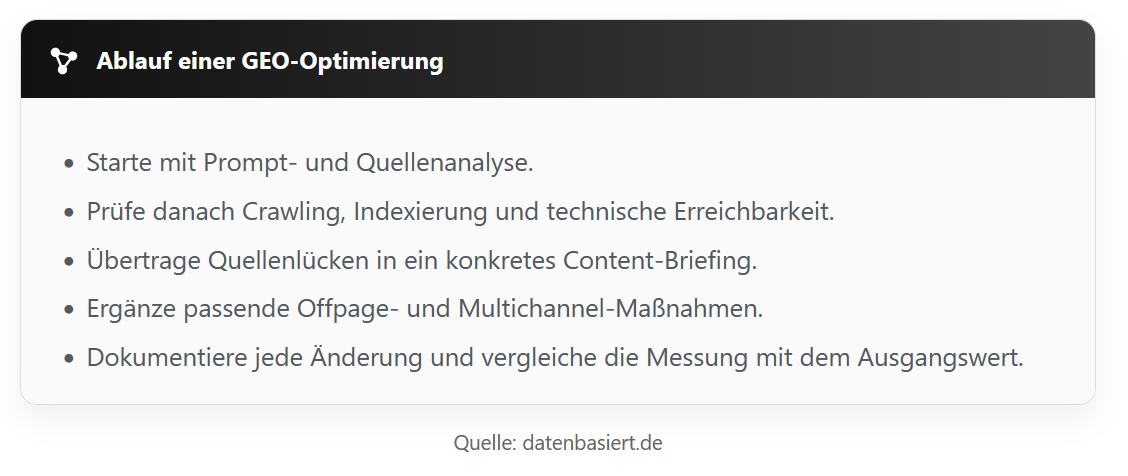
GEO-Optimierung in 5 Schritten
1. Status prüfen
- Prompt-Cluster und Suchintention festlegen
- KI-Plattform, Suchmodus und Erhebungsdatum dokumentieren
- Quellenlinks, Markennennungen und Antwortqualität erfassen
Leite Prompts aus Suchanfragen, internen Suchdaten und Beratungsfragen ab. Die Google Search Console unterstützt die Prompt-Recherche. Beginne etwa mit 20 bis 50 Prompts plus Prompt-Varianten; das ist keine statistische Mindestgröße. Dokumentiere im Prompt-Set die Suchintentionen für Fachfragen, Softwarevergleiche und Markenfragen.
Direkte Markenfragen gehören in ein separates Prompt-Set. „Was veröffentlicht datenbasiert.de über GEO?“ prüft die Markenidentifikation. „Wie messe ich Quellenzitationen in ChatGPT Search?“ untersucht Quellenpräsenz ohne Markenvorgabe. Dokumentiere KI-Plattform, Suchmodus, Sprache und Erhebungsdatum und sichere KI-Antworten samt Quellenlinks. Wiederhole die Prompt-Tests möglichst ohne vorangehende Chat-Historie, damit frühere Markenempfehlungen den Vergleich nicht beeinflussen.
2. Technische Optimierung vorbereiten
Prüfe für die zugehörigen Zielseiten Crawling, Indexierung und HTML-Ausgabe. Stimmen HTTP-Statuscodes, Canonicals und XML-Sitemap überein? Sind Antwortpassagen ohne Login oder Bot-Challenge erreichbar? Ein Content-Update hilft wenig, wenn die Web Application Firewall den Quellenabruf blockiert. Die Grundlagen dafür erklärt der Beitrag zum technischen SEO.
Dokumentiere beim Crawler-Check User-Agent, HTTP-Statuscodes und HTML-Ausgabe je Zielseite. Vergleiche robots.txt und Firewall-Regeln mit dem Quellenabruf. Bei SaaS-Vergleichen müssen Lizenzkosten und Quellenbelege im HTML verfügbar sein. Wiederhole nach der Fehlerkorrektur den Abruf; eine höhere Citation Rate allein belegt keine isolierte Wirkung der Crawler-Freigabe.
3. Content optimieren
Vergleiche Quellenzitationen mit deinem Content-Briefing. Präzisere Lizenzkosten, Testbedingungen oder Integrationen zeigen Informationslücken. Ergänze Herstellerquelle und Testzeitpunkt auf deiner Zielseite. Das Content-Audit prüft Suchintention, Entitätenklarheit und Antwortkontext: Auch eine einzeln abgerufene Antwortpassage muss ihre Bedingungen und Quellenbelege behalten.
Die interne Verlinkung führt vom GEO-Ratgeber zu passenden Vertiefungen: Crawler-Zugriff zum technischen SEO, Content-Struktur zum On-Page-SEO und Quellenzitationen zur GEO-Messung. Beschreibende Ankertexte erklären den Anschluss. Im Content-Audit prüfst du, ob Antwortpassagen eigenständige Teilfragen beantworten und Quellenabruf, Quellenprüfung sowie Erfolgsmessung verständlich verbinden.
4. Offpage und Multichannel-Aktivitäten einplanen
Untersuche Fachportale und Bewertungsportale aus deinem Prompt-Cluster. Der Quellenabgleich betrifft Markenangaben, Produktnamen und Vergleichsdaten. Widersprüche zur Herstellerdokumentation liefern konkrete Digital-PR-Aufgaben: Primärquelle aktualisieren und Markenprofile korrigieren. Das Quellenmonitoring prüft anschließend, ob Quellenzitationen die neue Fachinformation aufgreifen.
Plane Multichannel-Veröffentlichungen von einer Referenzseite aus. Die Datentabelle liefert Vergleichsdaten, ein YouTube-Video erklärt Testmethodik, ein LinkedIn-Beitrag diskutiert Citation Rate und Quellenprüfung. Prompt-Set, Messzeitraum und Autorenprofil bleiben konsistent. Das Quellenmonitoring prüft zitierte URLs und Antwortpassagen; Reichweite allein belegt keine KI-Sichtbarkeit.
5. Messen und iterieren
Dokumentiere Content-Updates, Crawler-Konfiguration und interne Links mit Datum. Vergleiche Citation Rate, AI Presence und referenzierte URLs nach zwei bis vier Wochen unter gleichen Messbedingungen. Das ist keine GEO-Erfolgsfrist: Web-Retrieval, Indexierung und Modelltraining folgen unterschiedlichen Aktualisierungsprozessen. Prüfe Quellenzitationen, bevor du Maßnahmen bewertest.
Steigt die Citation Rate, prüfe Quellenlink, Zielseite und Antwortpassage gemeinsam. Verweist die Quellenzitation auf aktuelle Vergleichsdaten oder eine ältere Produktversion? Answer Accuracy ergänzt das GEO-Reporting, damit mehr Quellenpräsenz keine falschen Markenangaben verdeckt. Der Quellenabgleich bestimmt die nächste Content-Korrektur.
Technische GEO-Optimierung
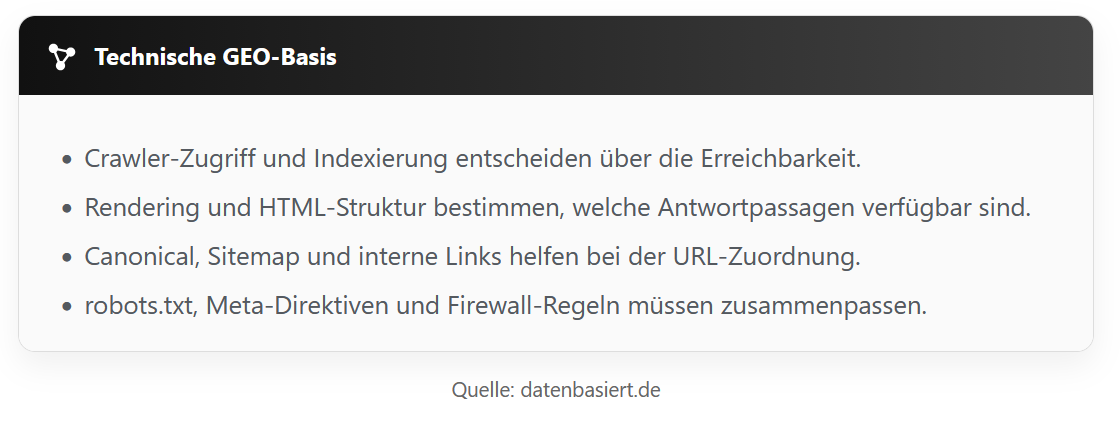
Technisches GEO beginnt mit erreichbaren, eindeutig zugeordneten Zielseiten. HTTP-Statuscodes, robots.txt und Indexierungsregeln beeinflussen den Quellenabruf; Rendering und HTML-Struktur bestimmen, welche Antwortpassagen anschließend verfügbar sind. Für unterstützende Links in AI Overviews und AI Mode nennt Google Search Central Indexierung und Snippet-Fähigkeit als Voraussetzungen. Eine Crawler-Freigabe garantiert allerdings weder Aufnahme in den Suchindex noch Quellenzitationen.
Crawling, Indexierung und Renderbarkeit
- robots.txt und HTTP-Statuscodes kontrollieren
- Canonical, Sitemap und interne Links abgleichen
- HTML-Quelltext und gerenderte Ausgabe vergleichen
- Serverlogs und relevante User-Agents prüfen
Trenne Suchcrawler und Trainingscrawler in deinem Crawler-Check. OAI-SearchBot erschließt Webinhalte für ChatGPT-Suchergebnisse, während GPTBot Inhalte für mögliches Modelltraining sammelt. Anthropic unterscheidet ebenfalls Claude-SearchBot und ClaudeBot; PerplexityBot dient Perplexity-Suchergebnissen. Die Crawler-Dokumentationen von OpenAI, Anthropic und Perplexity erklären die jeweiligen Aufgaben. Eine pauschale KI-Bot-Sperre kann sonst Suchzugriff und Trainingszugriff gleichzeitig treffen.
Prüfe robots.txt, CDN und Firewall-Regeln gemeinsam. Eine Freigabe für OAI-SearchBot hilft nicht gegen eine Bot-Challenge beim Quellenabruf. Serverlogs dokumentieren URLs, User-Agents und HTTP-Statuscodes. Verifiziere Suchcrawler anhand veröffentlichter IP-Informationen: Ein User-Agent allein beweist keine Crawler-Identität.
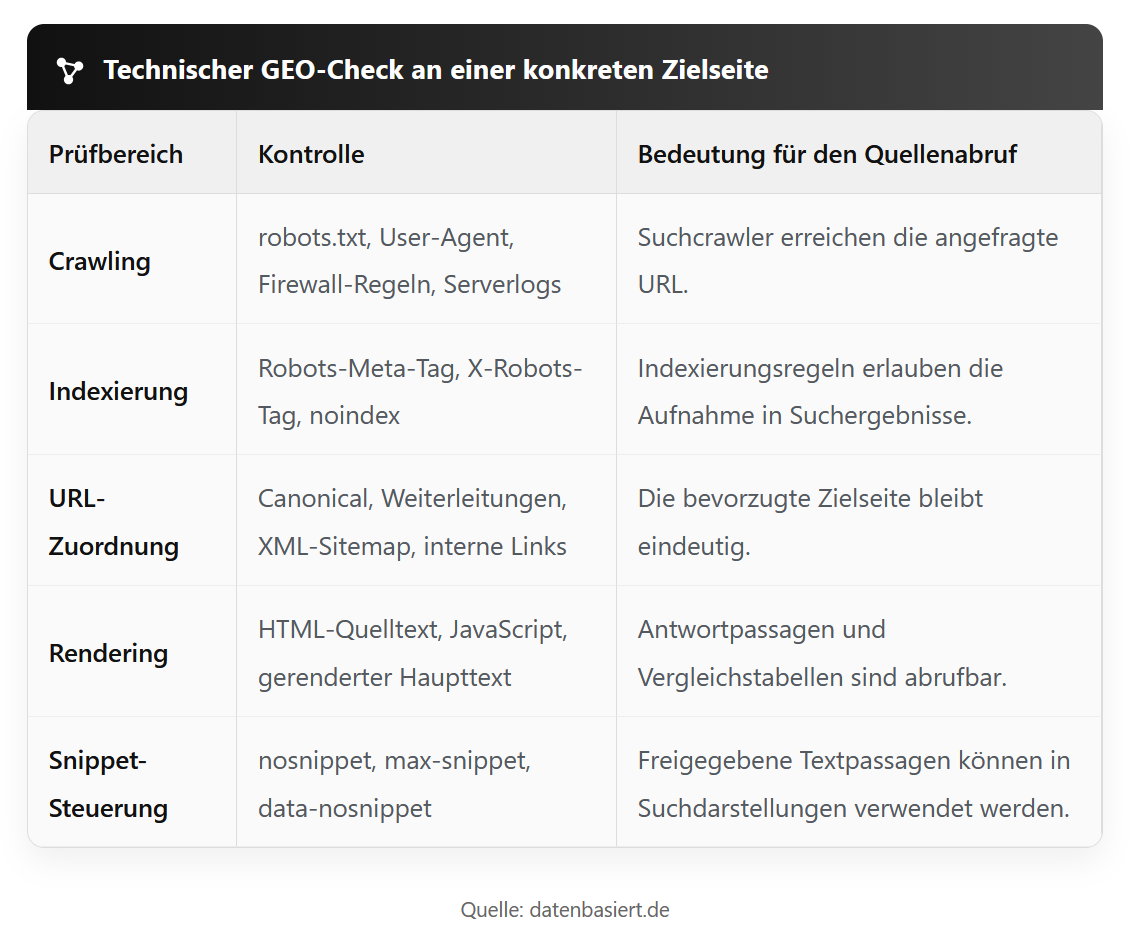
Crawling-Freigabe und Indexierungsfreigabe sind unterschiedliche Einstellungen. Ein noindex im Robots-Meta-Tag oder im HTTP-Header X-Robots-Tag muss für den Crawler lesbar sein. Eine robots.txt-Sperre kann genau diesen Abruf verhindern. Die Google-Dokumentation zu Robots-Direktiven erläutert außerdem die Snippet-Steuerung: nosnippet verhindert auch die Nutzung als direkte Eingabe für AI Overviews und AI Mode; max-snippet begrenzt den Textumfang, data-nosnippet ausgewählte HTML-Bereiche.
Vergleiche bei JavaScript-Seiten HTML-Quelltext und gerenderte Ausgabe. Crawling, Rendering und Indexierung sind getrennte Verarbeitungsschritte. Nicht jeder Crawler führt JavaScript aus. Serverseitige Antwortpassagen verringern Rendering-Abhängigkeiten. Prüfe im technischen Audit, ob Vergleichstabellen erst nach Nutzerinteraktion verfügbar werden.
Semantisches HTML, Struktur und interne Links
Bei einer Entitätenanalyse kann Salience Hinweise liefern, welche Entität im Dokument hervortritt. Googles Natural Language API verwendet dafür in ihrer v1-Entitätenanalyse einen Wert zwischen null und eins. Prüfe solche Befunde gegen Suchintention, Produktname und Quellenkontext. Salience beschreibt die Analyse dieses Textes und ist kein Nachweis für Quellenzitationen in AI Overviews.
Semantisches HTML verbindet Überschriften, Antwortpassagen und Datentabellen zu einer lesbaren Informationsarchitektur. Verwende Tabellenzellen für Vergleichsdaten, beschreibende Ankertexte für interne Links und eine nachvollziehbare Überschriftenhierarchie. Im GEO-Ratgeber sollte der Abschnitt zum Quellenabruf auf technisches SEO verweisen, während Content-Struktur und Entitätenklarheit zur Vertiefung über On-Page-SEO passen. Diese Verbindungen führen Leser zur nächsten fachlichen Frage.
Maschinenlesbarkeit beginnt beim HTML: Crawlbare Links mit href-Attribut verbinden Quellenabruf und Navigation. Canonicals, XML-Sitemap und interne Links sollten dieselben bevorzugten URLs ausweisen. Ein Navigationselement mit JavaScript-Klickereignis ersetzt keinen zuverlässig auslesbaren Quellenlink. Prüfe nach Content-Updates deshalb Ankertexte, Weiterleitungen und Zielseiten gemeinsam. Quellenprüfung und Navigation sollen zum aktuellen Softwarevergleich führen.
Strukturierte Daten ohne Schema-Fetisch
Strukturierte Daten können Artikel und Autorenschaft explizit beschreiben. Bei Article oder BlogPosting gehören Autorendaten, Veröffentlichungsdatum und Aktualisierungsdatum zum selben Inhalt wie die sichtbare Datumszeile. Prüfe JSON-LD deshalb gegen Autorenprofil und Artikeltext. Die Dokumentation zu strukturierten Daten erklärt das Grundprinzip. Ein korrektes Schema.org-Markup ersetzt jedoch weder nachvollziehbare Quellenbelege noch die fachliche Prüfung einer Antwortpassage.
Für Googles KI-Suchfunktionen sind weder spezielles GEO-Markup noch llms.txt erforderlich. Priorisiere Indexierungsfehler, Crawler-Sperren und fehlenden HTML-Haupttext. Aktualisiere dateModified bei neuen Vergleichsdaten, korrigierten Lizenzkosten oder geänderten Testbedingungen. Tägliche Datumswechsel ohne Content-Update erschweren die Quellenprüfung.
Quelle: datenbasiert.de
Agentic Readiness und Page Experience
Agentic Readiness betrachtet KI-Agenten beim Quellenabruf und bei der Navigation. Fachpublikationen brauchen erreichbare Antwortpassagen, Autorenangaben und Linktexte; Produktseiten zusätzlich auslesbare Vergleichstabellen und bedienbare Formulare. Prüfe den Nutzerpfad vom Quellenlink über Produktinformationen bis zur Conversion auf unnötige Zwischenschritte.
Page Experience verbindet Ladeleistung, Interaktivität und visuelle Stabilität über die Core Web Vitals. Langsame Landingpages oder springende Vergleichstabellen erschweren den Besuch nach einer Quellenzitation. Prüfe Crawler-Zugriff und Nutzererfahrung gemeinsam: Fachinformationen müssen beim Quellenabruf verfügbar und nach dem Quellenklick verständlich sein.
GEO-Optimierung für Content
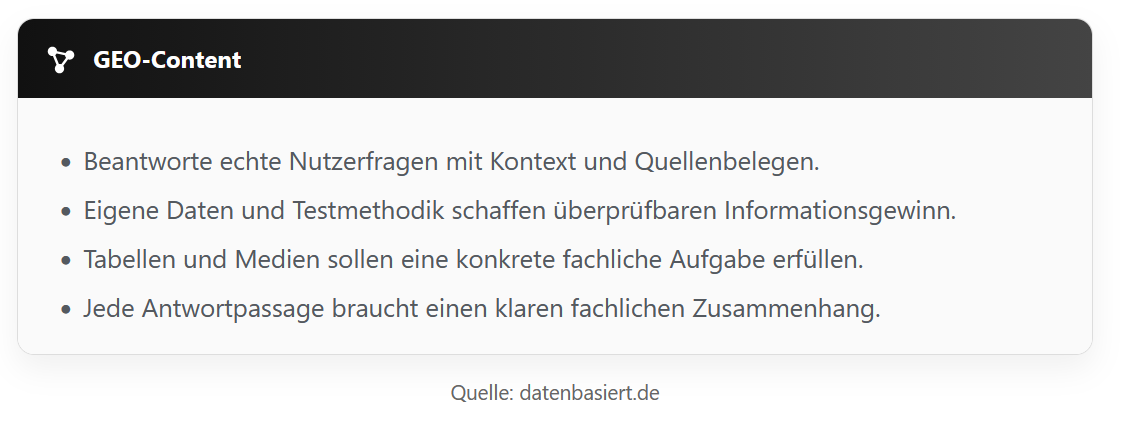
GEO-Optimierung für Content beginnt mit einer redaktionellen Frage: Welche Fachinformation hilft bei dieser Suchintention tatsächlich weiter? Ein allgemeiner Absatz über „mehr Sichtbarkeit“ beantwortet weder einen Prompt zur Citation Rate noch eine Frage zu Crawler-Einstellungen. Ersetze solche Passagen durch erklärte Zusammenhänge. Beim GEO-Monitoring können das Prompt-Varianten, Quellenzitationen und Stichprobengröße sein; beim technischen SEO verbindet die Erklärung robots.txt, Serverantworten und Indexierung.
Von Keywords zu Prompts und Antwortbausteinen
- Suchintention und Prompt-Varianten verbinden
- Antwortpassagen mit Entitäten und Bedingungen formulieren
- Quellen und Testzeitpunkt direkt an der Aussage nennen
- Tabellen und Listen nur bei echtem Vergleichsbedarf verwenden
- Eigene Messdaten und Grenzen der Methode offenlegen
Keywords bleiben für Themenrecherche und Suchintention nützlich. Ein Prompt enthält häufig zusätzliche Bedingungen, die im einzelnen Suchbegriff fehlen. Aus „GEO messen“ wird beispielsweise „Wie vergleiche ich Quellenzitationen in ChatGPT Search und Perplexity bei denselben Fachfragen?“. Diese Formulierung verbindet KI-Plattformen, Prompt-Set und Vergleichsmethodik. Dein Content-Briefing sollte daraus eine nachvollziehbare Messanleitung entwickeln, anstatt nur zusätzliche Varianten des Keywords einzubauen.
Ordne jeder Teilfrage eine Antwortpassage zu. Im Messbeispiel erklärt ein Absatz das Prompt-Set, der nächste die Zählregeln für Quellenlinks und ein weiterer die Grenzen der Citation Rate. Übergänge entstehen aus der Aufgabe: Ohne identische Prompts ist der Plattformvergleich schwer interpretierbar; ohne dokumentierte Quellenlinks bleibt die Kennzahl unprüfbar. Dadurch entsteht eine zusammenhängende Erklärung, obwohl jede Antwortpassage auch einzeln verständlich bleibt.
Fachbegriffe in Überschriften und Ankertexten sollten dieselbe Logik unterstützen. „Citation Rate und Quellenlinks auswerten“ benennt eine konkrete Aufgabe, „Erfolg verbessern“ kaum. Entitäten wie ChatGPT Search, Gemini und Perplexity brauchen eine konsistente Schreibweise. Nutze verwandte Terminologie dort, wo sie Unterschiede erklärt: Quellenabruf betrifft die Beschaffung, Quellenzitation die sichtbare Referenz in der KI-Antwort. Ein Synonymwechsel allein vergrößert keine Themenabdeckung.
Erfahrung einbauen, ohne künstlich persönlich zu werden
First-Hand Experience zeigt sich in überprüfbaren Beobachtungen. Für eine GEO-Auswertung gehören Prompt-Set, Erhebungsdatum, KI-Plattformen und Testmethodik direkt zu den Ergebnissen. Beschreibe, welche Quellenlinks gezählt wurden und ob direkte Markenfragen enthalten waren. Wenn eine Vergleichstabelle geändert wurde, dokumentiere das Content-Update. Leser können dann zwischen einer Beobachtung, deiner Interpretation und einer allgemeinen Empfehlung unterscheiden.
Ein hypothetisches Beispiel macht die Trennung deutlich: Nach einem Content-Update erscheint eine Zielseite in zwölf statt acht von dreißig KI-Antworten. Die Citation Rate ist in dieser Stichprobe gestiegen. Ohne Kontrollseiten und weitere Messzeitpunkte bleibt jedoch offen, ob neue Vergleichsdaten, veränderte Quellenmuster oder Schwankungen der KI-Plattform verantwortlich waren. Eine ehrliche Fallbeschreibung benennt diese Grenze, statt aus dem Vorher-nachher-Vergleich einen bewiesenen Rankingfaktor zu machen.
Wenn eigene Messdaten fehlen, arbeite mit Primärquellen. Eine technische Anleitung kann Crawler-Dokumentationen, Serverantworten und Indexierungsregeln nachvollziehbar verbinden. E-E-A-T-Signale entstehen nicht dadurch, dass ein Absatz mehrfach „aus meiner Erfahrung“ behauptet. Autorenprofil, fachliche Zuständigkeit und überprüfbare Quellenbelege geben Lesern einen konkreteren Anhaltspunkt. Erfundenes Projektwissen oder angebliche Kundenerfolge würden genau diese Vertrauensgrundlage beschädigen.
Frische und Irreplaceability
Mit Irreplaceability lässt sich fragen, welchen Informationsgewinn deine Zielseite gegenüber vorhandenen Quellen bietet. Eine aktualisierte Herstellerdokumentation, ein eigener Softwarevergleich oder eine reproduzierbare GEO-Auswertung können einen konkreten Recherchebedarf bedienen. Reines Grundlagenwissen kann ein Sprachmodell oft ohne dieselbe Quelle formulieren. Daraus folgt aber keine feste Abrufregel: Ob eine Websuche erfolgt, hängt weiterhin von KI-Plattform, Suchmodus und Prompt ab.
Aktualisiere deshalb die Informationen, deren Veränderungen eine Empfehlung beeinflussen. Bei SaaS-Vergleichen betrifft das Lizenzkosten, Produktversionen und Integrationen; bei GEO-Anleitungen Crawler-Vorgaben, Suchfunktionen und Messmethoden. Halte Testzeitpunkt und Quellenangaben direkt beim jeweiligen Vergleich fest. Eine ältere Definition braucht nicht automatisch ein neues Datum. Ein veralteter Quellenbeleg zur Bot-Steuerung kann dagegen zu einer falschen technischen Entscheidung führen.
Quelle: datenbasiert.de
Die Studie „GEO: Generative Engine Optimization (2023, Aggarwal et al)“ untersucht Content-Anpassungen in einem eigenen Benchmark. Aggarwal und Mitautoren berichten darin Sichtbarkeitssteigerungen von bis zu 40 Prozent, abhängig von Versuchsaufbau und Themengebiet. Das liefert Ansatzpunkte für GEO-Testhypothesen, aber keine Erfolgsprognose für aktuelle ChatGPT-Antworten. Eigene Prompt-Tests sollten deshalb Quelle, Messbedingungen und beobachtete Wirkung getrennt dokumentieren.
Tabellen, Listen und Medien mit Zweck
Eine Vergleichstabelle hilft, wenn gemeinsame Kriterien eine Entscheidung ermöglichen. Stelle etwa Crawler-Aufgabe, User-Agent und Zugriffseinstellung nebeneinander oder vergleiche GEO-KPIs anhand ihrer Zählregeln. In beiden Fällen unterstützt die Tabellenstruktur den Quellenabgleich. Eine Fachwortliste ohne Beziehung zwischen den Begriffen würde dagegen nur die Terminologie verdichten. Für eine Anleitung ist eine geordnete Schrittfolge sinnvoller, wenn Crawling-Prüfung, Fehlerkorrektur und Nachkontrolle aufeinander aufbauen.
Zusätzliche Frage-Antwort-Elemente sollten verbleibende Nutzerfragen beantworten, statt den gesamten Artikel zu wiederholen. Im GEO-Ratgeber können das Fragen zu llms.txt, Aktualisierungsintervallen oder dem Unterschied zwischen Markennennung und Quellenlink sein. Halte Einschränkungen direkt bei der jeweiligen Antwort fest. Ein isoliertes Antwortmodul sollte keine garantierte KI-Sichtbarkeit versprechen, während der Haupttext Quellenwahl und Messunsicherheit differenziert erklärt.
Bild, Video und Datenvisualisierung
Eigene Screenshots und Datengrafiken machen Quellenanalysen überprüfbarer. Ein Beispiel aus der Google Search Console sollte Messzeitraum und Messgröße zeigen; ein Prompt-Monitoring braucht erkennbare KI-Plattformen und dokumentierte Quellenzitationen. Erläutere in der Bildunterschrift, was die Darstellung belegt. Ein Diagramm mit steigenden Klicks beweist beispielsweise noch keinen GEO-Effekt, wenn klassische Suchrankings und KI-Referrals nicht getrennt untersucht wurden.
Alt-Texte beschreiben Bildinformation oder Bildfunktion. Die W3C-Empfehlungen für informative Bilder richten die Textalternative am Bildinhalt aus. Bei einer GEO-Grafik passen Begriffe wie Citation Rate oder Quellenzitation, wenn sie dargestellt werden. Ergänze komplexe Messdaten als sichtbare Datentabelle. Bei Videos helfen ein verständlicher Titel und ein geprüftes Transkript, damit Testmethodik und Quellenangaben auch ohne Wiedergabe zugänglich bleiben.
Multichannel- und Offpage-GEO
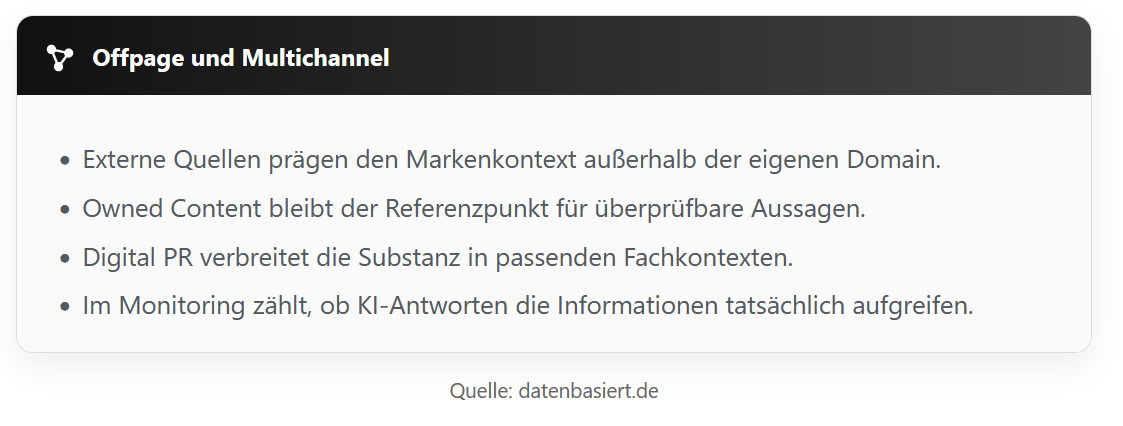
GEO-Optimierung endet nicht auf der eigenen Domain. In Quellenanalysen können Fachportale, Bewertungsportale und Produktverzeichnisse neben Herstellerseiten erscheinen. Offpage-GEO beginnt deshalb mit einer Frage zum beobachteten Prompt-Cluster: Welche externen Quellen tragen die Markenempfehlungen? Wenn Perplexity einen Softwarevergleich zitiert oder ChatGPT Search eine Fachpublikation verlinkt, untersuchst du die dortigen Markenangaben ebenso wie deine eigene Landingpage.
Backlinks, Markennennungen und KI-Zitationen beschreiben unterschiedliche Beziehungen. Ein Backlink verbindet zwei URLs im Web; eine Markennennung kann ohne Verlinkung entstehen. Eine Quellenzitation zeigt dagegen, welche Referenz die konkrete KI-Antwort anführt. Im GEO-Reporting sollten diese Signale getrennt bleiben. Aus einer neuen Verlinkung lässt sich nicht ableiten, dass dieselbe Domain anschließend häufiger im Prompt-Monitoring erscheint.
Digital PR für fachliche Entitäten
Digital PR und Thought Leadership brauchen überprüfbare Fachinformationen. Eine GEO-Auswertung liefert Fachredaktionen Vergleichsdaten zu KI-Plattformen, Quellenmustern und Citation Rate. Veröffentliche Testmethodik, Prompt-Set und Erhebungszeitraum auf einer stabilen Referenzseite. Ein Fachbeitrag kann diese Primärquelle zitieren, Ergebnisse einordnen und Einschränkungen diskutieren. So entsteht eine nachvollziehbare Quellenbeziehung zwischen Autorenprofil, Datenauswertung und externer Veröffentlichung.
Gleiche Markenname, Autorenangaben und Themengebiet über Veröffentlichungen hinweg ab. Eine Grounding Page bündelt Leistungsangebot, Zuständigkeiten und Fachpublikationen. Dafür eignet sich auch eine gepflegte Über-uns-Seite. Kontrolliere ihre Markenangaben gegen Schema.org-Markup, Autorenprofile und externe Verzeichnisse; ein besonderer URL-Pfad ist nicht erforderlich.
Trenne Markenidentität und Werbung: Technische SEO-Audits beschreiben ein prüfbares Leistungsangebot; ein Führungsanspruch braucht unabhängige Belege. Die Quellenprüfung verbindet Autorenschaft, Fachinformation und Quellenbeleg. Wiederholte Eigenwerbung ersetzt weder Entitätenklarheit noch Quellenqualität.
Multichannel als Wiederverwendung von Substanz
Ein Datensatz kann mehrere Veröffentlichungen tragen: Der Artikel liefert Vergleichsdaten, das YouTube-Video erklärt Testmethodik, der LinkedIn-Beitrag diskutiert Citation Rate und Quellenprüfung. Verbinde sämtliche Formate mit derselben Referenzseite, demselben Prompt-Set und Messzeitraum. Quellenangaben müssen auch bei gekürzter Darstellung nachvollziehbar bleiben.
Vergleiche deutsche und englische Suchintentionen anhand tatsächlicher Quellenzitationen. Übersetzungen helfen, wenn internationale Fachfragen andere Produktdokumentationen benötigen; englische Markenprofile sind keine pauschale Pflicht. Halte Produktnamen, Einheiten und Quellenbelege in Vergleichstabellen konsistent. Widersprüchliche Sprachversionen erschweren Quellenabgleich und Aktualisierung.
Community, Reviews und öffentliche Diskussionen
Wikipedia und Reddit sind mögliche Recherchequellen, aber keine pauschalen Platzierungsziele. Prüfe tatsächliche Quellenzitationen im Prompt-Cluster, bevor du Maßnahmen planst. Für die Vernetzung einer Domain lässt sich zusätzlich der Web-Graph untersuchen. Harmonic Centrality (HC) beschreibt darin die Nähe zu anderen Knoten über Verbindungen; Common Crawl veröffentlicht entsprechende Netzwerkdaten. Die Metrik belegt weder Aufnahme in einen Trainingskorpus noch Quellenpräsenz in ChatGPT Search. Für GEO bleiben Quellenmonitoring, Citation Rate und überprüfbare Markenangaben die anschließende Ergebniskontrolle.
Bewertungsportale und Community-Beiträge ergänzen Herstellerdokumentationen um Integrationsprobleme, Support-Erfahrungen und Grenzen beim Datenexport. Prüfe ihre Quellenpräsenz im Prompt-Cluster. Fachliche Antworten auf Produktfragen brauchen eine erreichbare Integrationsdokumentation oder nachvollziehbare Testmethodik.
Erfundene Bewertungen machen die Quellenlage unzuverlässig. Übernimmt eine KI-Antwort veraltete Einschränkungen, dokumentiere Quellenlink und Antwortpassage. Korrigiere Produktinformationen und nachweislich falsche externe Markenangaben. Im GEO-Monitoring prüfst du aktualisierte Quellenzitationen; eine Profilkorrektur garantiert keine sofortige Änderung der KI-Antwort.
Owned Content bleibt der Anker
Die Referenzseite bündelt Testmethodik, Quellenangaben und Aktualisierungsstand. Social-Posts verweisen auf diese Primärquelle. Prüfe interne Links nach Content-Updates und richte Weiterleitungen für ersetzte URLs ein, damit Fachbeiträge und KI-Zitationen weiterhin zur aktuellen Datentabelle führen.
GEO-Optimierung für verschiedene LLMs
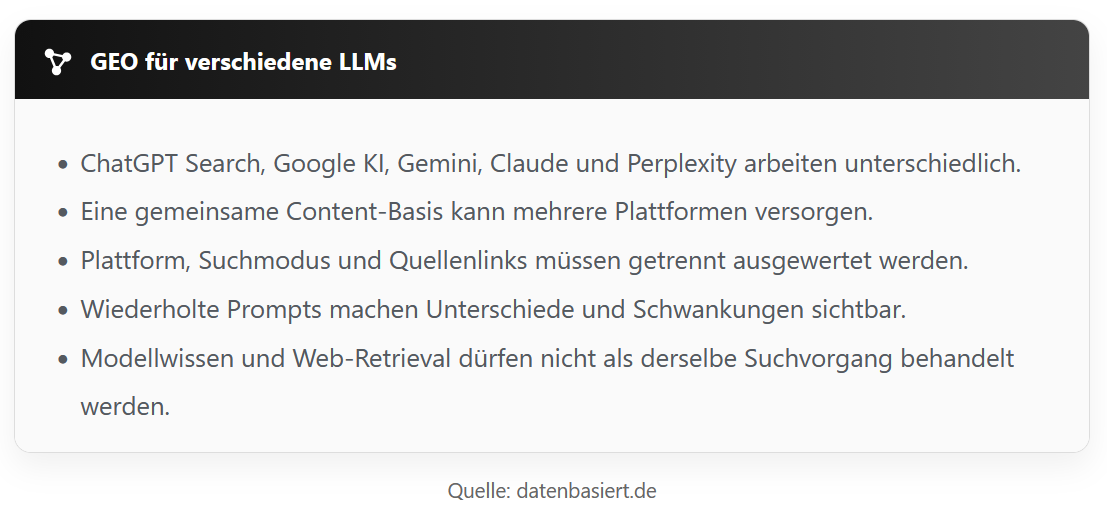
ChatGPT, Gemini, Claude und Perplexity sind keine austauschbaren Messpunkte. Suchmodus, Quellenabruf und Antwortformat unterscheiden sich; selbst dieselbe KI-Plattform kann bei wiederholten Prompts andere Quellenzitationen zeigen. Plane deshalb eine gemeinsame Content-Basis, aber getrennte Auswertungen. Ein aggregierter Sichtbarkeitswert kann sonst verdecken, dass die Citation Rate bei einer Plattform steigt und bei einer anderen fällt.
GEO-Optimierung für ChatGPT
Quelle: datenbasiert.de
Bei SEO für ChatGPT prüfst du zunächst, ob der Test die Suchfunktion verwendet. Eine ChatGPT-Antwort aus Modellwissen lässt sich nicht automatisch einer aktuellen Zielseite zuordnen. Bei ChatGPT Search kannst du dagegen Quellenlinks und Quellenkarten untersuchen. Der technische Check verbindet OAI-SearchBot, robots.txt und Serverlogs mit den tatsächlich zitierten URLs. GPTBot betrifft eine andere Aufgabe und ist kein Ersatz für den Suchcrawler.
Wähle Prompts nach Suchintention: SaaS-Integrationen brauchen andere Quellenbelege als GEO-Definitionen. Prüfe im Antwortkontext Produktnamen, Vergleichstabelle und Datenexport. Ein korrekter Quellenlink garantiert nicht, dass die KI-Zusammenfassung sämtliche Einschränkungen übernimmt.
Trenne im Prompt-Monitoring Fachfragen ohne Markenvorgabe von direkten Markenfragen. Erstere prüfen Quellenpräsenz, letztere Markenidentifikation und Answer Accuracy. Vergleiche bei falschen Leistungsangaben Referenzseiten, Markenprofile und Quellenbelege. Mehr Markennennungen lösen widersprüchliche Markenangaben nicht.
GEO-Optimierung für Google KI und Gemini
Quelle: datenbasiert.de
AI Overviews und AI Mode gehören zu Google Search. Die Gemini-App behandelst du im Monitoring als eigene Oberfläche. Eine Quellenzitation in Gemini beweist keine entsprechende Präsenz in AI Overviews. Erfasse Suchanfrage, Suchmodus und Quellenlinks deshalb getrennt. Bei einer komplexen Nutzerfrage solltest du auch prüfen, welche Teilfragen die KI-Antwort behandelt und welche Zielseiten diese jeweils stützen.
Für AI Overviews und AI Mode bleibt die Google-Suchbasis entscheidend: Indexierung und Snippet-Fähigkeit ermöglichen die Teilnahme, erzwingen aber keine Quellenwahl. Query Fan-out kann zusätzliche Suchintentionen erschließen. Beim Content-Audit ist daher die Zuordnung zwischen Teilfrage und Antwortpassage hilfreicher als die bloße Wiederholung des Hauptkeywords. Technische Erreichbarkeit, eindeutige Entitäten und nachvollziehbare Quellenbelege bilden die gemeinsame Arbeitsgrundlage.
In der Google Search Console wird Traffic aus diesen KI-Suchfunktionen dem Suchtyp „Web“ zugerechnet. Gesamtklicks lassen sich deshalb nicht als isolierter GEO-Effekt interpretieren. Verbinde Search-Console-Daten mit dokumentierten Quellenzitationen und den betroffenen Landingpages. Veränderungen der klassischen Suchrankings gehören ebenfalls in die Einordnung. Der Beitrag zu den SEO-Trends vertieft die Entwicklung der Suchoberflächen.
GEO-Optimierung für Claude
Quelle: datenbasiert.de
Anthropic unterscheidet Claude-SearchBot für Suchaufgaben, ClaudeBot für mögliches Modelltraining und Claude-User für nutzerinitiierte Abrufe. Für deine GEO-Analyse sind daher Suchmodus und tatsächliche Quellenverwendung maßgeblich. Eine Claude-Antwort ohne Quellenzitation erlaubt keine sichere Zuordnung zu einer einzelnen Webseite. Vermeide Rückschlüsse aus einem alten Systemprompt-Auszug; aktuelle Prompt-Tests zeigen die beobachtbaren Ergebnisse zuverlässiger.
Prüfe bei Claude Antwortkontext, Quellenqualität, Testzeitpunkt und Produktversion. Bezieht sich die KI-Empfehlung auf die dokumentierten Testbedingungen? Kontrolliere bei veralteten Quellen die Abrufbarkeit der Referenzseite. Entscheidend bleiben aktuelle Fachinformationen und Quellenbelege, nicht die Länge der Fachanalyse.
GEO-Optimierung für Perplexity
Quelle: datenbasiert.de
PerplexityBot dient laut Anbieter dazu, Websites in Perplexity-Suchergebnissen auffindbar zu machen und zu verlinken. Im Quellenmonitoring kannst du anschließend die Quellenbelege einer Antwort einzeln prüfen. Vergleiche zitierte URLs, Produktnamen und Antwortpassagen. Eine aktuelle Quellenangabe ist wenig hilfreich, wenn die Empfehlung eine Einschränkung aus dem zugrunde liegenden Softwarevergleich übersieht.
Für die Content-Optimierung ergeben sich daraus konkrete Aufgaben: Testzeitpunkt ergänzen, veraltete Lizenzkosten korrigieren oder die Herstellerdokumentation präziser verlinken. Aktualisiere zusammengehörige Vergleichstabellen und Produktdetailseiten gemeinsam. Wiederhole anschließend dieselben Prompt-Varianten und dokumentiere die Quellenverwendung. So zeigt der Vergleich, ob Perplexity tatsächlich die aktualisierte Fachinformation aufgreift.
Ein gemeinsames Grundprinzip
Erweiterst du das Monitoring um Microsoft Copilot, Bing oder Anwendungen mit Meta Llama, dokumentiere Suchoberfläche, Modellversion und Webzugriff. Bing als Suchmaschine, Copilot als Assistenzangebot und Llama als Modellfamilie sind unterschiedliche Messobjekte. Ein gemeinsames Prompt-Set ermöglicht Vergleiche, wenn Quellenabruf, Quellenzitation und Markenidentifikation getrennt ausgewertet werden.
Jede Antwortpassage braucht Entität, Aussage und Quellenbeleg. Nutze Plattformtests zur Priorisierung der Content-Optimierung. Ein Softwarevergleich kann mehrere Suchintentionen bedienen; Quellenanalyse und GEO-KPIs zeigen Informationslücken, ohne für jedes LLM einen nahezu identischen Artikel anzulegen.
KPIs für GEO-Optimierung
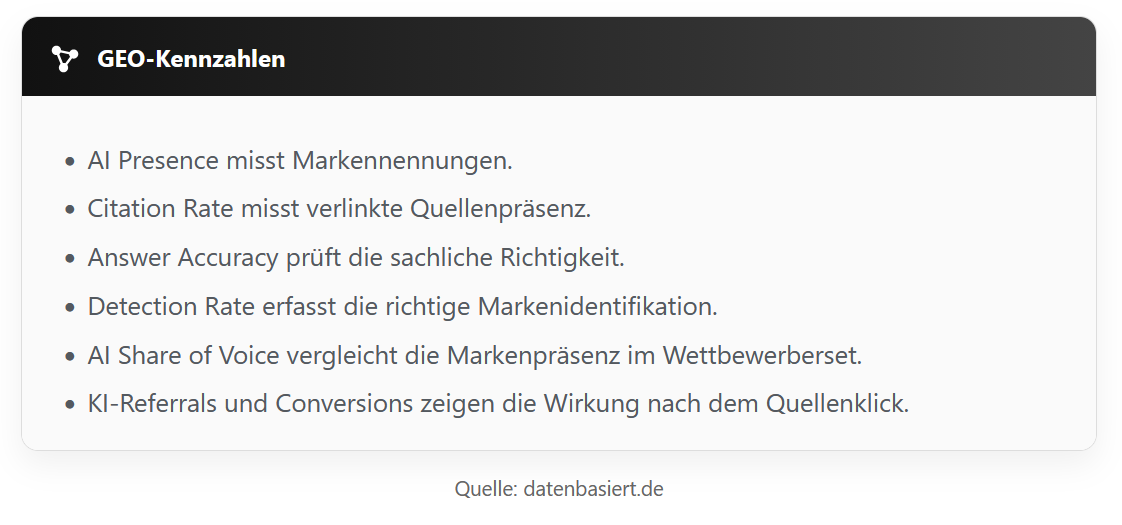
GEO-KPIs verbinden drei Perspektiven: AI Presence erfasst Markennennungen, Citation Rate verlinkte Quellenpräsenz und Answer Accuracy die sachliche Richtigkeit. KI-Referrals und Conversions beschreiben Website-Besuche und Ergebnisse. Häufige Quellenzitationen können mit wenigen Klicks einhergehen; qualifizierter Traffic kann trotz geringer Markenpräsenz entstehen.
Definiere Zählregeln vor dem Monitoring. Dokumentiere Prompt-Set, Suchintentionen, Prompt-Varianten und gültige Testläufe; fehlgeschlagene Abrufe bleiben separat. Halte KI-Plattform, Suchmodus und Messzeitraum konstant. Prüfe bei Monitoring-Anbietern die Berechnung gleichnamiger GEO-KPIs, bevor du Kennzahlen vergleichst.
AI Presence
- Prompt-Set und Wettbewerberset definieren
- Gültige KI-Antworten wiederholt erfassen
- Markennennung, Quellenlink und Darstellung bewerten
- Messzeitpunkt und Plattform im Reporting festhalten
- Veränderungen mit Kontrollseiten vergleichen
- Content-Update und Folgeprüfung dokumentieren
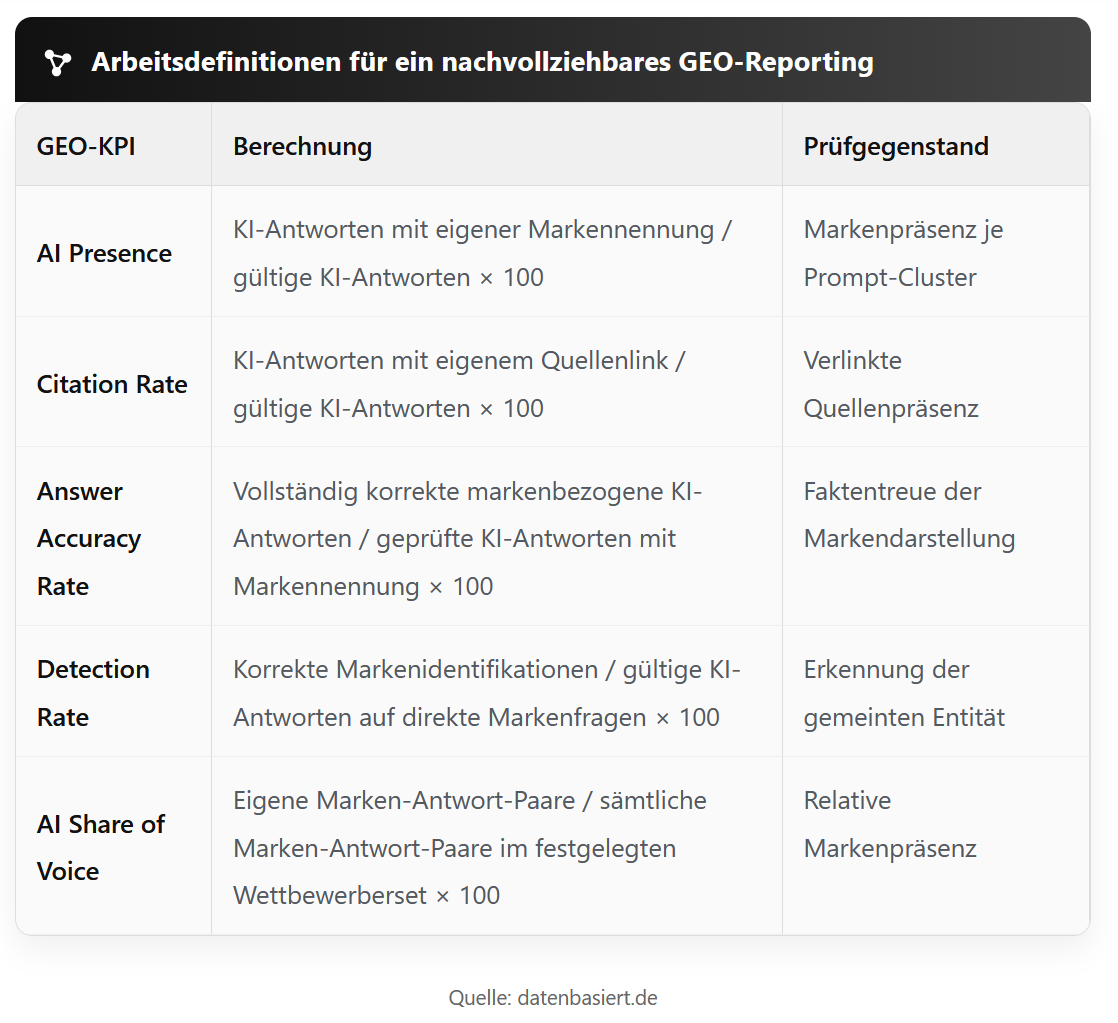
AI Presence beschreibt hier den Anteil gültiger KI-Antworten mit eigener Markennennung. Visibility Percentage wird für eine vergleichbare Sichtbarkeitsquote verwendet; prüfe jeweils die Zählregeln. Zähle jede KI-Antwort höchstens einmal. Bei 100 KI-Antworten, von denen 35 die Marke nennen, beträgt die AI Presence 35 Prozent. Prompt-Set, Themencluster und Stichprobe begrenzen die Aussage auf die untersuchten Suchintentionen.
Werte Markenpräsenz nach Themencluster aus: Eine Fachpublikation kann bei GEO-KPIs erscheinen, aber bei Crawler-Fragen fehlen. Detection Rate prüft über direkte Markenfragen die korrekte Entitätserkennung. Vergleiche diese Markenidentifikation mit Quellenpräsenz bei ungestützten Suchintentionen.
Citations und referenzierte URLs
Citation Rate zählt KI-Antworten mit mindestens einem Quellenlink zur eigenen Domain. Bei 22 von 100 gültigen KI-Antworten beträgt sie 22 Prozent. Mehrere Quellenlinks derselben Antwort zählen einmal. Berichte die zusätzliche Linkanzahl separat, damit Quellenbelege und Antwortquote vergleichbar bleiben.
Referenzierte URLs zeigen die Zielseiten hinter Quellenzitationen. Gruppiere sie nach Themencluster und kontrolliere Antwortpassagen, Aktualität, Canonicals und interne Links. Bei Markenfragen passt die Startseite; bei Integrationsfragen liefert die Integrationsdokumentation den präziseren Quellenbeleg. Prüfe Quellenwahl stets anhand der Suchintention.
Answer Accuracy Rate
Prüfe Leistungsangebot, Produktnamen und Quellenzuordnungen nach dokumentierter Bewertungsregel. Sind 28 von 35 KI-Antworten mit Markennennung vollständig korrekt, beträgt die Answer Accuracy Rate 80 Prozent. Erfasse übrige Antworten als teilweise korrekt, falsch oder nicht eindeutig bewertbar. So bleiben Fehlerbilder neben der Kennzahl sichtbar.
Ergänze einen Sentiment Score mit dokumentierter Bewertungsregel. Ordne Markennennungen zunächst positiv, neutral, kritisch oder gemischt ein. Berichte beispielsweise den Anteil positiver Marken-Antwort-Paare; unbeurteilbare Fälle bleiben separat. Trenne Sentiment von Answer Accuracy: Eine positive KI-Empfehlung kann falsche Lizenzkosten nennen. Erst Quellenabgleich und Faktenprüfung zeigen, welche Markenangaben oder Quellenbelege eine Content-Korrektur benötigen.
AI Share of Voice
AI Share of Voice vergleicht die eigene Markenpräsenz mit einem festgelegten Wettbewerberset. Share of Model (SoM) begegnet dir als verwandte Kennzahl für Markennennungen im Modelloutput. Prüfe den Nenner: Einzelne Nennungen und Marken-Antwort-Paare ergeben unterschiedliche Werte. Hier zählt jede Marke pro KI-Antwort höchstens einmal. Bei 35 eigenen von insgesamt 140 Marken-Antwort-Paaren beträgt der AI Share of Voice 25 Prozent.
Halte Wettbewerberset und Messbedingungen stabil. Zusätzliche Konkurrenten oder Prompt-Cluster verändern den Nenner beim AI Share of Voice. Dokumentiere Anpassungen im GEO-Reporting. Quellenlinks, referenzierte URLs und Quellenanalysen zeigen, welche Fachportale, Herstellerseiten oder Vergleichsseiten die Entwicklung begleiten.
AI-Referred Traffic und Engagement
Die Webanalyse verbindet KI-Referrals, Landingpages und Conversions. Erfasse Anmeldungen, Anfragen und Sitzungszahlen, bevor du die Conversion-Rate bewertest. Zwei Conversions aus wenigen Besuchen ergeben noch keine stabile Entwicklung. Vergleiche Landingpages nach Suchintention und Informationsangebot nach dem Quellenklick.
Fehlende Referrer begrenzen die Attribution. Brand-Suchen und direkte Zugriffe beweisen keinen KI-Traffic. Berichte identifizierbare KI-Referrals getrennt von vermuteten Effekten. Quellenzitationen ohne Klick, Website-Besuche und Conversions brauchen eigene Auswertungen, damit Quellenpräsenz und Geschäftsergebnisse unterscheidbar bleiben.
Änderungslog und Testgruppen
Bei der Antwortgenerierung beeinflusst die LLM-Temperatur, sofern konfigurierbar, die Auswahl von Tokens, also Textbausteinen. Entropie beschreibt die Unsicherheit einer Wahrscheinlichkeitsverteilung; wechselnde Markenlisten allein messen sie nicht. Dokumentiere verfügbare Modelleinstellungen neben Suchmodus und Prompt-Set. Auch Quellenabruf, Modellversion und Antwortkontext verändern KI-Antworten. Wiederholte Prompt-Tests zeigen die beobachtbare Varianz, ohne ihre Ursache vorschnell einem einzelnen Parameter zuzuschreiben.
Dokumentiere Content-Updates, Crawler-Konfiguration und interne Verlinkung. Vergleiche bearbeitete Zielseiten mit unveränderten Kontrollseiten über mehrere Messzeitpunkte. Prüfe Citation Rate, Quellenmuster und Suchrankings parallel. Eine Veränderung nur in der Testgruppe unterstützt die Hypothese, belegt allein aber keine Kausalität.
Berichte Stichprobengröße und gültige Testläufe neben Prozentwerten. Bei zehn KI-Antworten verändert eine Quellenzitation die Citation Rate um zehn Prozentpunkte. Wiederholungsmessungen und Quellenprüfung helfen, schwankende Prompt-Cluster einzuordnen. Das GEO-Reporting verbindet Kennzahlen mit konkreten Content-Entscheidungen.

Fazit
GEO-Optimierung verbindet die SEO-Basis mit einer genaueren Prüfung von KI-Antworten. Technischer Crawler-Zugriff und Indexierung schaffen Voraussetzungen; Suchintention, Entitätenklarheit und Quellenqualität bestimmen, welche Fachinformationen eine Zielseite bereitstellt. Der praktische Vorteil entsteht dort, wo Leser eine Empfehlung überprüfen können: mit aktuellen Vergleichsdaten, nachvollziehbarer Testmethodik und Antwortpassagen, die ihre Einschränkungen nicht verlieren.
Wähle für den nächsten GEO-Schritt ein Prompt-Cluster und untersuche Quellenzitationen sowie Informationslücken. Fehlt der Testzeitpunkt im Softwarevergleich? Blockiert die Firewall den Suchcrawler? Widersprechen externe Markenangaben deiner Referenzseite? Dokumentiere Content-Update oder Crawler-Korrektur und wiederhole das Prompt-Monitoring. Citation Rate, AI Presence und Answer Accuracy bilden gemeinsam die Ergebniskontrolle.
Die eigene Domain bleibt Referenz für Vergleichsdaten, Quellenbelege und Autorenschaft. Offpage-Veröffentlichungen und Multichannel-Formate verbreiten Fachinformationen; Quellenmonitoring prüft ihre Verwendung. Wiederholte Prompt-Tests verbinden GEO-Optimierung mit beobachtbarer Quellenpräsenz und überprüfbarer Markendarstellung.
Ein konkreter GEO-Test verbindet Quellenanalyse und Content-Update: Im Prompt-Cluster für CRM-Software zitiert ChatGPT Search eine Vergleichsseite mit veralteten Lizenzkosten. Der Quellenabgleich zeigt dieselbe Produktversion, aber einen älteren Testzeitpunkt. Aktualisiere Vergleichstabelle und Herstellerquelle; kontrolliere anschließend Canonical, interne Links und HTML-Ausgabe. Wiederhole das Prompt-Set bei gleichem Suchmodus. Im GEO-Reporting dokumentierst du Quellenzitation, referenzierte URL und Answer Accuracy vor und nach dem Content-Update. Eine unveränderte Citation Rate kann dabei mit besserer Antwortqualität einhergehen: Die Quellenpräsenz bleibt gleich, doch die KI-Empfehlung übernimmt nun korrekte Vergleichsdaten.
Checkliste für die GEO-Optimierung