
Query Fan Out beschreibt, wie ein KI-Suchsystem eine komplexe Suchanfrage in mehrere verwandte Teilanfragen auffächert. Aus einer Haupt-Query entstehen Sub-Queries, die unterschiedliche Suchintentionen, Entitäten, Unterthemen und Kontextsignale abdecken. Diese parallelen Suchpfade laufen über Retrieval, Suchindex und Websuche, bevor relevante Textpassagen ausgewählt, gewichtet und zu einer generativen Antwort zusammengeführt werden.
Für die Einordnung lohnt sich der Blick auf Generative Engine Optimization, weil Query Fan Out direkt mit AI Search, Grounding, Retrieval-Augmented Generation, Quellenzitationen und Antwortbausteinen zusammenhängt. Die technische und redaktionelle Basis bleibt klassische Suchmaschinenoptimierung. Im SEO-Guide findest du dafür die Grundlagen zu Suchintention, Crawling, Indexierung, Suchergebnissen, Content und interner Verlinkung. Dieser Artikel erklärt die Fan-Out-Mechanik, Synthetic Queries, Intent Decomposition, Parallel Retrieval, Relevanz-Ranking und die Folgen für Content-Struktur und Themenabdeckung.
Was ist Query Fan Out?
Query Fan Out ist ein Retrieval-Verfahren, bei dem ein KI-gestütztes Suchsystem aus einer Nutzeranfrage mehrere zusammenhängende Suchanfragen ableitet. Statt den sichtbaren Prompt nur als einzelnen String gegen einen Suchindex zu schicken, wird die Ausgangsfrage semantisch analysiert und in Unterfragen zerlegt. Diese Query Decomposition kann Kern-Intent, Sub-Intentionen, Entitäten, Bedingungen und Suchkontext trennen. Daraus entstehen Synthetic Queries zu Voraussetzungen, Kosten, Vergleichen, Alternativen, lokalen Bedingungen oder anderen Query-Dimensionen.
Google beschreibt Query Fan Out für generative Suchfunktionen als mehrere gleichzeitig ausgeführte, verwandte Queries über Unterthemen und Datenquellen. Der Mechanismus kann in AI Overviews und im AI Mode zum Einsatz kommen. Die ursprüngliche Query bleibt der Ausgangspunkt, ist aber nicht zwingend identisch mit den parallelen Suchanfragen, über die unterstützende Webseiten, Quellen und einzelne Antwortpassagen gefunden werden. Genau deshalb können klassische Websuche und generative KI-Suche bei derselben Nutzerfrage unterschiedliche Quellenmuster zeigen.
Vom Prompt zu mehreren Suchpfaden
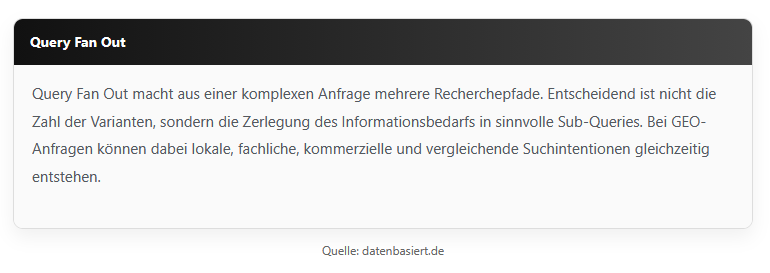
Der Begriff lässt sich ziemlich wörtlich lesen. Eine Query wird aufgefächert. Das Ergebnis ist keine hübsche Keyword-Wolke, sondern eine Fan-Out-Struktur mit mehreren Recherchepfaden. Man kann sie sich als Baumstruktur vorstellen: Haupt-Query oben, darunter Unterverzweigungen mit Teilfragen, Folgefragen und semantisch verwandten Queries. Bei einer einfachen Faktenfrage ist diese Tiefe oft unnötig. Bei einem Vergleich, einer Kaufentscheidung, einer lokalen Suche oder einer explorativen Recherche steckt dagegen schnell ein ganzes Intent-Cluster in einem einzigen Satz.
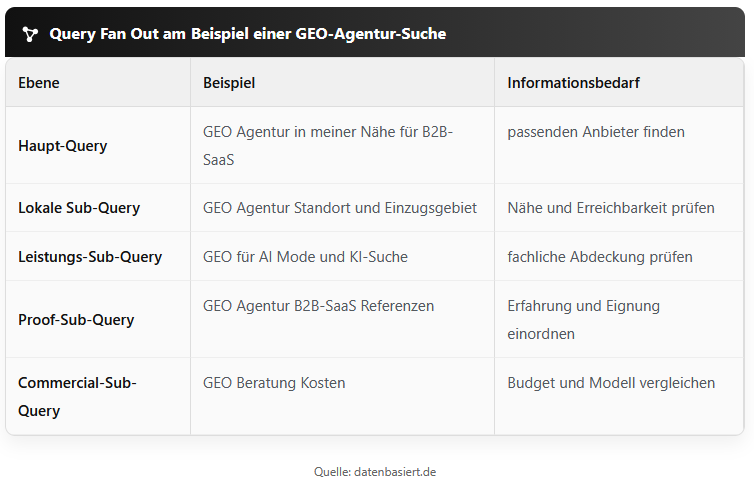
Nehmen wir eine Anfrage, die direkt aus dem GEO-Umfeld kommen könnte: „Welche Generative Engine Optimization Agentur in meiner Nähe passt zu einem B2B-SaaS-Unternehmen?“ Der Nutzer nennt nur eine Frage. Darin stecken aber mehrere Bedingungen, die ein Suchsystem getrennt untersuchen kann:
- Generative Engine Optimization Agentur in der Nähe
- GEO Agentur mit Erfahrung im B2B-SaaS
- Leistungen für AI Overviews, AI Mode und KI-Suche
- GEO Agentur Kosten und Abrechnungsmodelle
- Referenzen, Fallstudien und Erfahrungen zu GEO-Projekten
- technische SEO- und Content-Kompetenz der Agentur
Ein Teil dieser Sub-Queries ist lokal, ein anderer kommerziell, ein weiterer fachlich. Genau diese mehrdimensionale Nutzerintention macht Query Fan Out interessant. Das KI-System muss nicht nur herausfinden, welche Anbieter geografisch passen. Es muss Kontext, Zielgruppe, Leistungsumfang, Preis, Referenzen und technische Kompetenz als getrennte Suchabsichten verarbeiten. Aus einem Longtail-ähnlichen Prompt entsteht so ein semantisches Netzwerk aus Teilfragen, das weit über eine einzelne Keyword-Variante hinausgeht.
Sub-Queries sind keine bloßen Keyword-Varianten
Das ist die wichtigste Abgrenzung am Anfang. Eine Sub-Query kann wie ein Longtail-Keyword aussehen, ihr Zweck ist aber ein anderer. Sie entsteht aus der Zerlegung eines Informationsbedarfs und nicht aus klassischer Keyword-Recherche. Aus „GEO Agentur in meiner Nähe“ kann deshalb nicht nur eine geografische Query-Variante werden, sondern auch eine Teilanfrage nach Branchenkenntnis, Preis, technischer Umsetzung, AI Visibility, Quellenpräsenz oder messbaren Ergebnissen. Fan-Out-Queries bilden also nicht bloß Synonyme oder grammatikalische Varianten ab.
Damit verschiebt sich der Blick von einzelnen Suchbegriffen hin zu Beziehungen zwischen Entitäten, Eigenschaften, Intentionen und Kontext. Eine Agentur ist eine Entität. B2B-SaaS beschreibt den Unternehmenskontext. Nähe ist eine lokale Bedingung. Kosten sind eine kommerzielle Query-Dimension. AI Mode, AI Overviews, Retrieval, Citation und Quellenzitation gehören zur fachlichen Leistungsebene. Diese Entity-Beziehungen und Kontextsignale bilden die semantische Umgebung, in der das Suchsystem die Nutzerabsicht interpretiert.
Wie funktioniert Query Fan Out?
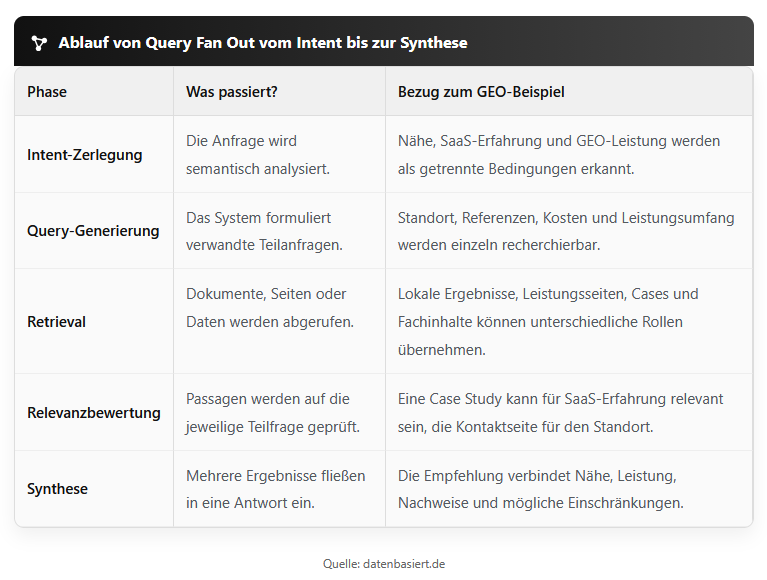
Im Hintergrund lässt sich Query Fan Out als mehrstufiger Retrieval-Prozess verstehen. Die genaue technische Umsetzung ist je nach KI-Suchsystem nicht vollständig öffentlich. Das Grundmuster ist trotzdem gut greifbar: semantische Analyse, Intent Decomposition, Query-Generierung, Parallel Retrieval, Relevanz-Ranking pro Sub-Query und Synthesis. Aus der Nutzeranfrage werden Synthetic Queries, aus Suchergebnissen werden Kandidaten und aus relevanten Textpassagen werden Antwortbausteine für die KI-Antwort.
Diese Phasen laufen nicht zwingend sauber nacheinander wie auf einem Fließband. Ein Sprachmodell kann neue Suchpfade erzeugen, wenn vorhandene Suchergebnisse eine Informationslücke zeigen, oder einzelne Retrieval-Pfade verwerfen, wenn sie wenig zur Antwort beitragen. Query Rewriting, Query Planning und zusätzliche Follow-up Queries können den Fan Out erweitern. Query Fan Out ist deshalb ein dynamischer Suchprozess und keine starre Liste vorab festgelegter Keywords.
Semantische Analyse und Intent Decomposition
Am Anfang steht die Interpretation der Nutzerfrage. Das Large Language Model beziehungsweise die Suchkomponente versucht, Kern-Intent, Sub-Intentionen und implizite Teilfragen zu erkennen. Natural Language Processing, semantische Suche, Entity-Erkennung und Kontextanalyse helfen dabei, Begriffe nicht isoliert zu lesen. Im GEO-Agentur-Beispiel muss das System verstehen, dass „in meiner Nähe“ einen lokalen Suchkontext herstellt, „B2B-SaaS“ eine Zielgruppe beschreibt und „passt“ nach Auswahlkriterien, Vergleich und Bewertung verlangt.
Die Anfrage wird damit nicht nur grammatikalisch zerlegt. Entscheidend sind semantische Beziehungen. Eine Entität kann geografisch passen und fachlich trotzdem irrelevant sein. Eine andere erfüllt den Search Intent beim Leistungsumfang, aber nicht beim Branchenkontext. Entity Mapping, Nutzerintention, Themenkontext und Einschränkungen beeinflussen deshalb, welche Unterfragen in der Query Decomposition entstehen und welche Suchpfade später genügend Relevanz besitzen.
Synthetic Queries und paralleles Retrieval
Die abgeleiteten Teilanfragen werden häufig als Synthetic Queries bezeichnet. Sie wurden nicht vom Nutzer eingegeben, sondern vom Modell synthetisiert. Das unterscheidet sie von sichtbaren Search-Console-Queries, klassischen Keywords und beobachtbaren Longtail-Suchanfragen. Welche Synthetic Queries entstehen, hängt vom Prompt, vom Kontextfenster, vom Modell, vom Suchmodus, vom Reasoning und von der jeweiligen Suchfunktion ab. Derselbe Intent kann deshalb unterschiedliche Fan-Out-Pfade erzeugen.
Ein System kann mehrere dieser Anfragen parallel gegen einen Suchindex, das Web oder andere Datenquellen schicken. Je nach Architektur kommen Wissensgraph, Datenbank, Vektorsuche, Embeddings, interne Speicher oder APIs infrage. Dieses Parallel Retrieval reduziert Latenz und erlaubt es, verschiedene Query-Dimensionen gleichzeitig zu untersuchen. Bei tiefer Recherche kann das Modell weitere Suchanfragen nachschieben, Ergebnisse neu bewerten und aus mehreren Retrieval-Runden zusätzliche Kandidaten sammeln.
- Die Hauptanfrage wird auf Kern-Intent, Entitäten und Bedingungen geprüft.
- Aus impliziten und expliziten Anforderungen entstehen Synthetic Queries.
- Mehrere Retrieval-Pfade suchen parallel nach passenden Dokumenten und Passagen.
- Die gefundenen Informationen werden pro Teilfrage bewertet und anschließend zusammengeführt.
Relevanz-Ranking auf Passage-Ebene
Bei klassischer SEO denken wir schnell in URLs, SERPs und Rankings. Bei einem Fan-Out-Prozess wird die Sache kleinteiliger. Eine URL kann für eine Sub-Query sehr relevant sein und für eine andere kaum etwas beitragen. Das Retrieval-System kann deshalb einzelne Textpassagen, Content-Fragmente, Abschnitte oder Chunks separat bewerten. Passage Retrieval, Chunk-Auswahl und Relevance Scoring bestimmen, welcher Antwortbaustein für welche Synthetic Query am besten passt.
Das verändert auch die Vorstellung von Sichtbarkeit. Ein organisches Ranking beschreibt die Position einer URL für eine beobachtbare Suchanfrage. Eine Quellenzitation in einer generativen Antwort beschreibt dagegen, dass eine Seite oder Passage für einen bestimmten Antwortkontext herangezogen wurde. Beides kann zusammenfallen, muss es aber nicht. Für eine Content-Auswertung solltest du Ranking, Citation, referenzierte URL und die tatsächlich beantwortete Teilfrage deshalb getrennt dokumentieren.
Das erklärt, warum ein langer Artikel nicht automatisch jede Teilfrage gut bedient. Thematische Breite ist nur dann nützlich, wenn die Antworttiefe pro Abschnitt stimmt. Ein Abschnitt über GEO-Kosten kann für eine kommerzielle Sub-Query präzise sein, während derselbe Artikel zu lokalen Auswahlkriterien keinen verwertbaren Antwortbaustein liefert. Umgekehrt kann eine schmale Leistungsseite für eine konkrete Intent-Query sehr treffsicher sein, obwohl sie für die allgemeine Definition von Generative Engine Optimization kaum Relevanz besitzt.
Für Content heißt das nicht, jeden Absatz künstlich zu einem Mini-Snippet zu machen. Es heißt eher: Eine wichtige Passage sollte auch dann verständlich bleiben, wenn sie aus ihrem direkten Umfeld herausgelöst wird. Verweise wie „wie oben erwähnt“ oder „das gilt auch hier“ sparen beim Schreiben ein paar Wörter, nehmen dem Absatz aber Kontext, sobald ein Retrieval-System genau diesen Ausschnitt betrachtet.
Vom Suchpfad zur Quellenzitation
Zwischen Synthetic Query und Citation liegen mehrere Auswahlstufen. Eine Query kann zunächst über Query Rewriting präzisiert und anschließend im Parallel Retrieval gegen Suchindex, Web und weitere Datenquellen gestellt werden. Das Retrieval liefert Kandidaten, aber noch keine fertige KI-Antwort. Erst Passage Retrieval und Relevanz-Ranking bestimmen, welche Textpassage oder welcher Chunk den Search Intent einer konkreten Sub-Query am besten erfüllt. Dabei können Entity-Bezug, semantische Nähe, Aktualität, Quellenqualität und Kontextsignale die Auswahl verändern.
Für eine zweite Sub-Query kann dieselbe URL bereits weniger relevant sein. Das Sprachmodell greift dann auf einen anderen Abschnitt, eine andere Zielseite oder eine andere Quelle zurück. Bei einem mehrstufigen Fan Out können zusätzliche Follow-up Queries entstehen, wenn der erste Retrieval-Pfad eine offene Teilfrage zeigt. Query Planning, Intent Decomposition und Query Decomposition greifen hier ineinander: Die Nutzeranfrage wird weiter zerlegt, neue Synthetic Queries erweitern den Suchraum und Parallel Retrieval beschafft zusätzliche Antwortbausteine.
Die spätere Synthesis verbindet diese Antwortbausteine. Grounding beziehungsweise Retrieval-Augmented Generation sorgt dafür, dass die generative Antwort auf abgerufene Informationen gestützt werden kann. Eine Citation verweist dabei auf eine unterstützende Webseite, nicht auf einen sichtbaren Beweis für die komplette interne Fan-Out-Struktur. Genau deshalb solltest du Quellenzitation, zitierte URL, beantwortete Sub-Query und Antwortkontext getrennt betrachten. Das gilt für AI Mode, AI Overviews und andere Formen von AI Search ebenso wie für ein eigenes GEO-Monitoring.
Grounding, RAG und Synthese
Query Fan Out wird oft zusammen mit Grounding und Retrieval-Augmented Generation, kurz RAG, genannt. Die Begriffe gehören in dieselbe Retrieval-Pipeline, meinen aber nicht dasselbe. Fan Out beschreibt die Auffächerung der Informationssuche. Grounding verankert die generative Antwort in abgerufenen, aktuellen Informationen. RAG verbindet Information Retrieval mit der anschließenden Antwortgenerierung. Query Fan Out kann dabei die Menge und Vielfalt der Retrieval-Anfragen vergrößern.
Nach dem Abruf folgt die Synthesis. Das Sprachmodell muss entscheiden, welche Passagen zusammenpassen, welche Quellenbelege redundant sind und ob sich Aussagen widersprechen. Relevanz, Aktualität, Faktentreue, Quellenqualität und Antwortkontext können dabei die Auswahl beeinflussen. Die KI-Antwort besteht deshalb nicht zwingend aus einer einzigen „Gewinnerseite“. Mehrere unterstützende Webseiten können unterschiedliche Sub-Queries abdecken und als Citations oder Quellenlinks in derselben generativen Antwort auftauchen.
Quelle: datenbasiert.de
Query Fan Out und verwandte Suchkonzepte
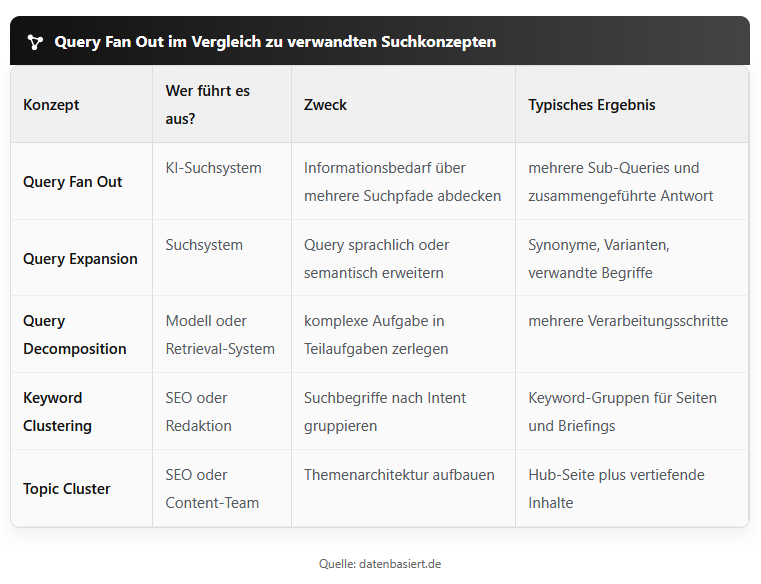
Rund um KI-Suche fliegen viele Begriffe durch denselben Raum. Manche sind eng verwandt, andere beschreiben ähnliche Muster aus einer anderen Perspektive. Query Expansion, Query Rewriting, Query Decomposition, Keyword Clustering, Intent-Cluster und Topic Cluster arbeiten alle mit Beziehungen zwischen Suchanfragen oder Themen. Sie unterscheiden sich aber darin, ob ein Suchsystem, ein Sprachmodell oder die Content-Planung die Struktur erzeugt.
Query Fan Out vs. Query Expansion
Query Expansion erweitert eine Suchanfrage typischerweise um verwandte Begriffe, Synonyme, Schreibweisen oder semantisch nahe Formulierungen. Das Suchsystem vergrößert damit den Suchraum, ohne zwangsläufig neue Sub-Intentionen zu erzeugen. Der ursprüngliche Search Intent bleibt häufig ähnlich. Query Rewriting kann die Formulierung zusätzlich normalisieren, präzisieren oder an den Suchindex anpassen.
Query Fan Out kann weiter gehen. Es erzeugt nicht nur semantische Varianten, sondern unterschiedliche Rechercheaufgaben. Aus der Haupt-Query werden Teilanfragen nach Standort, B2B-SaaS-Erfahrung, Cases, Preisen, technischem SEO und Content-Kompetenz. Diese Sub-Queries gehören zur gleichen Nutzersituation, können aber informationalen, lokalen, kommerziellen oder vergleichenden Intent haben. Genau diese mehrdimensionale Suche unterscheidet Fan Out von bloßer Expansion.
Query Fan Out vs. Query Decomposition
Query Decomposition ist der allgemeinere Gedanke, eine komplexe Aufgabe in kleinere Teilaufgaben zu zerlegen. Das begegnet dir in Natural Language Processing, Information Retrieval, Reasoning und agentischen Workflows. Query Fan Out nutzt dieselbe Grundidee, betont aber die Verzweigung in mehrere Such- beziehungsweise Retrieval-Pfade. Die Decomposition strukturiert die Aufgabe, der Fan Out beschafft über mehrere Queries die Informationen für die spätere Synthesis.
Die Begriffe können sich deshalb überschneiden. Nicht jede Query Decomposition ist automatisch ein Fan Out über Websuche oder Suchindex. Ein System kann eine Aufgabe intern zerlegen, rechnen, sortieren oder Zwischenschritte planen, ohne mehrere externe Suchanfragen auszuführen.
Keyword Clustering und Topic Cluster
Keyword Clustering ist eine SEO-Methode. Du gruppierst Keywords und Queries nach ähnlicher Suchintention, SERP-Überschneidung oder semantischer Nähe und entscheidest anschließend, welche Begriffe gemeinsam auf einer Zielseite behandelt werden. Topic Cluster sind dagegen eine Form der Content- und Informationsarchitektur. Eine Hub- oder Pillar-Seite verbindet vertiefende Unterseiten zu einem Themenkomplex und macht über interne Verlinkung semantische Beziehungen sichtbar.
Query Fan Out findet auf der Systemseite statt. Keyword Clustering und Topic Cluster sind redaktionelle beziehungsweise strategische Entscheidungen auf deiner Website. Das eine kann das andere informieren, aber es ist nicht dasselbe. Ein KI-System fragt dich schließlich nicht um Erlaubnis, bevor es aus einem Prompt fünf neue Suchpfade baut.
Longtail-Keywords, Suchintention und Fan-Out-Queries
Longtail-Keywords bleiben nützlich, weil sie spezifische Bedürfnisse und Nutzerintentionen sichtbar machen. Sie sind trotzdem nicht dasselbe wie modellgenerierte Fan-Out-Queries. Ein Longtail entsteht aus beobachtbarem Suchverhalten und kann Impressionen, Klicks oder Suchvolumen haben. Eine Synthetic Query entsteht modellintern und muss weder in Keyword-Datenbanken noch als einzelne Query in der Google Search Console erscheinen.
Für die Content-Recherche ist die Verbindung dennoch praktisch. Longtails, People-also-ask-Fragen, interne Suchanfragen, SERP-Muster und Search-Console-Queries zeigen, welche Unterfragen Menschen tatsächlich formulieren. Daraus kannst du plausible Sub-Queries, Intent-Gruppen und Themencluster ableiten. Das Ergebnis ist ein Content-Modell für mögliche Fan-Out-Szenarien, kein exakter Mitschnitt der internen Query-Generierung.
- Beobachtbare Suchanfragen zeigen reale Formulierungen und wiederkehrende Intents.
- Synthetic Queries zeigen mögliche interne Recherchepfade eines Modells.
- Keyword-Cluster helfen dir, ähnliche Nachfrage auf sinnvolle Zielseiten zu verteilen.
- Topic Cluster verbinden diese Zielseiten zu einer nachvollziehbaren Themenarchitektur.
- Interne Links machen Beziehungen zwischen Hauptthema und Vertiefungen explizit.
Quelle: datenbasiert.de
Query Fan Out in Google und anderen KI-Suchen
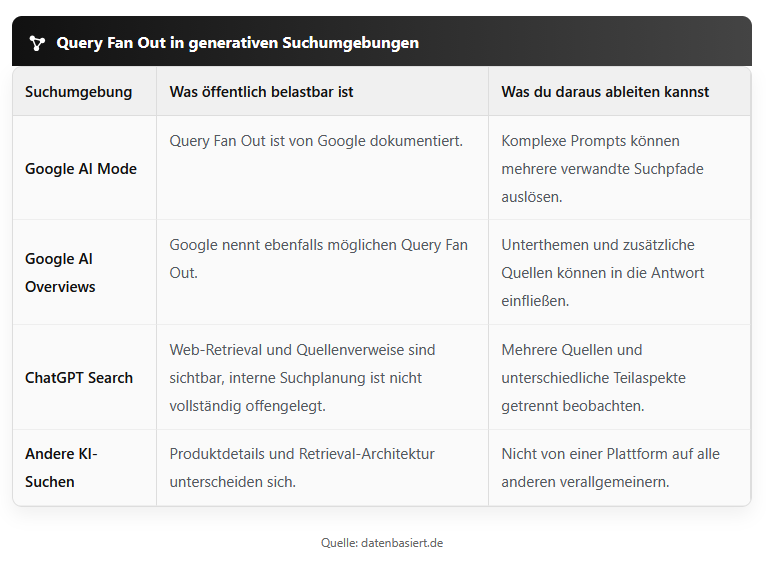
Bei Google ist Query Fan Out ausdrücklich dokumentiert. Für andere KI-Suchsysteme solltest du mit der Begriffswahl etwas vorsichtiger sein. Mehrstufiges Retrieval, Query Rewriting, Suchplanung, Deep Search und die Zerlegung komplexer Prompts sind auch dort relevante Muster, die internen Verfahren sind aber nicht überall öffentlich beschrieben. Ähnliche KI-Antworten, Citations und Quellenmuster bedeuten nicht automatisch identische Retrieval-Architekturen.
Google AI Mode und AI Overviews
Google nennt Query Fan Out sowohl im Zusammenhang mit AI Mode als auch mit AI Overviews. Dabei erzeugt das Modell mehrere gleichzeitig ausgeführte, verwandte Suchanfragen über Unterthemen und Datenquellen. Diese Fan-Out-Queries sollen zusätzliche relevante Suchergebnisse und unterstützende Webseiten abrufen. Das passt besonders zu komplexen Vergleichen, explorativen Fragen, Reasoning-Aufgaben und Nutzeranfragen mit mehreren Bedingungen.
Für Website-Betreiber ist ein anderer Punkt mindestens genauso wichtig: Google verlangt keine spezielle GEO-Datei, kein Query-Fan-Out-Markup und keine zusätzliche technische Anforderung nur für generative Suchfunktionen. Eine unterstützende Webseite muss indexiert und grundsätzlich snippetfähig sein. Crawling, Indexierung, Search Essentials, interne Verlinkung, sichtbarer Hauptcontent, hilfreiche Inhalte und strukturierte Daten, die zum sichtbaren Text passen, bleiben die technische und redaktionelle Basis.
Die 2026 veröffentlichte Google-Leitlinie für generative KI-Suche geht noch einen Schritt weiter: Bestehende SEO-Best-Practices bleiben die Grundlage für AI Overviews und AI Mode. Hilfreiche, zuverlässige, people-first Inhalte, einzigartige Informationen und passende Bild- oder Videoinhalte können die Sucherfahrung verbessern. Wer dagegen für jede denkbare Fan-Out-Query eine eigene, kaum unterscheidbare Zielseite erzeugt, riskiert skalierte Inhalte ohne Mehrwert. Hohe Seitenzahl ist keine Themenabdeckung und keine semantische Tiefe.
Wenn du bei diesen Grundlagen tiefer einsteigen willst, ist technisches SEO der passendere Hebel als irgendein exotisches KI-Markup. Ein Fan-Out-Prozess kann schließlich nur auf Inhalte zugreifen, die das jeweilige Retrieval-System überhaupt finden und verarbeiten kann.
ChatGPT Search, Perplexity und andere Systeme
Bei anderen KI-Suchen sieht der Nutzer ebenfalls häufig eine generative Antwort, die mehrere Aspekte einer Frage abdeckt und mehrere Quellen zusammenführt. Dahinter können Query Rewriting, Web Retrieval, RAG, Grounding, Query Planning, agentische Recherche oder weitere Reasoning-Schritte stehen. Welche Teilanfragen erzeugt werden, wie viele Retrieval-Runden stattfinden und wie Chunks, Passagen oder Quellen gerankt werden, kann sich je nach Modell, Suchmodus und Zeitpunkt ändern.
Deshalb würde ich nicht versuchen, einen universellen „Fan-Out-Algorithmus“ für alle Plattformen zu beschreiben. Praktischer ist die Beobachtungsebene: Welche Fragen stellt das System implizit mit? Welche Quellen erscheinen für einzelne Aspekte? Welche deiner Seiten werden zitiert? Und ändert sich das Muster, wenn du die gleiche Nutzersituation anders formulierst? Der Artikel zu SEO für ChatGPT geht auf diesen Retrieval-Blick für ChatGPT genauer ein.
Search Console und die unsichtbaren Sub-Queries
Ein häufiger Denkfehler ist, Fan-Out-Queries wie normale Search-Console-Queries behandeln zu wollen. Die intern generierten Synthetic Queries sind weiterhin nicht als vollständige Query-Liste sichtbar. Seit 2026 stellt die Google Search Console aber eigene Leistungsberichte für generative KI-Funktionen bereit. Du kannst dort Impressionen und Sichtbarkeit in AI Overviews und AI Mode besser auswerten, ohne damit den internen Fan-Out-Baum oder jede einzelne Teilanfrage zu sehen.
Damit wird die Analyse 2026 deutlich besser, aber nicht vollständig transparent. Klassische Queries, Impressionen, Klicks, Landingpages und SERP-Performance zeigen weiterhin die organische Suche. Der Generative-AI-Bericht ergänzt Sichtbarkeit in generativen Suchfunktionen. Für GEO-Monitoring kommen Prompt-Set, Quellenzitation, referenzierte URL, Antwortkontext und AI Visibility hinzu. Diese Datenebenen beschreiben unterschiedliche Teile derselben Search Journey.
- Search-Console-Queries zeigen sichtbare Nachfrage und Performance deiner Seiten.
- Prompt-Tests zeigen, welche Quellen in generativen Antworten tatsächlich auftauchen.
- Quellenlinks zeigen, welche URL für einen Teil der Antwort herangezogen wurde.
- Wiederholungsmessungen zeigen, wie stabil oder wechselhaft Quellenmuster sind.
Eine einzige Momentaufnahme sollte dabei nicht zur großen Theorie aufblasen. Generative Antworten variieren, Suchindizes verändern sich und Modelle werden aktualisiert. Wenn eine Seite heute für eine Teilfrage auftaucht und morgen nicht, ist das noch kein Beweis für eine bestimmte Rankingursache.
Quelle: datenbasiert.de
Content für Query Fan Out strukturieren
Die naheliegende Reaktion auf Query Fan Out wäre, für jede denkbare Teilanfrage eine neue Seite zu bauen. Genau das wäre meistens eine schlechte Idee. Fan-Out-Queries sind dynamisch, kontextabhängig und nicht vollständig vorhersehbar. Google warnt 2026 ausdrücklich davor, separate Inhalte für jede mögliche Query-Variante oder parallele Suchanfrage zu erzeugen, wenn der Hauptzweck darin liegt, Rankings oder generative KI-Antworten zu manipulieren. Das kann in Richtung Scaled Content Abuse laufen.
Die sinnvollere Content-Arbeit beginnt deshalb bei Themenabdeckung, Antworttiefe und Informationsarchitektur. Du versuchst nicht, jede Synthetic Query wortwörtlich zu treffen. Du baust stattdessen thematische Tiefe, semantische Breite, Entity-Clarity und klare Beziehungen zwischen Oberthema, Unterthemen und Suchintentionen auf. Das reduziert Thin Content und Keyword-Kannibalisierung, während einzelne Abschnitte trotzdem als präzise Antwortmodule funktionieren können.
Sub-Query Mapping für die Content-Recherche
Sub-Query Mapping ist keine Einsicht in den geheimen Maschinenraum. Es ist eine redaktionelle Annäherung an mögliche Fan-Out-Gaps. Du nimmst eine reale Nutzersituation als Haupt-Query, leitest potenzielle Unterfragen, Intent-Cluster und Query-Dimensionen ab und hältst sie gegen bestehende Seiten. So wird sichtbar, welche Themenabdeckung, Antworttiefe und Passage-Relevanz bereits vorhanden sind und wo Content-Lücken liegen.
Für die Ableitung solcher Teilfragen kannst du mehrere Signale zusammenbringen, ohne sie mit dem tatsächlichen internen Fan Out zu verwechseln. Search-Console-Queries zeigen Formulierungen, Impressionen und Klicks aus realem Suchverhalten. People Also Ask, Autocomplete, verwandte Suchanfragen und SERP-Features liefern Folgefragen und semantische Varianten. Bei generativen Antworten beobachtest du zusätzlich, welche Teilaspekte, Citations und Quellenlinks auftauchen. Daraus entsteht ein Intent- und Entity-Mapping für den Themenraum, kein Screenshot aus dem Modellkopf.
Interessant wird das Mapping dort, wo klassische Keyword-Recherche wenig sagt. Eine Query wie „GEO Agentur in meiner Nähe für B2B-SaaS“ kann überschaubares Suchvolumen haben und trotzdem mehrere geschäftlich relevante Sub-Intentionen öffnen. Der Fan-Out-Gap steckt dann vielleicht nicht beim Fokus-Keyword, sondern bei einer fehlenden Passage zu Audit-Ablauf, Kostenmodell, SaaS-Erfahrung oder Quellenmonitoring. Genau solche Lücken verschwinden in einem reinen Keyword-Export gern zwischen Suchvolumen, Ranking und Position.
Bei der Anfrage nach einer GEO-Agentur könnte die Hauptseite Leistungen und Positionierung erklären. Eine Case-Seite liefert B2B-SaaS-Erfahrung. Eine transparente Leistungsseite beantwortet Fragen zum Ablauf. Eine Standortseite deckt lokale Informationen ab. Ein Fachartikel erklärt die Methodik hinter Prompt-Monitoring oder AI Visibility. Nicht jede Teilfrage gehört in denselben Ratgeber, aber sie sollte im Themenraum auffindbar sein.
Quelle: datenbasiert.de
Das Mapping funktioniert auch für nicht-kommerzielle Themen. Bei „Query Fan Out“ selbst wären Definition, technische Funktionsweise, Abgrenzung zu Query Expansion, Bezug zu AI Mode und Content-Struktur typische Dimensionen. Genau deshalb steht dieser Artikel nicht aus 30 fast identischen Mini-Seiten zusammen.
Abschnitte als eigenständige Antworteinheiten
Ein guter Abschnitt beantwortet seine Überschrift früh. Danach kommen Kontext, Bedingungen, Entitäten und Beispiel. Das ist ein ziemlich guter Gegenentwurf zu SEO-Texten, die erst vier Absätze Anlauf nehmen, bevor sie irgendetwas sagen. Für Passage Retrieval und Chunk-Auswahl ist eine modulare Struktur ebenfalls hilfreich, weil ein Abschnitt semantisch klarer zu einer Sub-Query passt und als eigenständiger Antwortbaustein extrahiert werden kann.
Hier trifft Query Fan Out auf klassische On-Page-SEO. Überschriftenhierarchie, semantisches HTML, interne Links, klare Ankertexte, verständliche Absätze, Tabellen und strukturierte Daten sind keine neuen GEO-Erfindungen. Sie unterstützen Informationsarchitektur, Crawling und semantische Zuordnung. Bei generativen Antworten kommt hinzu, dass einzelne Passagen oder Chunks sichtbarer aus ihrem Seitenkontext herausgelöst und als Citations oder Antwortmodule verwendet werden können.
Deshalb lohnt sich Kontext im Absatz. Statt „Das kostet zwischen X und Y“ ist „Ein GEO-Audit für eine B2B-SaaS-Website kostet in diesem Beispiel zwischen X und Y, wenn Prompt-Analyse, technischer Check und Content-Audit enthalten sind“ als isolierte Aussage verständlicher. Entitäten, Bedingungen, Bezugsgröße und Search Intent bleiben erhalten. Diese Entity-Clarity erhöht die semantische Eindeutigkeit, ohne den Absatz mit Keywords vollzustopfen.
Eine Seite oder mehrere Unterseiten?
Die Entscheidung hängt nicht davon ab, ob du noch ein Keyword gefunden hast. Sie hängt daran, ob die Teilfrage ein eigenständiges Informationsbedürfnis trägt. „Was kostet GEO-Beratung?“ kann je nach Angebot ein eigener Inhalt sein. „Ist ein Kick-off remote möglich?“ gehört wahrscheinlich als kurzer Abschnitt auf eine Leistungsseite. Wer für jede Nebenfrage eine URL baut, bekommt schnell Thin Content, Überschneidungen und Kannibalisierung.
Bei der Entscheidung hilft mir eine einfache redaktionelle Prüfung. Hat die Teilfrage genug eigene Erklärungstiefe, unterscheidet sich ihre Suchintention klar vom Hauptthema und gibt es Material, das mehr trägt als eine umformulierte Definition? Eine separate URL sollte auch unabhängig vom Hauptartikel einen nachvollziehbaren Besuchsgrund haben. Wenn der Inhalt ohne künstliche Wiederholung nicht über zwei dünne Absätze hinauskommt, ist er meistens als Abschnitt besser aufgehoben.
Anders sieht es aus, wenn eine Teilfrage einen eigenen Rechercheweg öffnet. Ein Beitrag zu „GEO-KPIs“ kann Messgrößen, Zählregeln, Stichproben und Grenzen erklären. Ein kurzer Absatz zu KPIs auf einer allgemeinen GEO-Seite würde dafür kaum reichen. Umgekehrt braucht die Frage, ob ein Kick-off remote möglich ist, keinen eigenen Suchmaschinen-Lebensraum mit Title Tag, Meta Description und 900 Wörtern Begleittext. Das wäre keine thematische Tiefe, sondern Seitenvermehrung mit Krawatte.
Diese Trennung reduziert Kannibalisierung und hält die Informationsarchitektur verständlich. Eine starke Themenlandschaft braucht keine URL für jede synthetische Formulierung. Sie braucht passende Seiten für eigenständige Themen, belastbare Abschnitte für kleinere Teilfragen und genug semantische Tiefe, damit Beziehungen zwischen den Inhalten erkennbar bleiben.
Fan-Out-Gaps auf Abschnittsebene
Ein Fan-Out-Gap ist nicht automatisch eine fehlende URL. Oft fehlt nur der Antwortbaustein für eine bestimmte Sub-Query. Im Content-Audit vergleichst du deshalb Haupt-Query, mögliche Synthetic Queries, Search Intent und bestehende Passagen miteinander. Deckt ein Abschnitt den Intent bereits ab, aber nennt die entscheidende Entität oder Bedingung nicht, reicht häufig eine präzisere Textpassage. Fehlt dagegen ein komplettes Unterthema mit eigener Suchintention, kann eine neue Zielseite sinnvoll sein.
Diese Passage-Ebene verbindet Sub-Query Mapping mit Topic Clustern. Die Pillar-Seite deckt das Kernthema ab, Unterseiten tragen eigenständige Intent-Cluster und interne Links verbinden die Informationsarchitektur. So entstehen mehrere relevante Retrieval-Pfade, ohne für jede Query-Variante Thin Content zu produzieren.
Interne Verlinkung und Themenarchitektur
Interne Links verbinden die Informationsarchitektur. Eine Hub-Seite kann ein Oberthema erklären und auf vertiefende Seiten zu Technik, Content, Messung oder Plattformen führen. Damit entsteht kein exaktes Abbild eines Fan-Out-Baums, aber ein nachvollziehbarer Themenraum mit klaren Beziehungen.
Für die Planung hilft eine SEO-Strategie, die Suchintentionen, Zielseiten und Content-Lücken gemeinsam betrachtet. So landet eine neue Sub-Query nicht automatisch als zusätzliche URL im Redaktionsplan. Manchmal fehlt nur ein Absatz. Manchmal ist eine bestehende Seite zu breit. Und manchmal zeigt die Recherche tatsächlich ein Thema, das eine eigene Vertiefung verdient.
Semantische Abdeckung ohne Keyword-Stapeln
Semantische Breite entsteht nicht dadurch, dass du Query Fan Out, Sub-Query, Synthetic Query und KI-Suche in jeden zweiten Satz schreibst. Sie entsteht, wenn die fachlich relevanten Entitäten und Beziehungen dort auftauchen, wo sie einen Zusammenhang erklären. Zu diesem Thema gehören Suchintention, Search Intent, Retrieval, Suchindex, Web-Retrieval, Grounding, RAG, Entity-Erkennung, Query Decomposition, Query Expansion, Query Rewriting, Intent Decomposition, Parallel Retrieval, Relevanz-Ranking, Passage Retrieval, Quellenzitation, Citation, AI Mode, AI Overviews, Prompt, Topic Cluster, Keyword Clustering und interne Verlinkung.
Ebenso wichtig sind konkrete Beziehungen zwischen diesen Begriffen. Ein Suchindex ist keine Citation. Eine Quellenzitation ist kein organisches Ranking. Eine Sub-Query ist kein Keyword-Cluster. Ein Intent-Cluster ist keine Fan-Out-Struktur. Ein Topic Cluster ist kein interner Retrieval-Baum. Ein Chunk ist keine ganze Zielseite. Wenn der Text diese Unterschiede sauber erklärt, entsteht semantische Klarheit fast automatisch. Eine bloße Fachworttapete wäre dagegen nur Keyword-Stapeln mit technischem Anstrich.
Strukturierte Daten können sichtbare Inhalte maschinenlesbar beschreiben, sofern Schema-Markup zum Seitentyp passt und mit dem sichtbaren Text übereinstimmt. Für Query Fan Out gibt es aber kein spezielles Schema.org-Markup. Auch eine Sonderdatei ist für Google Search nicht erforderlich. Wichtiger bleiben crawlbare Links, indexierbarer Hauptcontent, klare Informationsarchitektur, semantisches HTML und Abschnitte, die einen konkreten Search Intent tatsächlich beantworten.
- Beantworte die Hauptfrage früh und vertiefe danach die relevanten Teilfragen.
- Nutze Überschriften für echte Informationsunterschiede, nicht für Keyword-Varianten.
- Halte Entitäten, Bedingungen, Zahlen und Bezugsgrößen im jeweiligen Absatz verständlich.
- Verteile eigenständige Intents auf passende Seiten und verbinde sie intern.
- Nutze Tabellen, wenn Kriterien verglichen werden, und Listen, wenn Elemente wirklich gleichrangig sind.
- Erstelle keine Seitenserie nur deshalb, weil ein Modell theoretisch viele Synthetic Queries erzeugen könnte.
Quelle: datenbasiert.de
Fazit
Query Fan Out beschreibt eine Suchlogik, bei der aus einer komplexen Nutzerfrage mehrere verwandte Suchpfade entstehen. Das KI-Suchsystem zerlegt Kern-Intent und Sub-Intentionen, erzeugt Synthetic Queries, führt Parallel Retrieval aus, bewertet Passagen pro Sub-Query und synthetisiert die Ergebnisse zu einer generativen Antwort. Bei Google ist dieser Mechanismus für AI Mode und AI Overviews dokumentiert.
Für SEO und GEO brauchst du keine eigene Seite für jede theoretische Fan-Out-Query und kein spezielles Markup. Du brauchst crawlbare, indexierbare Inhalte mit Themenabdeckung, Antworttiefe, Entity-Clarity und nachvollziehbarer Informationsarchitektur. Wenn eine komplexe Anfrage sechs Query-Dimensionen öffnet, muss nicht eine URL alle sechs perfekt bedienen. Dein Topic Cluster sollte für die relevanten Suchintentionen aber präzise Antwortpassagen und passende Zielseiten bereithalten.
Das Beispiel „Generative Engine Optimization Agentur in meiner Nähe für B2B-SaaS“ zeigt den Kern ganz gut. Die sichtbare Query bündelt lokale Suche, Branchenkontext, Leistungsumfang, Kosten, Referenzen und technische Kompetenz. Query Fan Out macht aus diesen impliziten Anforderungen eigenständige Recherchepfade. Gute Content-Planung hatte im Grunde schon immer dieselbe Aufgabe: nicht Wörter sammeln, sondern Informationsbedürfnisse und ihre Beziehungen verstehen.
Quelle: datenbasiert.de


